
【Spark】Spark-shell案例——单词计数统计
步骤
一、准备本地文件以作测试
在第一台机器执行
mkdir -p /export/servers/sparkdatas

cd /export/servers/sparkdatas/

vim wordcount.txt
hello me

hello you

hello her
二、通过 --master启动本地模式
cd /export/servers/spark-2.2.0-bin-2.6.0-cdh5.14.0/

bin/spark-shell --master local[2]
三、开发scala单词统计代码
有两种写法(tab可以补全或者提示)
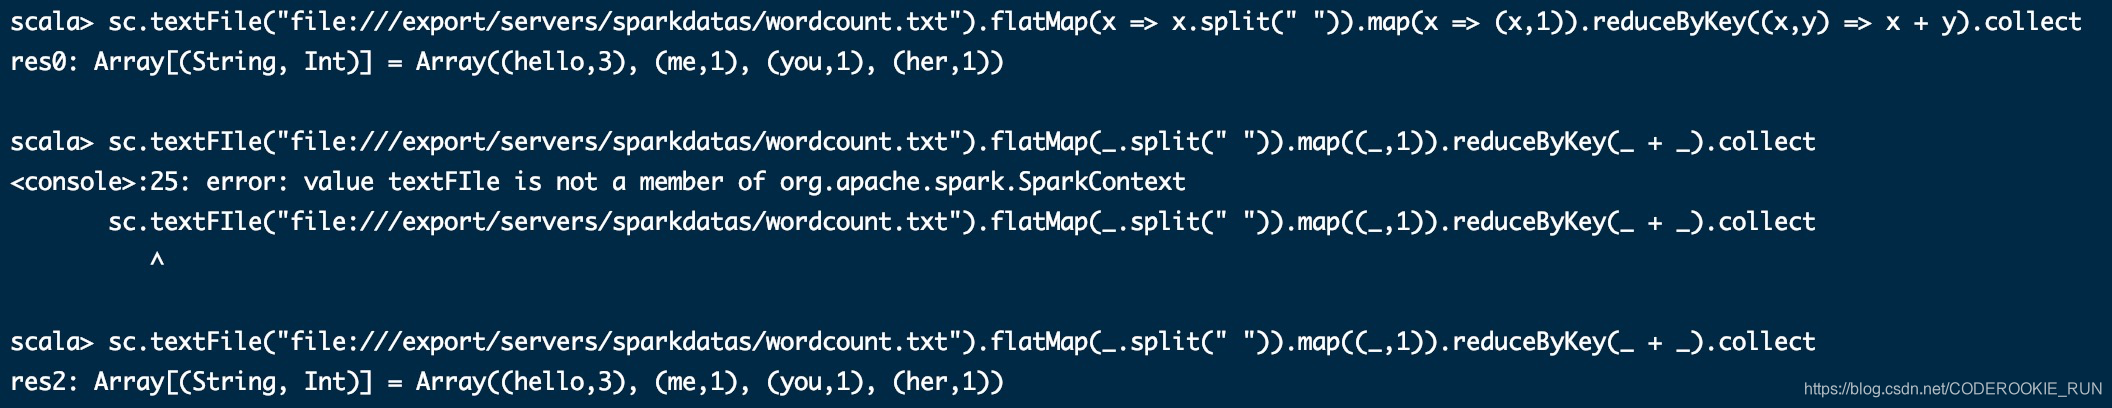
sc.textFile("file:///export/servers/sparkdatas/wordcount.txt").flatMap(x => x.split(" ")).map(x => (x,1)).reduceByKey((x,y) => x + y).collect
sc.textFile("file:///export/servers/sparkdatas/wordcount.txt").flatMap(_.split(" ")).map((_,1)).reduceByKey(_ + _).collect
代码说明:
sc:Spark-Shell中已经默认将SparkContext类初始化为对象sc。用户代码如果需要用到,则直接应用sc即可。
textFile:读取数据文件
flatMap:对文件中的每一行数据进行压平切分,这里按照空格分隔。
map:对出现的每一个单词记为1(word,1)
reduceByKey:对相同的单词出现的次数进行累加
collect:触发任务执行,收集结果数据。
【Spark】Spark-shell案例——单词计数统计的更多相关文章
- shell 文本单词计数
words.txt中的内容如下: the day is sunny the the the sunny is is 统计每个单词出现的次数,并降序输出. Unix Pipes脚本如下: cat wor ...
- Spark本地环境实现wordCount单词计数
注:图片如果损坏,点击文章链接:https://www.toutiao.com/i6814778610788860424/ 编写类似MapReduce的案例-单词统计WordCount 要统计的文件为 ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
- [Spark内核] 第36课:TaskScheduler内幕天机解密:Spark shell案例运行日志详解、TaskScheduler和SchedulerBackend、FIFO与FAIR、Task运行时本地性算法详解等
本課主題 通过 Spark-shell 窥探程序运行时的状况 TaskScheduler 与 SchedulerBackend 之间的关系 FIFO 与 FAIR 两种调度模式彻底解密 Task 数据 ...
- Spark: 单词计数(Word Count)的MapReduce实现(Java/Python)
1 导引 我们在博客<Hadoop: 单词计数(Word Count)的MapReduce实现 >中学习了如何用Hadoop-MapReduce实现单词计数,现在我们来看如何用Spark来 ...
- Spark Streaming updateStateByKey案例实战和内幕源码解密
本节课程主要分二个部分: 一.Spark Streaming updateStateByKey案例实战二.Spark Streaming updateStateByKey源码解密 第一部分: upda ...
- hadoop笔记之MapReduce的应用案例(WordCount单词计数)
MapReduce的应用案例(WordCount单词计数) MapReduce的应用案例(WordCount单词计数) 1. WordCount单词计数 作用: 计算文件中出现每个单词的频数 输入结果 ...
- 分布式计算框架-Spark(spark环境搭建、生态环境、运行架构)
Spark涉及的几个概念:RDD:Resilient Distributed Dataset(弹性分布数据集).DAG:Direct Acyclic Graph(有向无环图).SparkContext ...
- java实现文件单词频率统计 topN top K
java 实现单词计数.top N 思路 先统计每个单词出现的个数 利用 TreeSet 的自动排序的功能 上代码 wordcount public void wordCount() { String ...
随机推荐
- ES5与ES6 this 指向详细解析(箭头函数)
首先要明白箭头函数的作用: 箭头函数除了让函数的书写变得很简洁,可读性很好外:最大的优点是解决了this执行环境所造成的一些问题.比如:解决了匿名函数this指向的问题(匿名函数的执行环境具有全局性) ...
- python的pip怎样更新包 + pip的help翻译
1.pip下载安装 pip下载 进入https://pypi.python.org/pypi/pip,下载 .tar.gz压缩包 Linux安装pip # tar -xzvf pip-1.5.4.ta ...
- stand up meeting 1/8/2016 & weekend 1/9/2016~1/10/2016 && sprint2扫尾
part 组员 工作 工作耗时/h 明日计划 工作耗时/h UI 冯晓云 跑通打印机功能,尝试与pdf读取部分结合 6 查漏补缺, ...
- [安全] Kali Linux安装TheFatRat
一.解决访问国外网络的问题 由于字符敏感,以下所有vray的第二位都需要加上"2". 1.使用vray客户端 前提条件:拥有一个海外vray服务器提供socks5代理. 1)下载v ...
- python3+selenium3自动化1——元素定位
1.selenium的webdriver提供了八种基本的元素定位方法 打开浏览器 driver = webdriver.Chrome() driver.get('https://www.baidu.c ...
- 2020/4/26 大数据的zookeeper分布式安装
大数据的zookeeper分布式安装 **** 前面的文章已经提到Hadoop的伪分布式安装.现在就在原有的基础上安装zookeeper. 首先启动Hadoop平台 [root@master ~]# ...
- Scala学习系列(三)——入门与基础
本课程源码共享于 https://github.com/tree1123/learning-scala 首先,打开IDEA编辑器的SbtExampleProject项目,我们将在这个项目下进行练习 本 ...
- pytorch torchversion自带的数据集
from torchvision.datasets import MNIST # import torchvision # torchvision.datasets. #准备数据集 mnist = M ...
- Java 多线程--ThreadLocal Timer ExecutorService
ThreadLocal /** * ThreadLocal:每个线程自身的存储本地.局部区域 * @author xzlf * */ public class ThreadLocalTest01 { ...
- android位运算简单讲解
一.前言 在查看源码中,经常会看到很多这样的符号“&”.“|”.“-”,咋一看挺高大上:仔细一看,有点懵:再看看,其实就是大学学过的再普通不过的与.或.非.今天小盆友就以简单的形式分享下,同时 ...