
java爬虫系列第三讲-获取页面中绝对路径的各种方法
在使用webmgiac的过程中,很多时候我们需要抓取连接的绝对路径,总结了几种方法,示例代码放在最后。
以和讯网的一个页面为例:
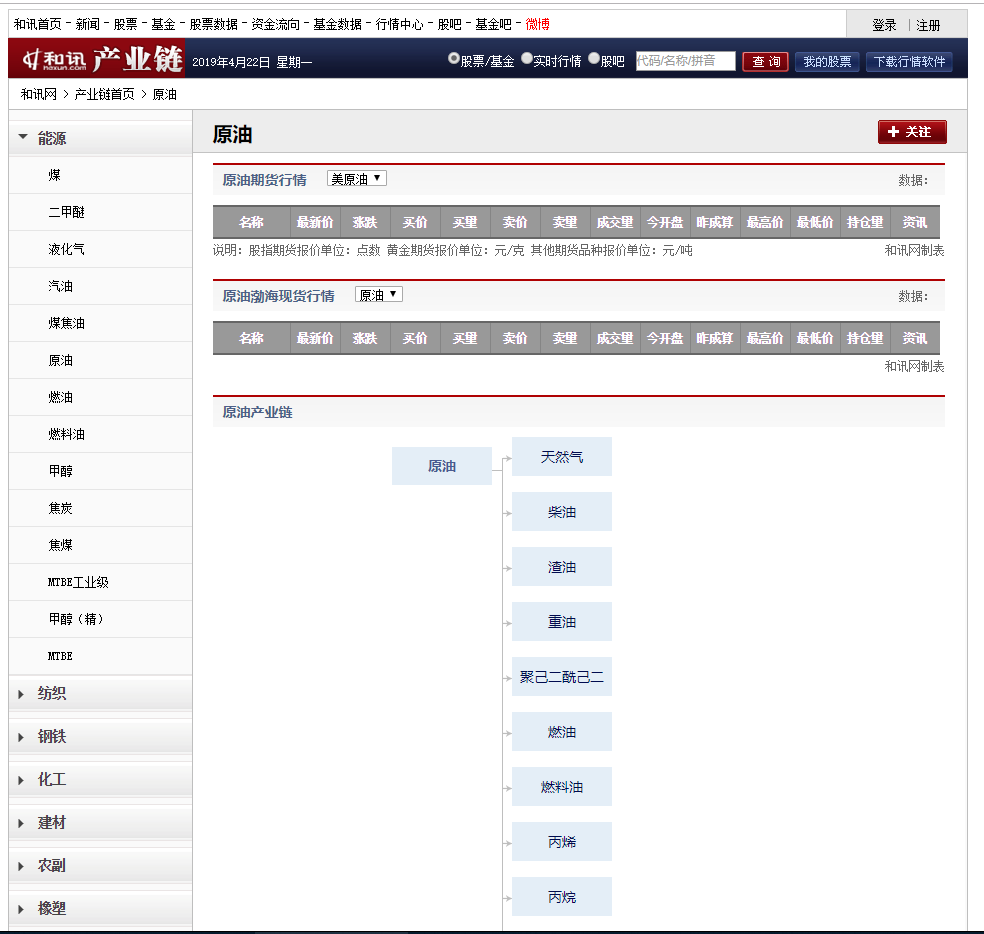
xpath方式获取
log.info("{}", page.getHtml().xpath("//div[@id='cyldata']").links().all());

log.info("{}", page.getHtml().xpath("//div[@id='cyldata']//a//@abs:href").all());
xpath+css选择器方式获取
log.info("{}", page.getHtml().xpath("//div[@id='cyldata']").css("a", "abs:href").all());
css选择器方式获取
log.info("{}", page.getHtml().css("div[id='cyldata']").css("a", "abs:href").all());

log.info("{}", page.getHtml().css("div[id='cyldata']").links().all());

log.info("{}", page.getHtml().css("div[id='cyldata'] a").links().all());

log.info("{}", page.getHtml().css("div[id='cyldata'] a", "abs:href").all());
jsoup方式获取
for (Element element : Jsoup.parse(page.getRawText(), page.getRequest().getUrl()).select("#cyldata a")) {

    log.info("{}", element.attr("abs:href"));

    log.info("{}", element.absUrl("href"));

}
jsoup中stringutil工具类方式获取
for (Element element : Jsoup.parse(page.getRawText(), page.getRequest().getUrl()).select("#cyldata a")) {

    log.info("{}", StringUtil.resolve(page.getRequest().getUrl(), element.attr("href")));

}
示例代码
<?xml version="1.0" encoding="UTF-8"?>

<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

    <modelVersion>4.0.0</modelVersion>

    <parent>

        <groupId>org.springframework.boot</groupId>

        <artifactId>spring-boot-starter-parent</artifactId>

        <version>2.1.4.RELEASE</version>

        <relativePath/> <!-- lookup parent from repository -->

    </parent>

    <groupId>com.ady01</groupId>

    <artifactId>java-pachong</artifactId>

    <version>0.0.1-SNAPSHOT</version>

    <name>java-pachong</name>

    <description>java爬虫项目</description>

    <properties>

        <java.version>1.8</java.version>

    </properties>

    <dependencies>

        <dependency>

            <groupId>org.springframework.boot</groupId>

            <artifactId>spring-boot-starter</artifactId>

        </dependency>

        <dependency>

            <groupId>org.projectlombok</groupId>

            <artifactId>lombok</artifactId>

            <optional>true</optional>

        </dependency>

        <dependency>

            <groupId>org.springframework.boot</groupId>

            <artifactId>spring-boot-starter-test</artifactId>

            <scope>test</scope>

        </dependency>

        <!-- webmagic start -->

        <dependency>

            <groupId>us.codecraft</groupId>

            <artifactId>webmagic-core</artifactId>

            <version>0.7.3</version>

            <exclusions>

                <exclusion>

                    <artifactId>fastjson</artifactId>

                    <groupId>com.alibaba</groupId>

                </exclusion>

                <exclusion>

                    <artifactId>commons-io</artifactId>

                    <groupId>commons-io</groupId>

                </exclusion>

                <exclusion>

                    <artifactId>commons-io</artifactId>

                    <groupId>commons-io</groupId>

                </exclusion>

                <exclusion>

                    <artifactId>fastjson</artifactId>

                    <groupId>com.alibaba</groupId>

                </exclusion>

                <exclusion>

                    <artifactId>fastjson</artifactId>

                    <groupId>com.alibaba</groupId>

                </exclusion>

                <exclusion>

                    <artifactId>log4j</artifactId>

                    <groupId>log4j</groupId>

                </exclusion>

                <exclusion>

                    <artifactId>slf4j-log4j12</artifactId>

                    <groupId>org.slf4j</groupId>

                </exclusion>

            </exclusions>

        </dependency>

        <dependency>

            <groupId>us.codecraft</groupId>

            <artifactId>webmagic-extension</artifactId>

            <version>0.7.3</version>

        </dependency>

        <dependency>

            <groupId>us.codecraft</groupId>

            <artifactId>webmagic-selenium</artifactId>

            <version>0.7.3</version>

        </dependency>

        <dependency>

            <groupId>net.minidev</groupId>

            <artifactId>json-smart</artifactId>

            <version>2.2.1</version>

        </dependency>

        <!-- webmagic end -->

        <dependency>

            <groupId>com.alibaba</groupId>

            <artifactId>fastjson</artifactId>

            <version>1.2.49</version>

        </dependency>

        <dependency>

            <groupId>commons-lang</groupId>

            <artifactId>commons-lang</artifactId>

            <version>2.6</version>

        </dependency>

        <dependency>

            <groupId>commons-io</groupId>

            <artifactId>commons-io</artifactId>

            <version>2.6</version>

        </dependency>

        <dependency>

            <groupId>commons-codec</groupId>

            <artifactId>commons-codec</artifactId>

            <version>1.11</version>

        </dependency>

        <dependency>

            <groupId>commons-collections</groupId>

            <artifactId>commons-collections</artifactId>

            <version>3.2.2</version>

        </dependency>

    </dependencies>

    <build>

        <plugins>

            <plugin>

                <groupId>org.springframework.boot</groupId>

                <artifactId>spring-boot-maven-plugin</artifactId>

            </plugin>

        </plugins>

    </build>

</project>
package com.ady01.demo3;

import lombok.extern.slf4j.Slf4j;

import org.jsoup.Jsoup;

import org.jsoup.helper.StringUtil;

import org.jsoup.nodes.Element;

import us.codecraft.webmagic.Page;

import us.codecraft.webmagic.Request;

import us.codecraft.webmagic.Site;

import us.codecraft.webmagic.Spider;

import us.codecraft.webmagic.processor.PageProcessor;

/**

 * <b>description</b>:webmagic中获取绝对路径 <br>

 * <b>time</b>:2019/4/22 10:42 <br>

 * <b>author</b>:微信公众号:路人甲Java,专注于java技术分享(带你玩转 爬虫、分布式事务、异步消息服务、任务调度、分库分表、大数据等),喜欢请关注!

 */

@Slf4j

public class AbsHrefPageProcessor implements PageProcessor {

    Site site = Site.me().setSleepTime(1000);

    @Override

    public void process(Page page) {

        //获取超链接绝对路径的方式

        log.info("----------------------xpath方式获取------------------------");

        //xpath方式获取

        log.info("{}", page.getHtml().xpath("//div[@id='cyldata']").links().all());

        log.info("{}", page.getHtml().xpath("//div[@id='cyldata']//a//@abs:href").all());

        //xpath+css选择器方式获取

        log.info("----------------------xpath+css选择器方式获取------------------------");

        log.info("{}", page.getHtml().xpath("//div[@id='cyldata']").css("a", "abs:href").all());

        //css选择器方式获取

        log.info("----------------------css选择器方式获取------------------------");

        log.info("{}", page.getHtml().css("div[id='cyldata']").css("a", "abs:href").all());

        log.info("{}", page.getHtml().css("div[id='cyldata']").links().all());

        log.info("{}", page.getHtml().css("div[id='cyldata'] a").links().all());

        log.info("{}", page.getHtml().css("div[id='cyldata'] a", "abs:href").all());

        //jsoup方式获取

        log.info("----------------------jsoup方式获取------------------------");

        for (Element element : Jsoup.parse(page.getRawText(), page.getRequest().getUrl()).select("#cyldata a")) {

            log.info("{}", element.attr("abs:href"));

            log.info("{}", element.absUrl("href"));

        }

        //jsoup中stringutil工具类方式获取

        log.info("----------------------jsoup中stringutil工具类方式获取------------------------");

        for (Element element : Jsoup.parse(page.getRawText(), page.getRequest().getUrl()).select("#cyldata a")) {

            log.info("{}", StringUtil.resolve(page.getRequest().getUrl(), element.attr("href")));

        }

    }

    @Override

    public Site getSite() {

        return site;

    }

    public static void main(String[] args) {

        Request request = new Request("http://industry.hexun.com/c193_59.shtml");

        Spider.create(new AbsHrefPageProcessor()).addRequest(request).run();

    }

}
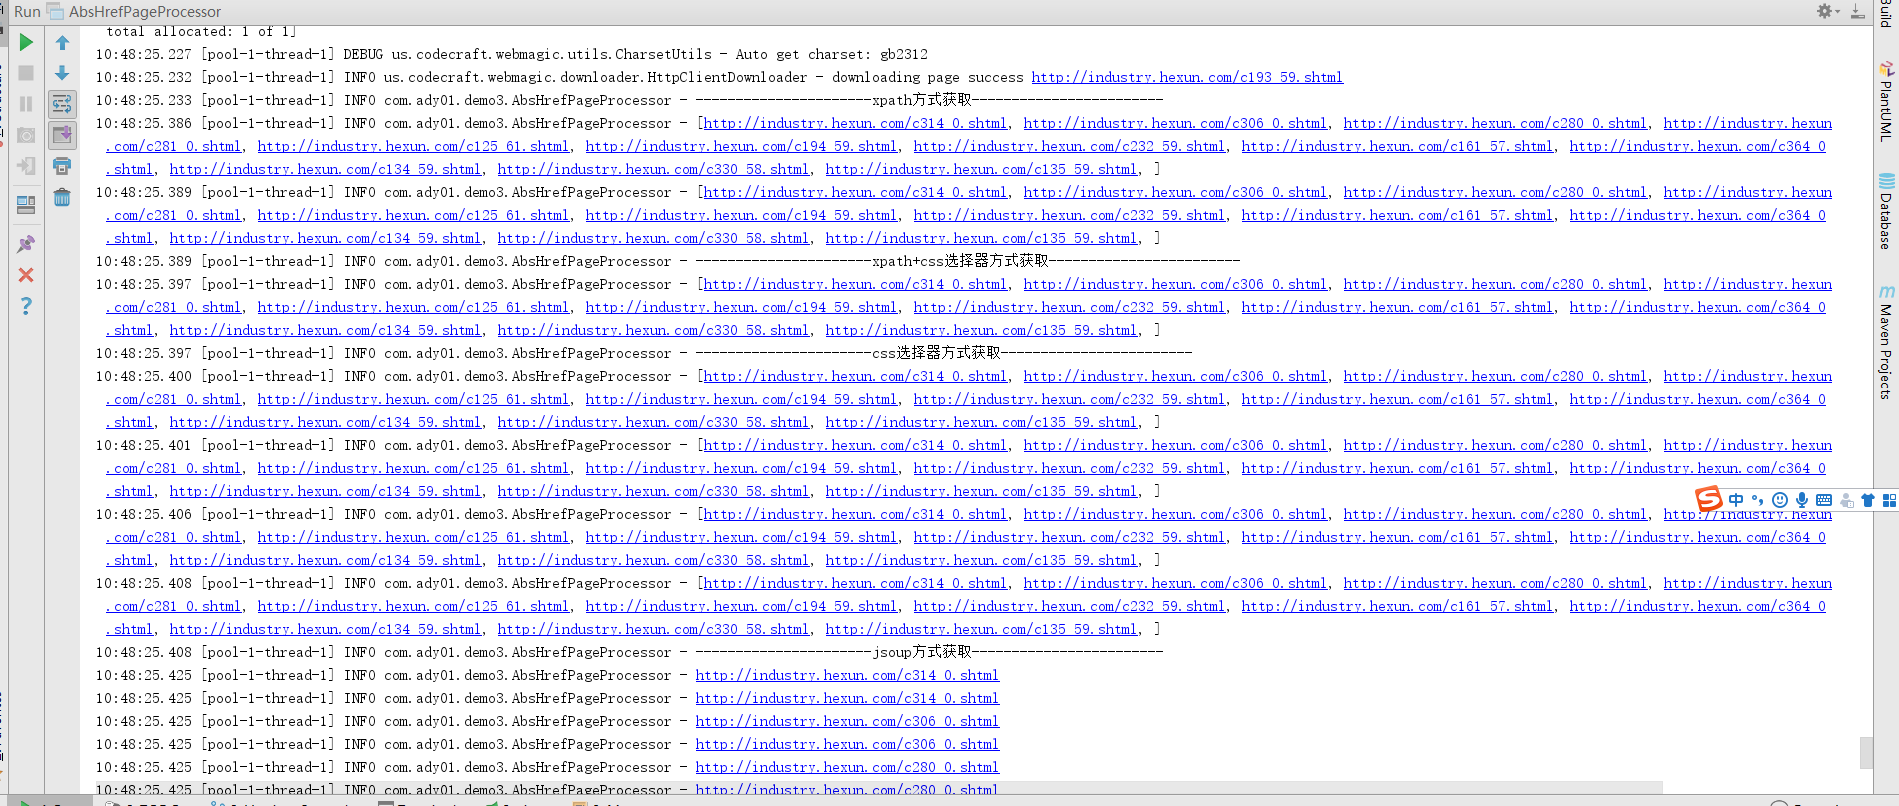
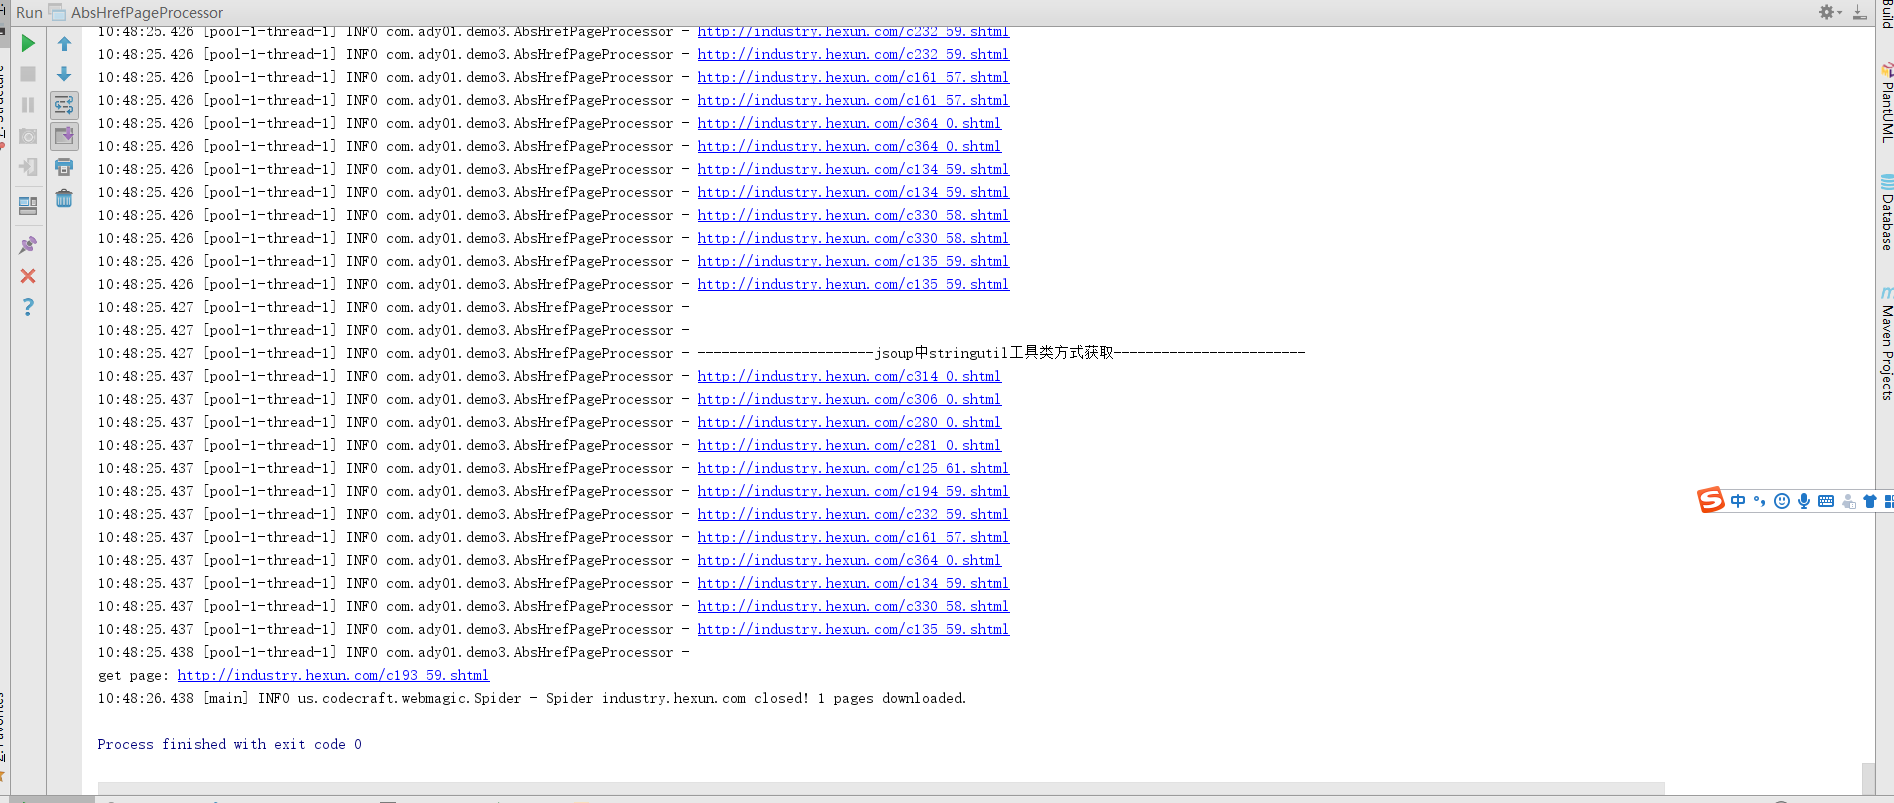
执行结果:
java爬虫系列第三讲-获取页面中绝对路径的各种方法的更多相关文章
- java爬虫系列目录
1. java爬虫系列第一讲-爬虫入门(爬取动作片列表) 2. java爬虫系列第二讲-爬取最新动作电影<海王>迅雷下载地址 3. java爬虫系列第三讲-获取页面中绝对路径的各种方法 4 ...
- Java爬虫系列二:使用HttpClient抓取页面HTML
爬虫要想爬取需要的信息,首先第一步就要抓取到页面html内容,然后对html进行分析,获取想要的内容.上一篇随笔<Java爬虫系列一:写在开始前>中提到了HttpClient可以抓取页面内 ...
- java爬虫系列第二讲-爬取最新动作电影《海王》迅雷下载地址
1. 目标 使用webmagic爬取动作电影列表信息 爬取电影<海王>详细信息[电影名称.电影迅雷下载地址列表] 2. 爬取最新动作片列表 获取电影列表页面数据来源地址 访问http:// ...
- Java爬虫系列之实战:爬取酷狗音乐网 TOP500 的歌曲(附源码)
在前面分享的两篇随笔中分别介绍了HttpClient和Jsoup以及简单的代码案例: Java爬虫系列二:使用HttpClient抓取页面HTML Java爬虫系列三:使用Jsoup解析HTML 今天 ...
- Java爬虫系列三:使用Jsoup解析HTML
在上一篇随笔<Java爬虫系列二:使用HttpClient抓取页面HTML>中介绍了怎么使用HttpClient进行爬虫的第一步--抓取页面html,今天接着来看下爬虫的第二步--解析抓取 ...
- java爬虫系列第一讲-爬虫入门
1. 概述 java爬虫系列包含哪些内容? java爬虫框架webmgic入门 使用webmgic爬取 http://ady01.com 中的电影资源(动作电影列表页.电影下载地址等信息) 使用web ...
- js获取页面中图片的总数
查看效果:http://keleyi.com/keleyi/phtml/image/9.htm 下面是完整代码: <html><body><div id="ke ...
- jQuery基础学习5——JavaScript方法获取页面中的元素
给网页中的所有<p>元素添加onclick事件 <!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN& ...
- 获取页面中任意一个元素距离body的偏移量
//offSet:等同于jQuery中的offSet方法,获取页面中任意一个元素距离body的偏移量function offSet(curEle) { var totalLeft = null; va ...
随机推荐
- Redis+Restful 构造序列号和压力测试【后续】
大家还记上篇博文https://www.cnblogs.com/itshare/p/8643508.html,测试redis构造流水号的tps是600多/1s. 这个速度显然不能体现redis 集群在 ...
- JVM学习记录-类加载的过程
类的整个生命周期的7个阶段是:加载(Loading).验证(Verification).准备(Preparation).解析(Resolution).初始化(Initialization).使用(Us ...
- Django设置查看原生SQL语句
LOGGING = { 'version': 1, 'disable_existing_loggers': False, 'handlers': { 'console':{ 'level':'DEBU ...
- java爬虫,爬取当当网数据
背景:女票快毕业了(没错!我是有女票的!!!),写论文,主题是儿童性教育,查看儿童性教育绘本数据死活找不到,没办法,就去当当网查询下数据,但是数据怎么弄下来呢,首先想到用Python,但是不会!!百 ...
- 微服务架构 - SpringCloud整合分布式服务跟踪zipkin
1.zipkin zipkin是Twitter的一个开源项目,它基于Google Dapper实现.我们可以使用它来收集各个服务器上请求链路的跟踪数据,并通过它提供的REST API接口来辅助我们查询 ...
- Python爬虫入门教程 56-100 python爬虫高级技术之验证码篇2-开放平台OCR技术
今日的验证码之旅 今天你要学习的验证码采用通过第三方AI平台开放的OCR接口实现,OCR文字识别技术目前已经比较成熟了,而且第三方比较多,今天采用的是百度的. 注册百度AI平台 官方网址:http:/ ...
- VS2017中使用组合项目_windows服务+winform管理_项目发布_测试服务器部署
前言:作为一名C#开发人员,避免不了常和windows服务以及winform项目打交道,本人公司对服务的管理也是用到了这2个项目的组合方式进行:因为服务项目是无法直接安装到计算器中,需要使用命令借助微 ...
- CentOS_关机与重启命令详解
Linux centos关机与重启命令详解 Linux centos重启命令: 1.reboot 2.shutdown -r now 立刻重启(root用户使用) 3.shutdown -r 10 过 ...
- python进程、进程池(二)代码部分
第一种创建进程的方式: from multiprocessing import Process def f(name): print(name,"在子进程") if __name_ ...
- Install Windows 2016 on VirtualBox
Download ISO file for Windows 2016 (180 days free). https://www.microsoft.com/en-us/evalcenter/eval ...