
[Kaggle] dogs-vs-cats之模型训练
上一步建立好模型之后,现在就可以训练模型了。
主要代码如下:
import sys

#将当期路径加入系统path中

sys.path.append("E:\\CODE\\Anaconda\\tensorflow\\Kaggle\\My-TensorFlow-tutorials-master\\01 cats vs dogs\\")

import os

import numpy as np

import tensorflow as tf

import input_data

import model

#%%

N_CLASSES = 2 #类别数

IMG_W = 208  # resize the image, if the input image is too large, training will be very slow.

IMG_H = 208

BATCH_SIZE = 16

CAPACITY = 2000 #队列中元素个数

MAX_STEP = 10000 #最大迭代次数 with current parameters, it is suggested to use MAX_STEP>10k

learning_rate = 0.0001 # with current parameters, it is suggested to use learning rate<0.0001

#%%

def run_training():

    # you need to change the directories to yours.

    #train_dir = '/home/kevin/tensorflow/cats_vs_dogs/data/train/'#数据存放路径

    train_dir = 'E:\\data\\Dog_Cat\\train\\'

    #logs_train_dir = '/home/kevin/tensorflow/cats_vs_dogs/logs/train/'#存放训练参数,模型等

    logs_train_dir = "E:\\CODE\\Anaconda\\tensorflow\\Kaggle\\My-TensorFlow-tutorials-master\\01 cats vs dogs\\"

    train, train_label = input_data.get_files(train_dir)

    train_batch, train_label_batch = input_data.get_batch(train,

                                                          train_label,

                                                          IMG_W,

                                                          IMG_H,

                                                          BATCH_SIZE,

                                                          CAPACITY)

    train_logits = model.inference(train_batch, BATCH_SIZE, N_CLASSES)#获得模型的输出

    train_loss = model.losses(train_logits, train_label_batch)#获取loss

    train_op = model.trainning(train_loss, learning_rate)#训练模型

    train__acc = model.evaluation(train_logits, train_label_batch)#模型评估

    summary_op = tf.summary.merge_all()

    sess = tf.Session()

    train_writer = tf.summary.FileWriter(logs_train_dir, sess.graph)#把summary保存到路径中

    saver = tf.train.Saver()

    sess.run(tf.global_variables_initializer())

    coord = tf.train.Coordinator()

    threads = tf.train.start_queue_runners(sess=sess, coord=coord)

    try:

        for step in np.arange(MAX_STEP):

            if coord.should_stop():

                    break

            _, tra_loss, tra_acc = sess.run([train_op, train_loss, train__acc])

            if step % 50 == 0:

                print('Step %d, train loss = %.2f, train accuracy = %.2f%%' %(step, tra_loss, tra_acc*100.0))

                summary_str = sess.run(summary_op)

                train_writer.add_summary(summary_str, step)

            if step % 2000 == 0 or (step + 1) == MAX_STEP:

                checkpoint_path = os.path.join(logs_train_dir, 'model.ckpt')

                saver.save(sess, checkpoint_path, global_step=step)#保存模型及参数

    except tf.errors.OutOfRangeError:

        print('Done training -- epoch limit reached')

    finally:

        coord.request_stop()

    coord.join(threads)

    sess.close()

run_training()
一些函数说明如下:
1)tf.summary.merge_all
作用:Merges all summaries collected in the default graph.
2)tf.summary.FileWriter
作用:Writes Summary protocol buffers to event files.
3)tf.train.Saver
作用:保存和恢复变量。
举例:
saver.save(sess, 'my-model', global_step=0)

==> filename: 'my-model-0'

...

saver.save(sess, 'my-model', global_step=1000)

==> filename: 'my-model-1000'
4)add_summary
作用:Writes Summary protocol buffers to event files.
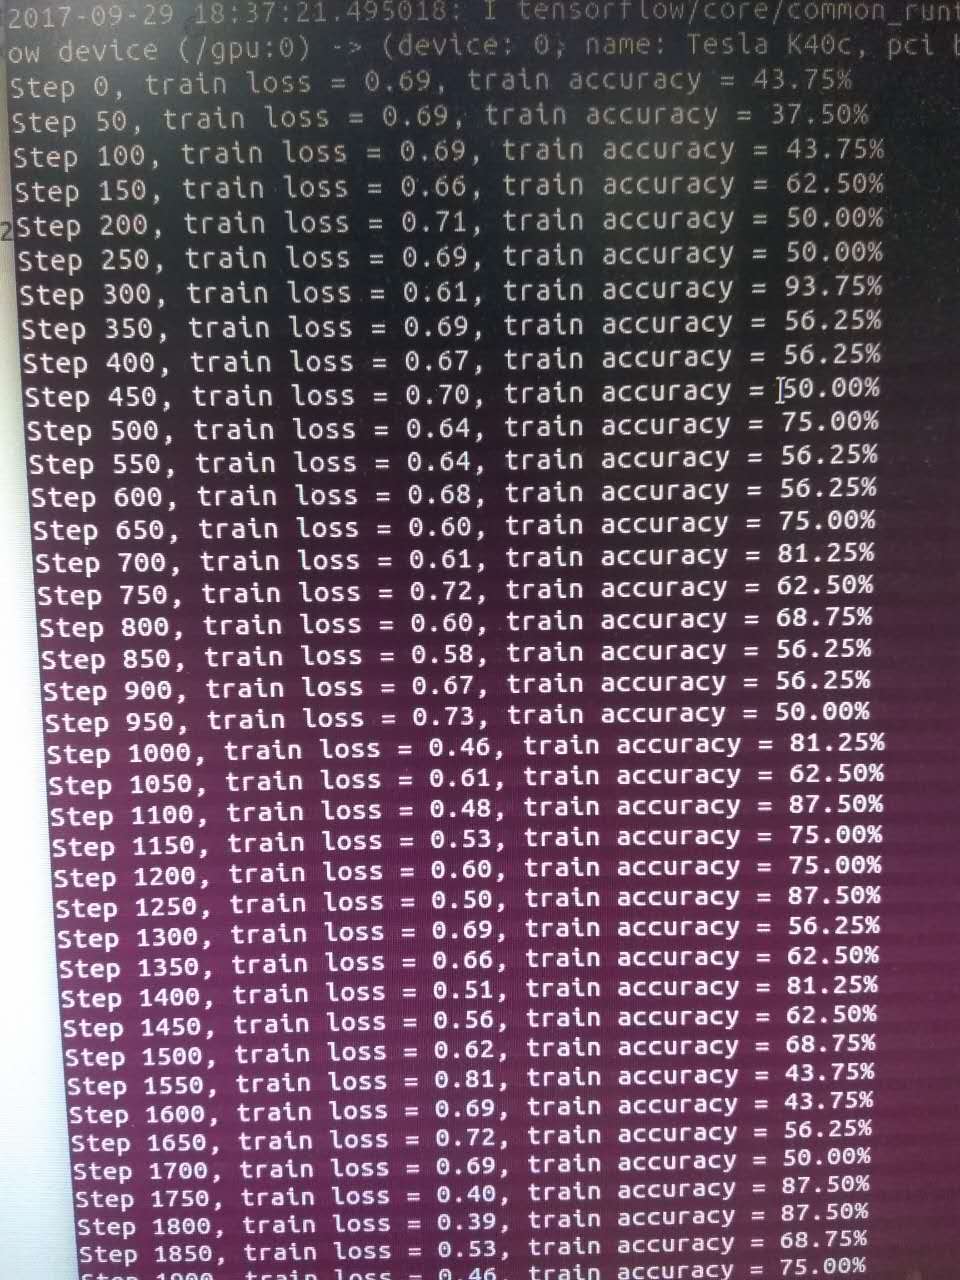
程序运行后,控制台输出如下:
训练期间,也可以使用tensorboard查看模型训练情况。
可以使用如下命令打开tensorboard。
tensorboard --logdir=log文件路径
log文件路径即为程序中设置的logs_train_dir。
启动tensorboard之后,打开浏览器,输入对应网址,即可查看训练情况。
整体解码如下图:
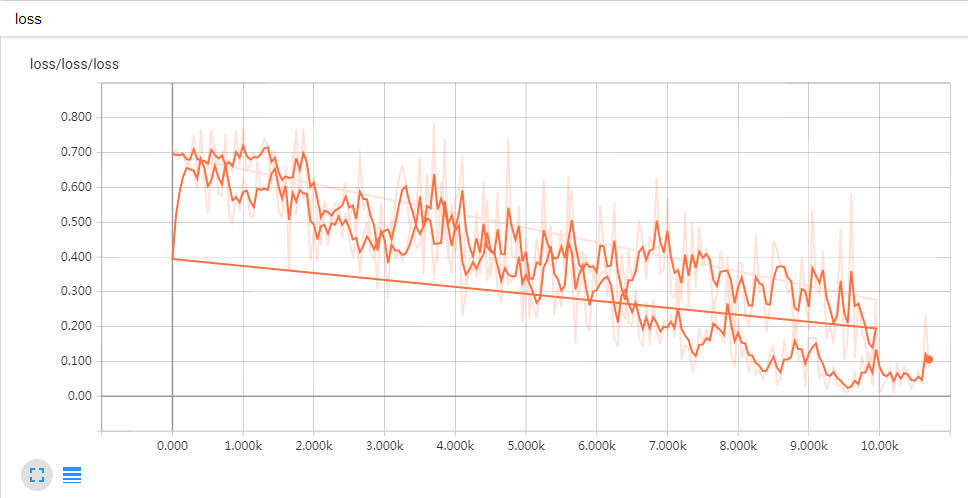
loss与step的关系如下(两条曲线的原因是训练了两次,一次迭代了10000步,另一次迭代了15000步):
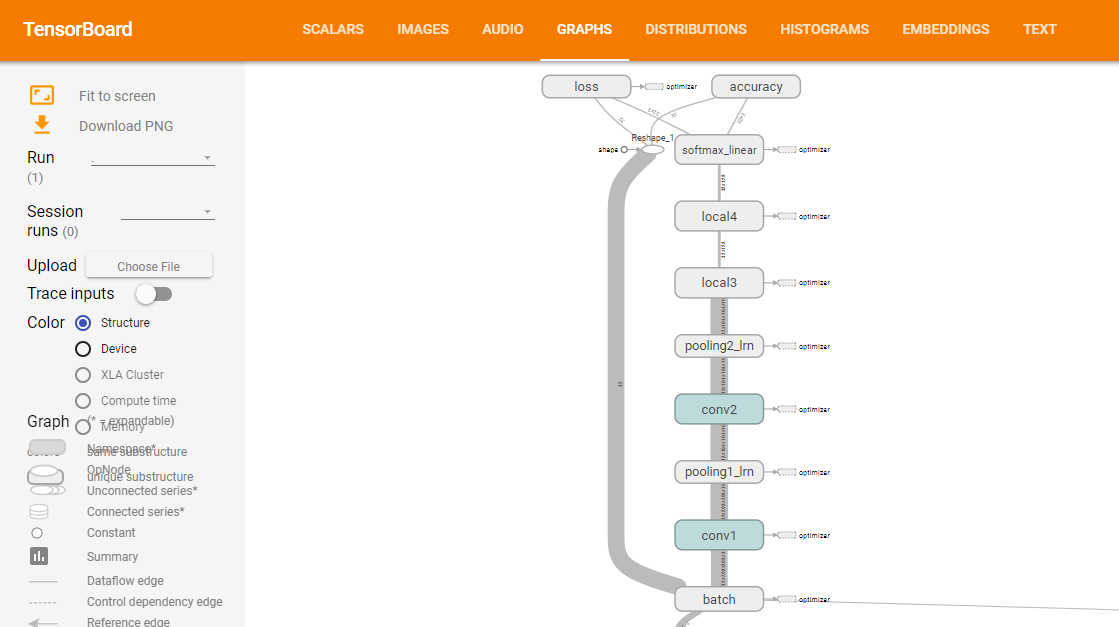
也可以选择查看模型:
说明:
代码来自:https://github.com/kevin28520/My-TensorFlow-tutorials,略有修改
函数作用主要参考tensorflow官网。https://www.tensorflow.org/versions/master/api_docs/
[Kaggle] dogs-vs-cats之模型训练的更多相关文章
- A TensorBoard plugin for visualizing arbitrary tensors in a video as your network trains.Beholder是一个TensorBoard插件,用于在模型训练时查看视频帧。
Beholder is a TensorBoard plugin for viewing frames of a video while your model trains. It comes wit ...
- AI佳作解读系列(一)——深度学习模型训练痛点及解决方法
1 模型训练基本步骤 进入了AI领域,学习了手写字识别等几个demo后,就会发现深度学习模型训练是十分关键和有挑战性的.选定了网络结构后,深度学习训练过程基本大同小异,一般分为如下几个步骤 定义算法公 ...
- VGG19模型训练+读取
目录 VGG-19模型简单介绍 VGG-19模型文件介绍 分析模型文件 mean值查看 Weight和Bias查看 读取代码 读取模型 训练代码 参考资料 VGG-19的介绍和训练这里不做说明,网上资 ...
- 机器学习使用sklearn进行模型训练、预测和评价
cross_val_score(model_name, x_samples, y_labels, cv=k) 作用:验证某个模型在某个训练集上的稳定性,输出k个预测精度. K折交叉验证(k-fold) ...
- 谷歌大规模机器学习:模型训练、特征工程和算法选择 (32PPT下载)
本文转自:http://mp.weixin.qq.com/s/Xe3g2OSkE3BpIC2wdt5J-A 谷歌大规模机器学习:模型训练.特征工程和算法选择 (32PPT下载) 2017-01-26 ...
- facenet模型训练
做下记录,脚本如下: 对比 python3 src/compare.py ../models/-/ ../faces/pyimgs/dashenlin/ytwRkvSdG1000058.png ../ ...
- 人脸检测及识别python实现系列(3)——为模型训练准备人脸数据
人脸检测及识别python实现系列(3)——为模型训练准备人脸数据 机器学习最本质的地方就是基于海量数据统计的学习,说白了,机器学习其实就是在模拟人类儿童的学习行为.举一个简单的例子,成年人并没有主动 ...
- 【机器学习PAI实践十】深度学习Caffe框架实现图像分类的模型训练
背景 我们在之前的文章中介绍过如何通过PAI内置的TensorFlow框架实验基于Cifar10的图像分类,文章链接:https://yq.aliyun.com/articles/72841.使用Te ...
- kaldi基于GMM的单音素模型 训练部分
目录 1. gmm-init-mono 模型初始化 2. compile-train-graghs 训练图初始化 3. align-equal-compiled 特征文件均匀分割 4. gmm-acc ...
随机推荐
- 为什么TCP的ISN是随机的?
两个维度: 1)攻击维度 如果TCP每次连接都使用固定ISN,黑客可以很方便模拟任何IP与server建立连接. 问题:通过抓包就可以计算出来TCP连接的ISN,那固定于不固定ISN有什么区别呢? 答 ...
- 快速失败机制--fail-fast
fail-fast 机制是Java集合(Collection)中的一种错误机制.当多个线程对同一个集合的内容进行操作时,就可能会产生fail-fast(快速失败)事件.例如:当某一个线程A通过iter ...
- 笔记:Spring Cloud Eureka 高可用注册中心
在微服务架构这样的分布式环境中,我们需要充分考虑发生故障的情况,所以在生产环境中必须对各个组件进行高可用部署,对与微服务和服务注册中心都需要高可用部署,Eureka 高可用实际上就是将自己作为服务向其 ...
- Algorithm --> 两个栈实现队列和两个队列实现栈
两个栈实现队列和两个队列实现栈 队列(queue)先进先出的线性表:栈(stack)先进后出的线性表. 两个栈实现队列 法一思路: s1是入栈的,s2是出栈的. 入队列:直接压入s1即可: 出队列:如 ...
- Android一个小巧的记录app(便签或者日记 随心)
入驻博客园两个月今天第一次发随笔,,话不多说,直接上图展示效果 主界面用的RecyclerView的瀑布流(StaggeredGridLayoutManager),同时加上Floatbutton悬浮按 ...
- 几条常见的数据库分页 SQL 语句
SQL Server 先从想要的数据处理加上Row_number()来为数据的row加上一个RowNum作为有多少条数据,然后再用BETWEEN来分隔 with t1 as (select * , ...
- Java注解(1)-注解基础
注解(Annotation)是在JAVA5中开始引入的,它为在代码中添加信息提供了一种新的方式.注解在一定程度上把元数据与源代码文件结合在一起,正如许多成熟的框架(Spring)所做的那样.那么,注解 ...
- Intellij Idea下tomcat设置自动编译
*eclipse默认tomcat下是自动完成编译:而Intellij Idea默认tomcat下不是自动完成编译,从如下开始设置: 进入"settings",如下图找到" ...
- 【福大软工】 W班级总成绩排名2
评分链接: 选题报告 结对第二次作业 需求分析 随堂测试 总分排名:
- 听翁恺老师mooc笔记(2)-第一个程序--&运算符
使用devC++写hello world 第一步:文件-新建-源代码.然后输入"输出hello world"程序: 注意:写程序时关闭中文输入法,否则语句输入的分号可能会被识别为错 ...