
Spark(Hive) SQL中UDF的使用(Python)【转】



Spark(Hive) SQL中UDF的使用(Python)【转】的更多相关文章
- Spark(Hive) SQL中UDF的使用(Python)
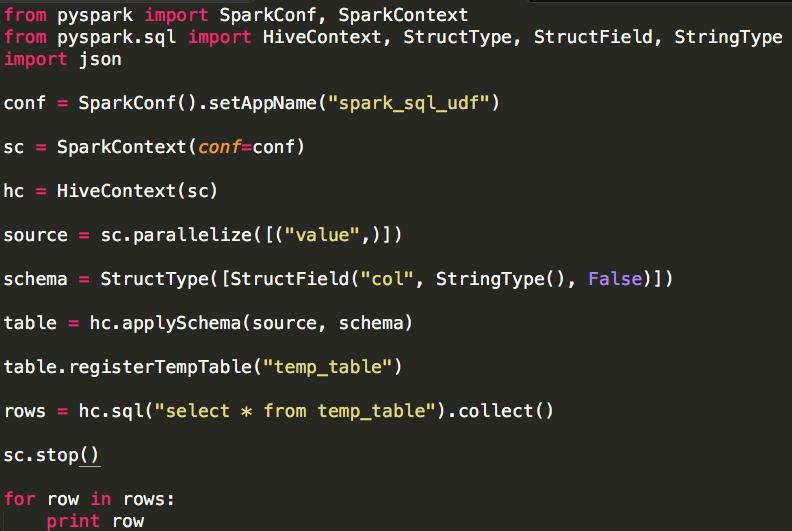
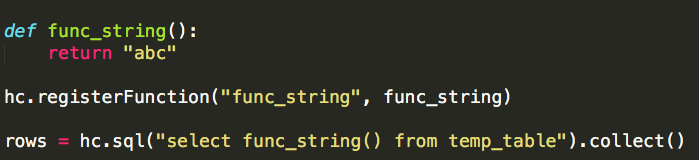
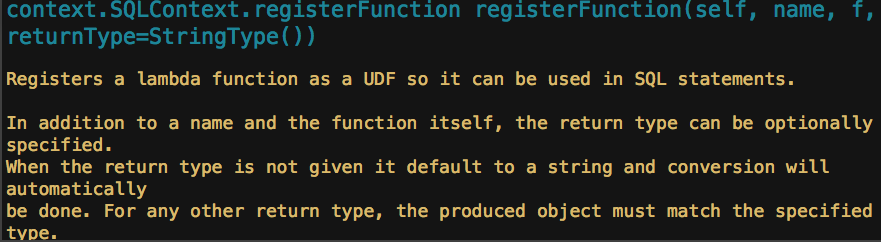
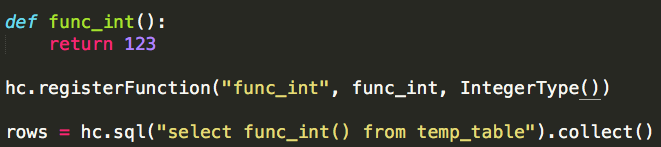
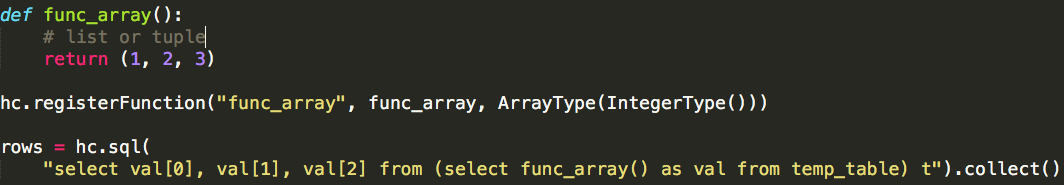
相对于使用MapReduce或者Spark Application的方式进行数据分析,使用Hive SQL或Spark SQL能为我们省去不少的代码工作量,而Hive SQL或Spark SQL本身内 ...
- Spark(Hive) SQL数据类型使用详解(Python)
Spark SQL使用时需要有若干“表”的存在,这些“表”可以来自于Hive,也可以来自“临时表”.如果“表”来自于Hive,它的模式(列名.列类型等)在创建时已经确定,一般情况下我们直接通过Spar ...
- Spark SQL中UDF和UDAF
转载自:https://blog.csdn.net/u012297062/article/details/52227909 UDF: User Defined Function,用户自定义的函数,函数 ...
- 两种方式— 在hive SQL中传入参数
第一种: sql = sql.format(dt=dt) 第二种: item_third_cate_cd_list = " 发发发 " ...... ""&qu ...
- Hive SQL 编译过程
转自:http://www.open-open.com/lib/view/open1400644430159.html Hive跟Impala貌似都是公司或者研究所常用的系统,前者更稳定点,实现方式是 ...
- 【转】Hive SQL的编译过程
Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析.Hive的稳定性和 ...
- Hive SQL的编译过程
文章转自:http://tech.meituan.com/hive-sql-to-mapreduce.html Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是 ...
- 转:Hive SQL的编译过程
Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析.Hive的稳定性和 ...
- Hive SQL的编译过程[转载自https://tech.meituan.com/hive-sql-to-mapreduce.html]
https://tech.meituan.com/hive-sql-to-mapreduce.html Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hi ...
随机推荐
- ios中tableview的移动添加删除
// // MJViewController.m // UITableView-编辑模式 // // Created by mj on 13-4-11. // Copyright (c) 2013年 ...
- (原+译)pytorch中保存和载入模型
转载请注明出处: http://www.cnblogs.com/darkknightzh/p/8108466.html 参考网址: http://pytorch.org/docs/master/not ...
- oracle安装后sqlnet.ora文件
# sqlnet.ora Network Configuration File: D:\Develop\oracle11g\product\11.2.0\dbhome_1\network\admin\ ...
- 由m种数字组成的n位数有多少个
知乎链接 问题描述 我和我女朋友的QQ号都是九位数字,这九个数字是有七个不同的数字组成的,我想问这种概率是多大,我们是不是特别我看缘分呢?求大神给算一下概率! 思路 定义问题:由7种数字组成的9位数一 ...
- 给你出道题---N个数字的静态决策区分问题
决策,是世界上最重要的事情. 走路分两步:看准方向,大步前进.看准方向的过程就是决策. 任何一个问题,都对应两个空间:解空间和决策空间.我们所要做的就是使用决策空间去划分解空间. 决策可以分成两类:单 ...
- Java获取函数参数名称
原理 编译之后的class文件默认是不带有参数名称信息的,使用 IDE 时,反编译jar包得到的源代码函数参数名称是 arg0,arg1......这种形式,这是因为编译 jar 包的时候没有把符号表 ...
- 【MATLAB】matlabR2010a与vs2010联合编译设置
在matlab中编译C++程序,首先要配置编译器>> mex -setupPlease choose your compiler for building external interfa ...
- Apache 日志设置不记录指定文件类型的方法和日志轮
Apache日志精准的记录了Web访问的记录,但对于访问量很大的站来说,日志文件过大对于分析和保存很不方便.可以在http.conf(或虚拟主机设置文件httpd-vhosts.conf)中进行设置, ...
- OpenCV 学习笔记03 凸包convexHull、道格拉斯-普克算法Douglas-Peucker algorithm、approxPloyDP 函数
凸形状内部的任意两点的连线都应该在形状里面. 1 道格拉斯-普克算法 Douglas-Peucker algorithm 这个算法在其他文章中讲述的非常详细,此处就详细撰述. 下图是引用维基百科的.ε ...
- XGB 调参基本方法
- xgboost 基本方法和默认参数 - 实战经验中调参方法 - 基于实例具体分析 在训练过程中主要用到两个方法:xgboost.train()和xgboost.cv(). xgboost.trai ...