
Spark(Hive) SQL中UDF的使用(Python)



Spark(Hive) SQL中UDF的使用(Python)的更多相关文章
- Spark(Hive) SQL中UDF的使用(Python)【转】
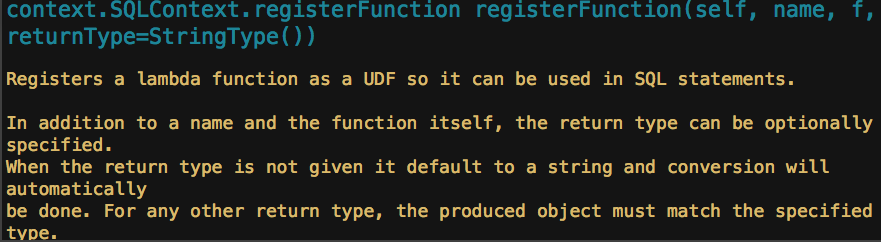
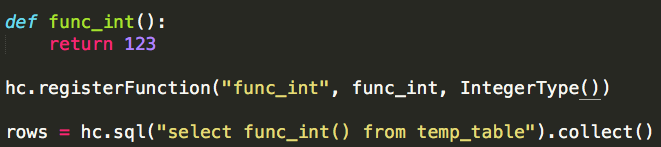
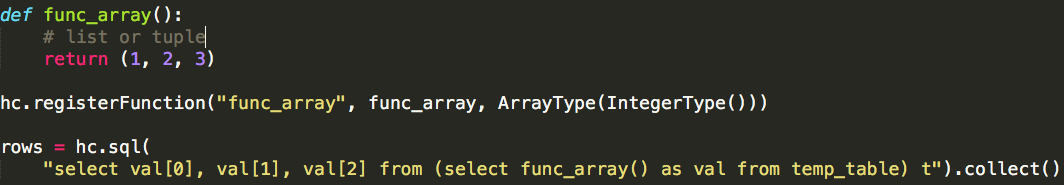
相对于使用MapReduce或者Spark Application的方式进行数据分析,使用Hive SQL或Spark SQL能为我们省去不少的代码工作量,而Hive SQL或Spark SQL本身内 ...
- Spark(Hive) SQL数据类型使用详解(Python)
Spark SQL使用时需要有若干“表”的存在,这些“表”可以来自于Hive,也可以来自“临时表”.如果“表”来自于Hive,它的模式(列名.列类型等)在创建时已经确定,一般情况下我们直接通过Spar ...
- Spark SQL中UDF和UDAF
转载自:https://blog.csdn.net/u012297062/article/details/52227909 UDF: User Defined Function,用户自定义的函数,函数 ...
- 两种方式— 在hive SQL中传入参数
第一种: sql = sql.format(dt=dt) 第二种: item_third_cate_cd_list = " 发发发 " ...... ""&qu ...
- Hive SQL 编译过程
转自:http://www.open-open.com/lib/view/open1400644430159.html Hive跟Impala貌似都是公司或者研究所常用的系统,前者更稳定点,实现方式是 ...
- 【转】Hive SQL的编译过程
Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析.Hive的稳定性和 ...
- Hive SQL的编译过程
文章转自:http://tech.meituan.com/hive-sql-to-mapreduce.html Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是 ...
- 转:Hive SQL的编译过程
Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析.Hive的稳定性和 ...
- Hive SQL的编译过程[转载自https://tech.meituan.com/hive-sql-to-mapreduce.html]
https://tech.meituan.com/hive-sql-to-mapreduce.html Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用.美团数据仓库也是基于Hi ...
随机推荐
- SharePoint SiteCollection Administrator
到网上去找怎么取到一个站点的sitecollection Administrator, 如果设置了一个站点的 sitecollection Administrator, 那么通过: SPSite ...
- Python初学记录
发音: 拍怂 语系:类C 特点: 1语句控制不用{}和(),而是强制用户空格或tab缩进.空格和tab数量不一定. 2解释性语言,不需要事先声明变量,即写即用. 3.list 列表可存放多种类型数据. ...
- 文件上传利器SWFUpload使用指南
这里就不再介绍什么是SWFUpload啦,简单为大家写一个简单关于SWFUpload的Demo. 1.把SWFUpload 相关的文件引用进来 2.创建upload.aspx页面(页面名称可自定义), ...
- Object-C — KVO & oc通知
键值观察(KVO)是基于键值编码的一种技术. 利用键值观察可以注册成为一个对象的观察者,在该对象的某个属性变化时收到通知. 被观察对象需要编写符合KVC标准的存取方法,编写键值观察分为以下三步: (1 ...
- 如何生成publish windows app 用到的 pfx 文件
参考文章 https://msdn.microsoft.com/en-us/library/windows/desktop/jj835832(v=vs.85).aspx 1.在项目中查找.appxma ...
- Github上图文演示仓库创建
1.注册账号 https://github.com/ 2.注册完账号 创建仓库 a.点击按钮 Start a project b.填写信息,点击按钮 Create repository c.仓库信息( ...
- Open judge 07和为给定数
总时间限制: 1000ms 内存限制: 65536kB 传送门 类似的题传送门 描述 给出若干个整数,询问其中是否有一对数的和等于给定的数. 输入 共三行: 第一行是整数n(0 < n < ...
- ES 中文分词
一.大名鼎鼎的中文插件IK的安装配置 1. 在插件目录中建立IK的目录 mkdir $ES_HOME/plugins/analysis-ik 2. 下载IK 的类库jar 文件到IK目录 cd $ES ...
- android入门到熟练(二)----活动
1.活动创建对于每一个后端java类(继承至Activity或者ActionBarActivity)代码都有一个方法需要被重写[onCreate], 在此方法中可以加载界面资源文件或者绑定元素事件. ...
- 自定义流程gooflow.08 demo在线演示
一.功能简介 gooflow功能清单1.自定义流程绘制2.自定义属性添加3.支持3种步骤类型 普通审批步骤 自动决策步骤 手动决策步骤 4.决策方式(支持js决策,sql语句决策) 5.审批人员参与方 ...