
The perception and large margin classifiers
假设样例按照到来的先后顺序依次定义为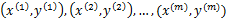 。
为样本特征,
为类别标签。任务是到来一个样例
,给出其类别结果
的预测值,之后我们会看到真实值
,然后根据真实值来重新调整模型参数,整个过程是重复迭代的过程,直到所有的样例完成。这么看来,我们也可以将原来用于批量学习的样例拿来作为在线学习的样例。在在线学习中,我们主要关注在整个预测过程中预测错误的样例数。
用表示正例,
表示负例,支持向量机中提到的感知算法(perception algorithm),我们的假设函数为:
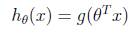
其中,x是n维特征向量, 是n+1维参数权重。函数g用来将
 计算结果映射到-1和1上。具体公式如下:
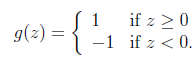
提出一个在线学习算法如下:
新来一个样例 ,我们先用从之前样例学习到的
 来得到样例的预测值y,如果
 (即预测正确),那么不改变
 ,反之

如果对于预测错误的样例, 进行调整时只需加上(实际上为正例)或者减去(实际负例)样本特征x值即可。
 初始值为向量0。这里我们关心的是
 的符号,而不是它的具体值。调整方法非常简单,然而这个简单的调整方法还是很有效的,它的错误率不仅是有上界的,而且这个上界不依赖于样例数和特征维度。
下面定理阐述了错误率上界:
定理(Block and Novikoff):
给定按照顺序到来的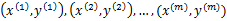 样例。假设对于所有的样例
 ,也就是说特征向量长度有界为D。更进一步,假设存在一个单位长度向量
 且
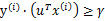 。也就是说对于y=1的正例,
 ,反例
 ,u能够有
 的间隔将正例和反例分开。那么感知算法的预测的错误样例数不超过
 。
根据对SVM的理解,这个定理就可以阐述为:如果训练样本线性可分,并且几何间距至少是 ,样例样本特征向量最长为D,那么感知算法错误数不会超过
 。这个定理是62年提出的,63年Vapnik提出SVM,可见提出也不是偶然的,感知算法也许是当时的热门。
下面主要讨论这个定理的证明:
感知算法只在样例预测错误时进行更新,定义 是第k次预测错误时使用的样本特征权重,
 初始化为0向量。假设第k次预测错误发生在样例
 上,利用
 计算
 值时得到的结果不正确(也就是说
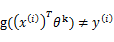 ,调换x和
 顺序主要是为了书写方便)。也就是说下面的公式成立:
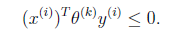
根据感知算法的更新方法,我们有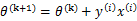 。这时候,两边都乘以u得到
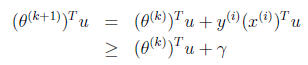
两个向量做内积的时候,放在左边还是右边无所谓,转置符号标注正确即可。
这个式子是个递推公式,就像等差数列一样f(n+1)=f(n)+d,由此我们可得:
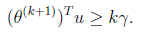
因为初始 为0,下面我们利用前面推导出的
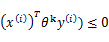 和
 得到
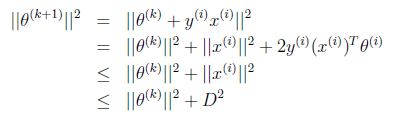
也就是说 的长度平方不会超过
 与D的平方和。
又是一个等差不等式,得到:
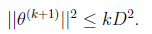
两边开根号得:
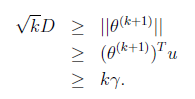
其中第二步可能有点迷惑,我们细想u是单位向量的话,
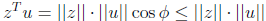
因此上面的不等式成立,最后得到:

也就是预测错误的数目不会超过样本特征向量x的最长长度与几何间隔的平方,实际上整个调整过程中 就是x的线性组合。
整个感知算法应该是在线学习中最简单的一种了。
The perception and large margin classifiers的更多相关文章
- 基于Caffe的Large Margin Softmax Loss的实现(中)
小喵的唠叨话:前一篇博客,我们做完了L-Softmax的准备工作.而这一章,我们开始进行前馈的研究. 小喵博客: http://miaoerduo.com 博客原文: http://www.miao ...
- 基于Caffe的Large Margin Softmax Loss的实现(上)
小喵的唠叨话:在写完上一次的博客之后,已经过去了2个月的时间,小喵在此期间,做了大量的实验工作,最终在使用的DeepID2的方法之后,取得了很不错的结果.这次呢,主要讲述一个比较新的论文中的方法,L- ...
- Large Margin Softmax Loss for Speaker Verification
[INTERSPEECH 2019接收] 链接:https://arxiv.org/pdf/1904.03479.pdf 这篇文章在会议的speaker session中.本文主要讨论了说话人验证中的 ...
- cosface: large margin cosine loss for deep face recognition
目录 概 主要内容 Wang H, Wang Y, Zhou Z, et al. CosFace: Large Margin Cosine Loss for Deep Face Recognition ...
- Large Margin DAGs for Multiclass Classification
Abstract We present a new learning architecture: the Decision Directed Acyclic Graph (DDAG), which i ...
- 吴恩达机器学习笔记43-SVM大边界分类背后的数学(Mathematics Behind Large Margin Classification of SVM)
假设我有两个向量,
- 吴恩达机器学习笔记42-大边界的直观理解(Large Margin Intuition)
这是我的支持向量机模型的代价函数,在左边这里我画出了关于
- Kemaswill 机器学习 数据挖掘 推荐系统 Ranking SVM 简介
Ranking SVM 简介 排序一直是信息检索的核心问题之一,Learning to Rank(简称LTR)用机器学习的思想来解决排序问题(关于Learning to Rank的简介请见我的博文Le ...
- Coursera, Machine Learning, SVM
Support Vector Machine (large margin classifiers ) 1. cost function and hypothesis 下面那个紫色线就是SVM 的cos ...
随机推荐
- 微服务解决框架--SpringCloud
- Python—装饰器详解
装饰器:(语法糖) 本质是函数,它是赋予函数新功能,但是不改变函数的源代码及调用方式 原则: 1.不能修改被装饰函数的源代码 2.不能修改被装饰函数的调用方式 3.函数的返回值也不变 这两点简而言 ...
- python全栈开发笔记---------数据类型---字典方法
def clear(self) 清空字典里所有元素 # info = { # "k1":18, # "k2":True, # "k3":[ ...
- ui学习心得
软工课上我分配的任务是界面设计,但是对于初期一个ps从没接触的人来说我觉得还是有点困难,所以要从头学起. PS的功能是什么呢?对于业余爱好者来说,主要还是做一些简单的处理照片.绘图.设计一些皮肤等, ...
- Centos7安装xenserver tools
mount /dev/cdrom /mnt [root@192 ~]# mount /dev/cdrom /mntmount: /dev/sr0 写保护,将以只读方式挂载[root@192 ~]# c ...
- ARTS(一)
ARTS第一周,2019年3月17日,星期日,天气晴. A:算法学习(Algorithm) 将一个给定字符串根据给定的行数,以从上往下.从左到右进行 Z 字形排列. 比如输入字符串为 "LE ...
- python的format格式化
使用方法: '{}bbccc'.format(aa) = aabbcc, 用来代替python2中的%,即替换. 1.通过位置来指定替换 In [2]: '{0},{1}'.format('a', ...
- linux rpm方式安装mysql
01.搜索 mysql linux 网盘地址 http://pan.baidu.com/s/1qYOC6cs 02.把下载好的mysql 使用 xftp传到 linux中 software 文件 ...
- C高级第二次作业
PTA作业第一部分 6-7 删除字符串中数字字符(10 分) 删除一个字符串中的所有数字字符. 函数接口定义: void delnum(char *s); 其中 s是用户传入的参数. 函数的功能是删除 ...
- Codeforces 215D. Hot Days(贪心)
题意 有nnn个地区和mmm个学生,在第iii个地区时,车上有kik_iki个学生,车内温度(当前城市的温度tit_iti+当前车上的学生kik_iki)不能超过TiT_iTi,否则,赔偿每个 ...