
Scrapy 爬虫实例教程(一)---简介及资源列表

Scrapy(官网 http://scrapy.org/)是一款功能强大的,用户可定制的网络爬虫软件包。其官方描述称:"
Scrapy is a fast high-level screen scraping and web crawling framework, used to crawl websites and extract structured data from their pages. It can be used for a wide range of purposes, from data mining to monitoring and automated testing
"
Scrapy在github中有源码托管https://github.com/scrapy/scrapy,其安装可以参考github中提供的安装方法(大百度中也提供了很多安装方法的描述)。另外网站1和网站2提供了scrapy的使用方法和简单实例(小编后续随笔也会简单写一个scrapy实例,供大家参考)。
Scrapy的爬虫原理:
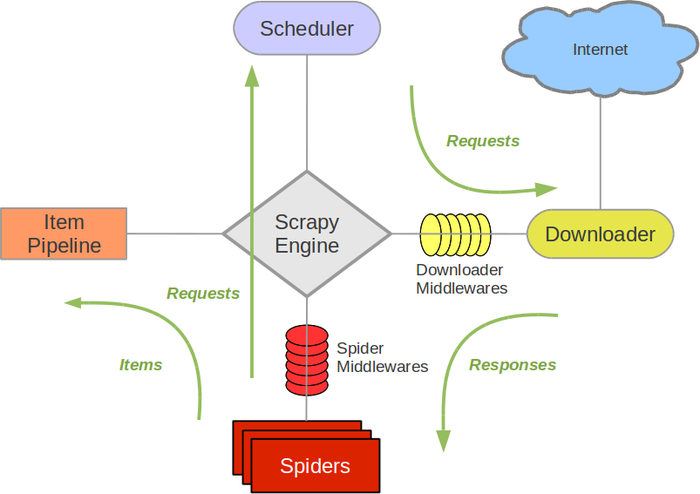
”盗用“的scrapy 官网中的scrapy核心框架图
Scrapy Engine是scrapy软件的核心,他负责各个组件的协调处理
Scheduler是调度器,负责爬去队列的管理,如Request的入队和出队管理
Item Pipeline 是抓取内容的核心组件,用户想要获取的内容可以写入item 然后再pipeline中设计数据的流向比如写入文件或是持久化到数据库中
Downloader 则是scrapy与web site接触的端口,负责根据Request 请求网页然后以response的形式返回用户处理接口(默认是 spider的parse函数)
Spider则是用户定制兴趣内容的模块,在scrapy的spiders中内置了BaseSpider,CSVFeedSpider,CrawlerSpider,用户可以根据情况选择合适spider继承与开发
Spider Middlewares则是Spider与Scrapy Engine 的中间层,用户可以个性化定义Spider向Engine传输过程
Scrpay的运行过程:
(1)Engine从Spider中获取一个需要爬取的URL(从spider中start_url获取),并以Request的形式在Scheduler中列队。
(2)Scheduler根据列队情况,把Request发送给Downloader,Downloader根据Request请求网页,并获取网页内容。
(3)网页内容以Response的形式经过Engine发送给Spider,并根据用户解析生成Item,发送给Pipeline。
(4)Pipeline根据获得的item和settings中的设置,处理item(process_item)把数据输出到文件或是数据库中。
上述过程反复进行,直到没有新的请求为止(此过程是一个异步处理过程)。
个人整理的Scrapy资源列表(望笑纳):
(1)scrapy中文教程
http://scrapy-chs.readthedocs.io/zh_CN/latest/intro/overview.html
(2)一个不错的scrapy学习博客
http://blog.csdn.net/column/details/younghz-scrapy.html
(3)scrapy 官方wiki
https://github.com/scrapy/scrapy/wiki
(4)scrapy实例
https://github.com/jackgitgz/CnblogsSpider
Scrapy 爬虫实例教程(一)---简介及资源列表的更多相关文章
- Scrapy爬虫实例教程(二)---数据存入MySQL
书接上回 实例教程(一) 本文将详细描述使用scrapy爬去左岸读书所有文章并存入本地MySql数据库中,文中所有操作都是建立在scrapy已经配置完毕,并且系统中已经安装了Mysql数据库(有权限操 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影
前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大家讲解一个完整爬虫的流程. 工具和环境 语言:python 2 ...
- 简单scrapy爬虫实例
简单scrapy爬虫实例 流程分析 抓取内容:网站课程 页面:https://edu.hellobi.com 数据:课程名.课程链接及学习人数 观察页面url变化规律以及页面源代码帮助我们获取所有数据 ...
- scrapy爬虫实例(1)
爬虫实例 对象 阳光问政平台 目标 : 主题,时间,内容 爬取思路 预先设置好items import scrapy class SuperspiderItem(scrapy.Item): title ...
- Scrapy爬虫实例——校花网
学习爬虫有一段时间了,今天使用Scrapy框架将校花网的图片爬取到本地.Scrapy爬虫框架相对于使用requests库进行网页的爬取,拥有更高的性能. Scrapy官方定义:Scrapy是用于抓取网 ...
- Scrapy爬虫框架教程(四)-- 抓取AJAX异步加载网页
欢迎关注博主主页,学习python视频资源,还有大量免费python经典文章 sklearn实战-乳腺癌细胞数据挖掘 https://study.163.com/course/introduction ...
- python scrapy 爬虫实例
1 创建一个项目 scrapy startproject basicbudejie 2 编写爬虫 import scrapy class Basicbudejie(scrapy.Spider): na ...
- scrapy爬虫框架处理流程简介
1.SPIDERS的yeild将request发送给ENGIN2.ENGINE对request不做任何处理发送给SCHEDULER3.SCHEDULER( url调度器),生成request交给ENG ...
随机推荐
- C++构造函数虚函数例题
虚函数: #include <iostream> class A { public: A ():m_iVal() { test(); } virtual void func() { std ...
- Introducing: Machine Learning in R(转)
Machine learning is a branch in computer science that studies the design of algorithms that can lear ...
- 建造者模式—设计角度重温DNF中的角色
应用场景 假设现在我们要设计DNF中的人物角色(鬼剑士.神枪手.魔法师.圣骑士.格斗家).然而,利用面对对象的思想,必须先从实体入手,每一个角色都包含各种装备.武器.配饰,这些就当做要建造的零件,然后 ...
- Android学习探索之App多渠道打包及动态添加修改资源属性
前言: 关于Android渠道打包是一个比较老的话题,今天主要记录总结一下多渠道打包以及如果动态配置修改一些资源属性.今天以公司实际需求为例进行演示,由于项目复用很多公共的业务组件,而且业务组件之间的 ...
- python语言精粹《一》
第一章 静态语言:需要声明类型.变量不能改变类型! 动态语言:(也称脚本语言)主要的应用场景都是很短的应用程序(脚本),比如给静态语言编写的程序进行数据预处理.这样的程序通常也统称胶水代码. pyth ...
- nodejs零基础详细教程2:模块化、fs文件操作模块、http创建服务模块
第二章 建议学习时间4小时 课程共10章 学习方式:详细阅读,并手动实现相关代码 学习目标:此教程将教会大家 安装Node.搭建服务器.express.mysql.mongodb.编写后台业务逻辑 ...
- 基于FPGA的彩色图像转灰度算法实现
昨天才更新了两篇博客,今天又要更新了,并不是我垃圾产,只不过这些在上个月就已经写好了,只是因为比赛忙,一直腾不出时间整理出来发表而已,但是做完一件事情总感觉不写一博文总结一下就少点什么,所以之后的一段 ...
- JS/jQ常用宽高及应用
关于js的宽高,随便一搜就是一大堆.这个一大堆对我来说可不是什么好事,看的头都大了.所以今天就总结了一些比较会常用的,并说明一下应用场景. 先来扯一下documentElement和body的微妙关系 ...
- angular多页面切换传递参数
<!DOCTYPE html> <html lang="en" ng-app="myapp"> <head> <met ...
- Linux根目录各个文件夹介绍及说明
/bin 二进制可执行命令 /dev 设备特殊文件 /etc 系统管理和配置文件 /etc/rc.d 启动的配置文件和脚本 /home 用户主目录的基点,比如用户user的主目录就是/home/use ...