
简单scrapy爬虫实例
简单scrapy爬虫实例
流程分析
抓取内容:网站课程
页面:https://edu.hellobi.com
数据:课程名、课程链接及学习人数
观察页面url变化规律以及页面源代码帮助我们获取所有数据
1、scrapy爬虫的创建
在pycharm的Terminal中输入以下命令:
创建scrapy项目:scrapy startproject ts
进入到项目目录中:cd first
创建一个新的spider:scrapy genspider -t basic lesson hellobi.com
2、scrapy爬虫代码编写
2.1items文件编写
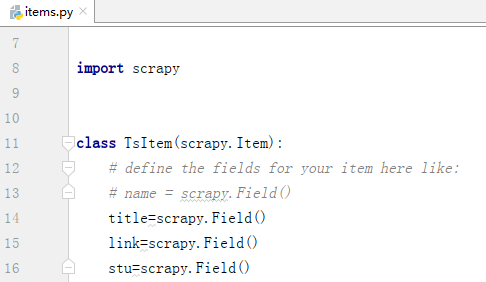
在items.py文件中定义自己要抓取的数据,我们要爬取天善智能网站的课程、课程链接和学习人数,需要这三者的数据,所以此时创建item的三个类。
2.2编写spider文件(lesson.py)
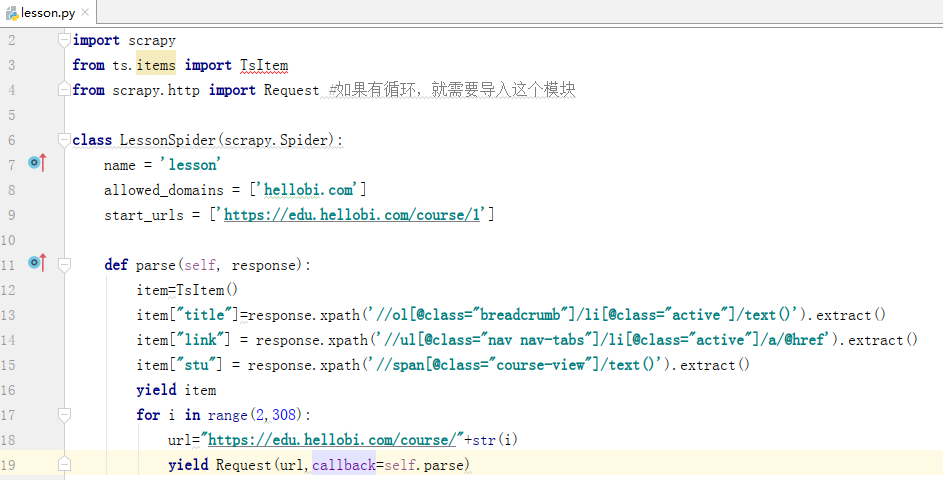
由于要提取该网站所有课程的消息,需要构造了所有的课程url。此时观察观察多个url,找出其中url变化的规律,以此来构造所有的url。由于每个课程都需要包含课程名、课程链接以及学习人数,所有设置相应的xpath,分别匹配item的三个类。
2.3修改pipeline.py的内容:
将爬取到的数据写入“F:/天善课程爬取/1.txt”中。

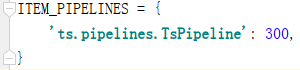
2.4修改settings.py文件,配置pipeline:
3、总结
至此,爬虫就全部编写完成了,在scrapy中xpath很重要,如果xpath提取错误的话,可能会造成许多错误。另外在输出和写入文件时也要注意,不然也会有错误发生。在程序的最后一定要关闭文件,不然最后打开文件的内容为空。
简单scrapy爬虫实例的更多相关文章
- Python 利用Python编写简单网络爬虫实例3
利用Python编写简单网络爬虫实例3 by:授客 QQ:1033553122 实验环境 python版本:3.3.5(2.7下报错 实验目的 获取目标网站“http://bbs.51testing. ...
- Python 利用Python编写简单网络爬虫实例2
利用Python编写简单网络爬虫实例2 by:授客 QQ:1033553122 实验环境 python版本:3.3.5(2.7下报错 实验目的 获取目标网站“http://www.51testing. ...
- scrapy爬虫实例(1)
爬虫实例 对象 阳光问政平台 目标 : 主题,时间,内容 爬取思路 预先设置好items import scrapy class SuperspiderItem(scrapy.Item): title ...
- Scrapy爬虫实例——校花网
学习爬虫有一段时间了,今天使用Scrapy框架将校花网的图片爬取到本地.Scrapy爬虫框架相对于使用requests库进行网页的爬取,拥有更高的性能. Scrapy官方定义:Scrapy是用于抓取网 ...
- python爬虫系列(1)——一个简单的爬虫实例
本文主要实现一个简单的爬虫,目的是从一个百度贴吧页面下载图片. 1. 概述 本文主要实现一个简单的爬虫,目的是从一个百度贴吧页面下载图片.下载图片的步骤如下: 获取网页html文本内容:分析html中 ...
- Scrapy 爬虫实例教程(一)---简介及资源列表
Scrapy(官网 http://scrapy.org/)是一款功能强大的,用户可定制的网络爬虫软件包.其官方描述称:" Scrapy is a fast high-level screen ...
- Scrapy爬虫实例教程(二)---数据存入MySQL
书接上回 实例教程(一) 本文将详细描述使用scrapy爬去左岸读书所有文章并存入本地MySql数据库中,文中所有操作都是建立在scrapy已经配置完毕,并且系统中已经安装了Mysql数据库(有权限操 ...
- python scrapy 爬虫实例
1 创建一个项目 scrapy startproject basicbudejie 2 编写爬虫 import scrapy class Basicbudejie(scrapy.Spider): na ...
- 简单python爬虫实例
先放上url,https://music.douban.com/chart 这是豆瓣的一个音乐排行榜,这里爬取了左边部分的歌曲排行榜部分,爬虫很简单,就用到了beautifulsoup和request ...
随机推荐
- drf token刷新配置、认证组件(使用)、权限组件(使用)、频率组件(使用)、异常组件(使用)
目录 一.特殊路由映射的请求 二.token刷新机制配置(了解) 三.认证组件项目使用:多方式登录 1.urls.py 路由 2.views.py 视图 3.serializers.py 序列化 4. ...
- 内部类(innerclasses)
一般情况下,我们把类定义成独立的单元.有些情况下,我们把一个类放在另一个类的内部定义为内部类. 内部类的作用: 1.内部类提供了更好的封装.只能让外部类直接访问,不允许同一个包中的其他类直接访问. 2 ...
- pikachu-反序列化漏洞
1.序列化的概念(摘自pikachu平台的介绍) (1)序列化serialize() 序列化说通俗点就是把一个对象变成可以传输的字符串,比如下面是一个对象: class S{ public $te ...
- ES6 - 基础学习(3): 变量的解构赋值
解构赋值概述 1.解构赋值是对赋值运算符的扩展. 2.它是一种针对数组或者对象进行模式匹配,然后对其中的变量进行赋值. 3.代码书写上显得简洁且易读,语义更加清晰明了:而且还方便获取复杂对象中的数据字 ...
- 源码浅析:InnoDB聚集索引如何定位到数据的物理位置,并从磁盘读取
索引结构概述: MyISAM索引文件和数据文件是分离的,索引文件仅保存数据记录的地址.这与Oracle的索引结构相似,比较好理解.那么,常用的Innodb聚集索引结构是怎样的呢? InnoDB的数据文 ...
- 在window上安装mysql - MySQL5.7.24 版本
1.下载安装包 下载地址:https://dev.mysql.com/downloads/mysql/5.7.html#downloads 点击Download,选择 No thanks, just ...
- Oracle的overlaps函数转换其他数据库语法
首先,来介绍一下Oracle的overlaps函数的用法: overlaps函数是用来判断两个时间段是否有重叠的 比如说计算 (a,b),(c,d) 就可以写成: select * from dual ...
- for循环嵌套练习题or99乘法表
//输出1-10之间的和 public static void whileTest(){ //定义变量用于存储不断变化的和 int sum = 0; //定义变量,用于记录不断变化的被加数 int x ...
- 关于...corresponds to your MySQL server version for the right syntax to use near '?' at line 1的解决办法
完整报错信息: java.sql.SQLSyntaxErrorException: You have an error in your SQL syntax; check the manual tha ...
- html网页基本结构
<!DOCTYPE> 不是 HTML 标签.它为浏览器提供一项信息(声明),即 HTML 是用什么版本编写的. HTML5 DOCTYPE 的 HTML 文档类型如下: <!DOCT ...