
Spark学习笔记1(初始spark
1.什么是spark?
spark是一个基于内存的,分布式的,大数据的计算框架,可以解决各种大数据领域的计算问题,提供了一站式的服务
Spark2009年诞生于伯克利大学的AMPLab实验室
2010年正式开源了Spark项目
2013年Spark成为Apache下的项目
2014年飞速发展,成为Apache的顶级项目
2015年在国内兴起,代替mr,hive,storm等
2.SparkCore :spark是用来取代Hadoop的?
这种说法是不对的,spark由于只能做计算,所以取代掉MapReduce是没有问题的,但是基于spark无法存储数据,所以其数据的存储还是要依赖于hdfs,资源调度可以依赖于yarn,亦可以依赖于其他。
3.spark的功能?
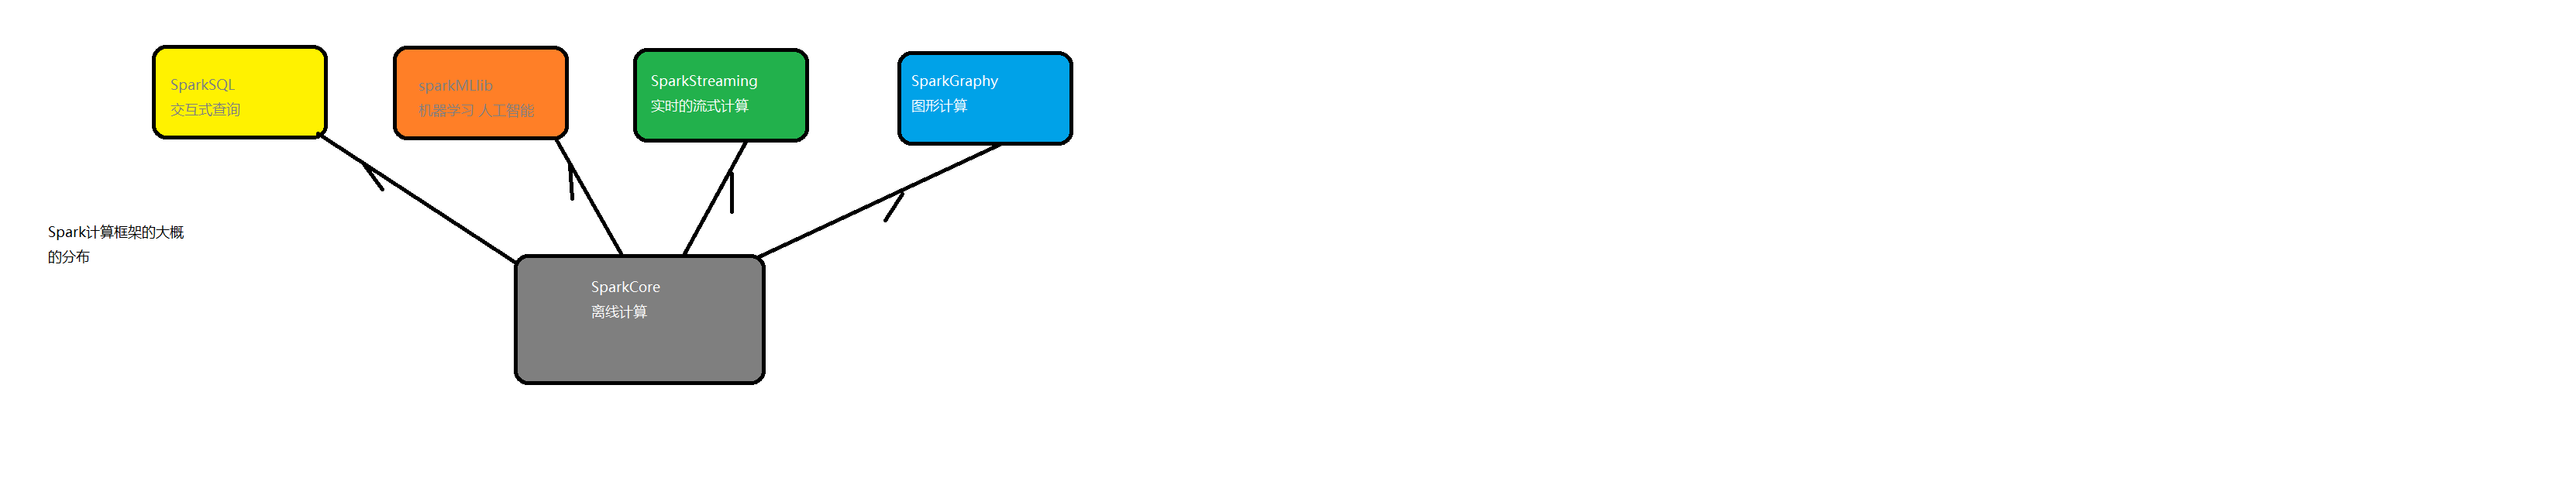
①sparkCore 离线计算
②sparkSQL 交互式查询
③sparkStreaming 实时的流式计算
④sparkGraphx 图形计算
⑤spark mllib 机器学习 人工智能 其核心是算法
4.spark的特点及解释?
spark的特点有:
①一站式:就是说spark可以用一个技术堆栈就可以解决大数据领域的所有的计算问题
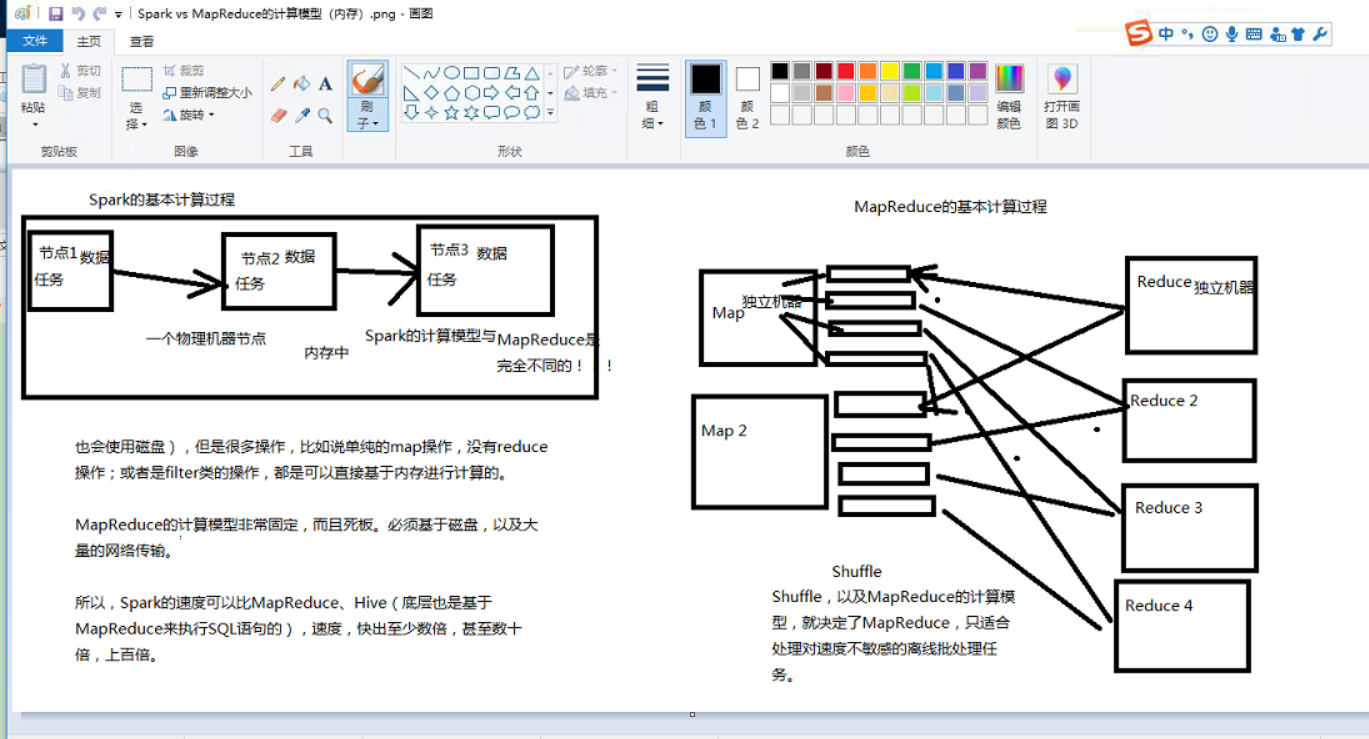
②基于内存:这个特点也是spark的运行速度比Mr的速度快的原因,因为spark是基于内存的,内存的
读写的速度要大大的超过磁盘,但是,有一些操作也是无法避免的,spark也有shuffle,所以说最后的
结果也要落地,落地就i需要走磁盘。另一方面的原因就是spark是迭代式的计算框架,内部又有很多的
优化手段,DAG,切分STAGE,这一套机制可以最大限度的优化计算的性能
5.sparkSQL和hive的关系?
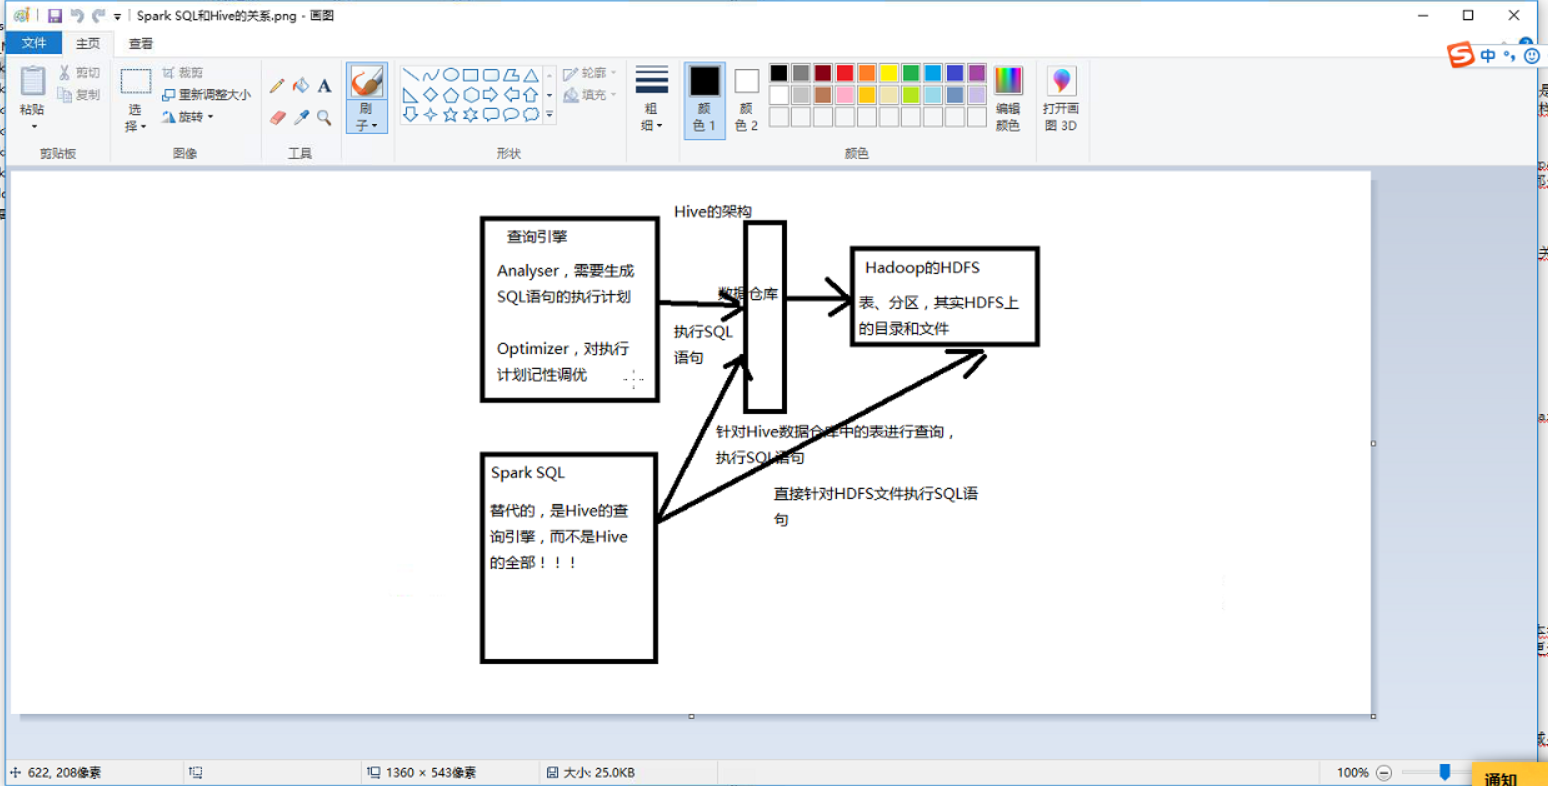
hive 首先来说是一个数据仓库,里面放了很多的数据,其次hive还可以通过sql做一些数据的离线批处理,
运行的是MapReduce。
spark SQL 肯定不可以用来做数据仓库,但spark SQL也是通过写sql的方式,做数据的离线计算,底层用的
是RDD。可以直接操作hive
6.sparkStreaming和strom的关系?
strom有很多的有点,比较老了,如果说是纯粹的实时(全部都是实时的业务),现在有一个更加优秀的解决方案
:flink,在一些绝大部分的场景下,sparkStreaming是可以取代掉strom的
实时性,容错都比sparkstreamming优秀
和sparkstreaming相比之下不足的地方:
吞吐量不如sparkstreaming,后者可以方便的和spark SQL ,sparkCore,sparkMLlib无缝的结合
7.spark开发语言的选择?
现如今关于spark的主流语言是scala,如果说是单纯的大数据项目,scala较其他语言相比更为合适一些,但是也有不足的地方:会scala 的人太少,第二点就是由于Scala和第三方的架构整合起来困难。
Java:如今最最主流的编程语言,整合第三方架构的时候也比较简单,如果用java来写spark的话,更为适合写一些比较复杂的大数据项目。
两者的相同之处在于:java可以把代码实现,scala也可以把代码实现
现在比较火的编程语言python,也可以用来开发spark,不过略有不同于其他两种语言的是,python更倾向于机器学习,即(sparkMLlib),因为python的库特别多,而机器学习的算法库也有很多,所以python更多的时间用于机器学习。
转载本文请和本文作者联系,本文来自博客园一袭白衣一
Spark学习笔记1(初始spark的更多相关文章
- Spark学习笔记2(spark所需环境配置
Spark学习笔记2 配置spark所需环境 1.首先先把本地的maven的压缩包解压到本地文件夹中,安装好本地的maven客户端程序,版本没有什么要求 不需要最新版的maven客户端. 解压完成之后 ...
- Spark学习笔记--Linux安装Spark集群详解
本文主要讲解如何在Linux环境下安装Spark集群,安装之前我们需要Linux已经安装了JDK和Scala,因为Spark集群依赖这些.下面就如何安装Spark进行讲解说明. 一.安装环境 操作系统 ...
- Spark学习笔记5:Spark集群架构
Spark的一大好处就是可以通过增加机器数量并使用集群模式运行,来扩展计算能力.Spark可以在各种各样的集群管理器(Hadoop YARN , Apache Mesos , 还有Spark自带的独立 ...
- Spark学习笔记1:Spark概览
Spark是一个用来实现快速而通用的集群计算的平台. Spark项目包含多个紧密集成的组件.Spark的核心是一个对由很多计算任务组成的,运行在多个工作机器或者是一个计算集群上的应用进行调度,分发以及 ...
- Spark学习笔记——构建基于Spark的推荐引擎
推荐模型 推荐模型的种类分为: 1.基于内容的过滤:基于内容的过滤利用物品的内容或是属性信息以及某些相似度定义,来求出与该物品类似的物品. 2.协同过滤:协同过滤是一种借助众包智慧的途径.它利用大量已 ...
- Spark学习笔记6:Spark调优与调试
1.使用Sparkconf配置Spark 对Spark进行性能调优,通常就是修改Spark应用的运行时配置选项. Spark中最主要的配置机制通过SparkConf类对Spark进行配置,当创建出一个 ...
- Spark 学习笔记之 MONGODB SPARK CONNECTOR 插入性能测试
MONGODB SPARK CONNECTOR 测试数据量: 测试结果: 116万数据通过4个表的join,从SQL Server查出,耗时1分多.MongoSparkConnector插入平均耗时: ...
- Spark学习笔记3——RDD(下)
目录 Spark学习笔记3--RDD(下) 向Spark传递函数 通过匿名内部类 通过具名类传递 通过带参数的 Java 函数类传递 通过 lambda 表达式传递(仅限于 Java 8 及以上) 常 ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
- Spark学习笔记之SparkRDD
Spark学习笔记之SparkRDD 一. 基本概念 RDD(resilient distributed datasets)弹性分布式数据集. 来自于两方面 ① 内存集合和外部存储系统 ② ...
随机推荐
- 基于阿里云的MQTT远程控制
好久没有写博客了,眼看自己的项目就要快做完了,先分享一下基于MQTT的远程控制,自己买了一个阿里的云端,然后在云端上安装了一个MQTT服务器,其实是一不小心买了两个,所以准备贡献出来一个供大家使用, ...
- 改造 Combo Select支持服务器端模糊搜索
项目中使用了 combo select,为缺省的select增加模糊搜索的功能,一直运行得很好. 1 碰到的问题 但最近碰到一个大数据量的select:初始化加载的数据项有2000多个.我们采用 ...
- ELK开机启动 service文件内容
为了实现ELK的3部分开机启动,可以添加各项服务对应的service文件,再通过systemctl enable XXX实现ELK所有服务开机启动. Elasticsearch elasticsear ...
- 用纯CSS实现的箭头
div+css实现带三角箭头提示框 链接:http://www.xuebuyuan.com/160534.html 链接:http://www.admin10000.com/document/4089 ...
- ES6(二) Destructuring-变量的解构赋值
1.解构的含义 允许按照一定的模式,从数组和对象中取值,对变量进行赋值,称为解构. 解构赋值时,只要等号右边的值不是对象,就先将其转换成对象. 本质上,这种写法属于 “模式匹配”,只要两边模式相同,左 ...
- Vue 爬坑之路(三)—— 使用 vue-router 跳转页面
使用 Vue.js 做项目的时候,一个页面是由多个组件构成的,所以在跳转页面的时候,并不适合用传统的 href,于是 vue-router 应运而生. 官方文档: https://router.vue ...
- sqlalchemy 踩过的坑
记录下Sqlalchemy遇到的问题,不定时更新. 设置主键为非自增 sqlalchemy 在sql server中默认主键是自增的,如果在数据库设置的主键不是自增的,这个时候插入就会出现异常: 提示 ...
- JS随机显示一张图片
var images=['p1.jpg','p2.jpg','p3.jpg']; var url=images[Math.floor(Math.random()*images.length)]; co ...
- form注册表单圆角 demo
form注册表单圆角 <BODY> <div class="form"> <ul class="list"> <li& ...
- MySQL 行锁 表锁机制
MySQL 表锁和行锁机制 行锁变表锁,是福还是坑?如果你不清楚MySQL加锁的原理,你会被它整的很惨!不知坑在何方?没事,我来给你们标记几个坑.遇到了可别乱踩.通过本章内容,带你学习MySQL的行锁 ...