
Java+大数据开发——Hadoop集群环境搭建(二)
| 1. MAPREDUCE使用 |
mapreduce是hadoop中的分布式运算编程框架,只要按照其编程规范,只需要编写少量的业务逻辑代码即可实现一个强大的海量数据并发处理程序
| 2. Demo开发——wordcount |
2.1需求
从大量(比如T级别)文本文件中,统计出每一个单词出现的总次数。
2.2mapreduce 实现思路
Map阶段:
a) 从HDFS的源数据文件中逐行读取数据
b) 将每一行数据切分出单词
c) 为每一个单词构造一个键值对(单词,1)
d) 将键值对发送给reduce
Reduce阶段:
a) 接收map阶段输出的单词键值对
b) 将相同单词的键值对汇聚成一组
c) 对每一组,遍历组中的所有“值”,累加求和,即得到每一个单词的总次数
d) 将(单词,总次数)输出到HDFS的文件中
2.3具体编码实现
(1)定义一个mapper类
//首先要定义四个泛型的类型

//keyin:  LongWritable    valuein: Text

//keyout: Text            valueout:IntWritable

public class WordCountMapper extends Mapper<LongWritable, Text, Text, IntWritable>{

    //map方法的生命周期:  框架每传一行数据就被调用一次

    //key :  这一行的起始点在文件中的偏移量

    //value: 这一行的内容

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        //拿到一行数据转换为string

        String line = value.toString();

//将这一行切分出各个单词

        String[] words = line.split(" ");

        //遍历数组,输出<单词,1>

        for(String word:words){

            context.write(new Text(word), new IntWritable(1));

        }

    }

}
(2)定义一个reducer类
//生命周期:框架每传递进来一个kv 组,reduce方法被调用一次

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

        //定义一个计数器

        int count = 0;

        //遍历这一组kv的所有v,累加到count中

        for(IntWritable value:values){

            count += value.get();

        }

        context.write(key, new IntWritable(count));

    }

}
(3)定义一个主类,用来描述job并提交job
public class WordCountRunner {

    //把业务逻辑相关的信息(哪个是mapper,哪个是reducer,要处理的数据在哪里,输出的结果放哪里。。。。。。)描述成一个job对象

    //把这个描述好的job提交给集群去运行

    public static void main(String[] args) throws Exception {

        Configuration conf = new Configuration();

        Job wcjob = Job.getInstance(conf);

        //指定我这个job所在的jar包

//        wcjob.setJar("/home/hadoop/wordcount.jar");

        wcjob.setJarByClass(WordCountRunner.class);

        wcjob.setMapperClass(WordCountMapper.class);

        wcjob.setReducerClass(WordCountReducer.class);

        //设置我们的业务逻辑Mapper类的输出key和value的数据类型

        wcjob.setMapOutputKeyClass(Text.class);

        wcjob.setMapOutputValueClass(IntWritable.class);

        //设置我们的业务逻辑Reducer类的输出key和value的数据类型

        wcjob.setOutputKeyClass(Text.class);

        wcjob.setOutputValueClass(IntWritable.class);

//指定要处理的数据所在的位置

        FileInputFormat.setInputPaths(wcjob, "hdfs://hdp-server01:9000/wordcount/data/big.txt");

        //指定处理完成之后的结果所保存的位置

        FileOutputFormat.setOutputPath(wcjob, new Path("hdfs://hdp-server01:9000/wordcount/output/"));

        //向yarn集群提交这个job

        boolean res = wcjob.waitForCompletion(true);

        System.exit(res?0:1);

    }
| 3.程序打包运行 |
1. 将程序打包
2. 准备输入数据
vi /home/hadoop/test.txt
Hello tom

Hello jim

Hello ketty

Hello world

Ketty tom
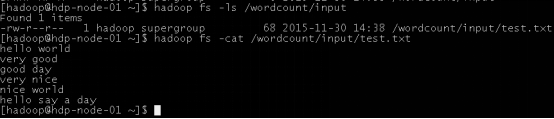
在hdfs上创建输入数据文件夹:
hadoop fs mkdir -p /wordcount/input
将words.txt上传到hdfs上
hadoop fs –put /home/hadoop/words.txt /wordcount/input
3. 将程序jar包上传到集群的任意一台服务器上
4. 使用命令启动执行wordcount程序jar包
$ hadoop jar wordcount.jar cn.itcast.bigdata.mrsimple.WordCountDriver /wordcount/input /wordcount/out

5. 查看执行结果
$ hadoop fs –cat /wordcount/out/part-r-00000

出处:http://www.cnblogs.com/jerehedu/
版权声明:本文版权归烟台杰瑞教育科技有限公司和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。
技术咨询:

Java+大数据开发——Hadoop集群环境搭建(二)的更多相关文章
- Java+大数据开发——Hadoop集群环境搭建(一)
1集群简介 HADOOP集群具体来说包含两个集群:HDFS集群和YARN集群,两者逻辑上分离,但物理上常在一起 HDFS集群: 负责海量数据的存储,集群中的角色主要有 NameNode / DataN ...
- 大数据测试之hadoop集群配置和测试
大数据测试之hadoop集群配置和测试 一.准备(所有节点都需要做):系统:Ubuntu12.04java版本:JDK1.7SSH(ubuntu自带)三台在同一ip段的机器,设置为静态IP机器分配 ...
- 朝花夕拾之--大数据平台CDH集群离线搭建
body { border: 1px solid #ddd; outline: 1300px solid #fff; margin: 16px auto; } body .markdown-body ...
- hadoop集群环境搭建之安装配置hadoop集群
在安装hadoop集群之前,需要先进行zookeeper的安装,请参照hadoop集群环境搭建之zookeeper集群的安装部署 1 将hadoop安装包解压到 /itcast/ (如果没有这个目录 ...
- Hadoop集群环境搭建步骤说明
Hadoop集群环境搭建是很多学习hadoop学习者或者是使用者都必然要面对的一个问题,网上关于hadoop集群环境搭建的博文教程也蛮多的.对于玩hadoop的高手来说肯定没有什么问题,甚至可以说事“ ...
- hadoop集群环境搭建之zookeeper集群的安装部署
关于hadoop集群搭建有一些准备工作要做,具体请参照hadoop集群环境搭建准备工作 (我成功的按照这个步骤部署成功了,经实际验证,该方法可行) 一.安装zookeeper 1 将zookeeper ...
- hadoop集群环境搭建准备工作
一定要注意hadoop和linux系统的位数一定要相同,就是说如果hadoop是32位的,linux系统也一定要安装32位的. 准备工作: 1 首先在VMware中建立6台虚拟机(配置默认即可).这是 ...
- 大数据 -- Hadoop集群环境搭建
首先我们来认识一下HDFS, HDFS(Hadoop Distributed File System )Hadoop分布式文件系统.它其实是将一个大文件分成若干块保存在不同服务器的多个节点中.通过联网 ...
- Spark集群环境搭建——Hadoop集群环境搭建
Spark其实是Hadoop生态圈的一部分,需要用到Hadoop的HDFS.YARN等组件. 为了方便我们的使用,Spark官方已经为我们将Hadoop与scala组件集成到spark里的安装包,解压 ...
随机推荐
- 一小时学会ECMAScript6新特性
ECMAScript 简介 简称es,是一套标准,javascript就是使用这套标准的语言.主流的浏览器使用的是ECAMScript5,ECAMScript6(ECAMScript2015)是一涛新 ...
- SpringBoot实战总汇--详解
简介 Spring 诞生时是 Java 企业版(Java Enterprise Edition,JEE,也称 J2EE)的 轻量级代替品.无需开发重量级的 Enterprise JavaBean(EJ ...
- spring容器注入一个接口的两个实现类
spring容器中能拥有两个同种类型的bean吗?我有两个dao类同时实现一个接口,这两个接口注入时报了异常如下. org.springframework.beans.factory.NoSuchBe ...
- curl---一款实用的URL命令行网络通讯工具/库
最近一段时间在看朴灵翻译的<深入浅出nodejs>,里面有提到一种脱离浏览器的客户端网络通讯工具,curl命令,自己在电脑上试了一下,感觉非常好用,而且莫名的感觉这是一个非常强大的网络工具 ...
- 微信小程序(有始有终,全部代码)开发--- 新增模块: 图片选取以及拍照功能
开篇语 前几天发了一篇: <简年15: 微信小程序(有始有终,全部代码)开发---跑步App+音乐播放器 > 后来又发了BUG修复的版本: 简年18: 微信小程序(有始有终,全部代码)开发 ...
- 普通程序员如何入门AI
毫无疑问,人工智能是目前整个互联网领域最火的行业,随着AlphaGo战胜世界围棋冠军,以及各种无人驾驶.智能家居项目的布道,人们已经意识到了AI就是下一个风口.当然,程序员是我见过对于新技术最敏感的一 ...
- 用ubuntu的grpb2引导Remix OS
Remix OS游戏版,这里下载:http://youxi.jide.com/ 安装简单.我这里要解决的是安装后用ubunu的grub2菜单去引导它. 方法如下: 进入ubuntu系统里修改其grub ...
- Android NDK Application.mk(中文翻译)
作者:阿宝 更新:2016-08-31 来源:彩色世界(https://blog.hz601.org/2016/07/26/android-NDK-application-mk/index.html) ...
- 在配置wem.xml后,Tomcat遇到问题,启动失败的解决方法
前两天在写程序时,碰到了Tomcat无法启动的问题,就是在配置完web.xml后.想必好多小伙伴都有遇到吧. 如图: 出现这个错误的原因是:在配置web.xml的时候出现了错误! 如图所示,没有修改这 ...
- perl的正则表达式
“小骆驼”的“正则表达式“部分学习总结: 一.匹配语法: 1.".":任意单字符(‘\n‘除外): 2.“*“:匹配前项0-n次: 3.“+“:匹配前项1-n次: 4.“?”:匹配 ...