
编写爬虫程序的神器 - Groovy + Jsoup + Sublime(转)
写过很多个爬虫小程序了,之前几次主要用C# + Html Agility Pack来完成工作。由于.NET FCL只提供了"底层"的HttpWebRequest和"中层"的WebClient,故对HTTP操作还是需要编写很多代码的。加上编写C#需要使用Visual Studio这个很"重"的工具,开发效率长期以来处于一种低下的状态。
最近项目里面接触到了一种神奇的语言Groovy -- 一种全面兼容Java语言且提供了大量额外语法功能的动态语言。加上网络上有开源的Jsoup项目 -- 一个轻量级的使用CSS选择器来解析HTML内容的类库,这样的组合编写爬虫简直如沐春风。
抓cnblogs首页新闻标题的脚本
Jsoup.connect("http://cnblogs.com").get().select("#post_list > div > div.post_item_body > h3 > a").each {

    println it.text()

}
output

抓cnblogs首页新闻详细信息

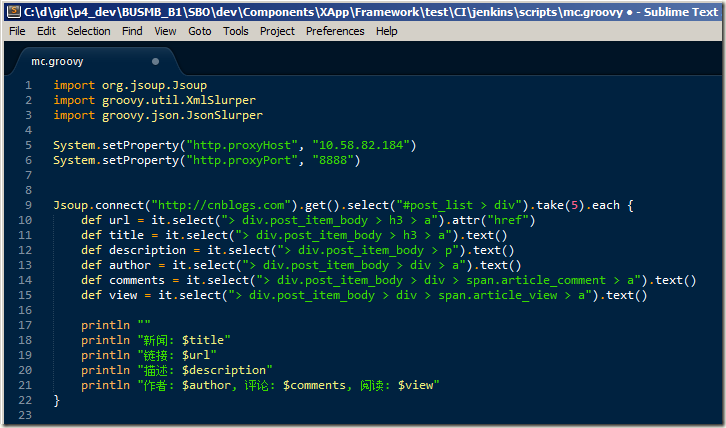
Jsoup.connect("http://cnblogs.com").get().select("#post_list > div").take(5).each {
def url = it.select("> div.post_item_body > h3 > a").attr("href")
def title = it.select("> div.post_item_body > h3 > a").text()
def description = it.select("> div.post_item_body > p").text()
def author = it.select("> div.post_item_body > div > a").text()
def comments = it.select("> div.post_item_body > div > span.article_comment > a").text()
def view = it.select("> div.post_item_body > div > span.article_view > a").text()
println ""
println "新闻: $title"
println "链接: $url"
println "描述: $description"
println "作者: $author, 评论: $comments, 阅读: $view"
}
output

怎么样,很方便是吧。是不是找到一种编写前端JavaScript和jQuery代码的感觉,那就对了!
这里说一个窍门,编写CSS选择器的时候可以借助Google Chrome浏览器的开发工具,如图:

再来看看Groovy是如何快速处理JSON和XML的。一句话:方便到家。
抓cnblogs的feeds
new XmlSlurper().parse("http://feed.cnblogs.com/blog/sitehome/rss").with { xml ->
def title = xml.title.text()
def subtitle = xml.subtitle.text()
def updated = xml.updated.text()
println "feeds"
println "title -> $title"
println "subtitle -> $subtitle"
println "updated -> $updated"
def entryList = xml.entry.take(3).collect {
def id = it.id.text()
def subject = it.title.text()
def summary = it.summary.text()
def author = it.author.name.text()
def published = it.published.text()
[id, subject, summary, author, published]
}.each {
println ""
println "article -> ${it[1]}"
println it[0]
println "author -> ${it[3]}"
}
}
output

抓msdn订阅的产品分类信息
new JsonSlurper().parse(new URL("http://msdn.microsoft.com/en-us/subscriptions/json/GetProductCategories?brand=MSDN&localeCode=en-us")).with { rs ->
println rs.collect{ it.Name }
}
output

再说一下代码编辑器。本方案由于使用Groovy这门动态语言,故可以选择一种轻量级的文本编辑器,这里要推荐Sublime。其中文翻译是“高大尚”的意思。从这个小小的文本编辑器所表现出来的丰富功能和极佳的用户体验来看,也确实对得起这个名字了。
优点:
- 轻量级(客户端6m)
- 支持各种语言的着色,包括Groovy
- 自定义主题包(颜色表)
- 列编辑
- 快速选择,扩展选择等
缺点:
- 不免费,不开源。好在试用版可以无限制使用,只是保存操作时偶尔弹出对话框
最后,分享一段抓取搜房网二手房信息的快速脚本
http://noria.codeplex.com/SourceControl/latest#miles/soufun/soufun.groovy
抓取整理后效果图

行文至此,希望对爬虫感兴趣的朋友们有所帮助。
http://www.cnblogs.com/stainboy/p/make-crawler-with-groovy-and-jsoup.html
编写爬虫程序的神器 - Groovy + Jsoup + Sublime(转)的更多相关文章
- 编写爬虫程序的神器 - Groovy + Jsoup + Sublime
写过很多个爬虫小程序了,之前几次主要用C# + Html Agility Pack来完成工作.由于.NET BCL只提供了"底层"的HttpWebRequest和"中层& ...
- 自动编写Python程序的神器,Python 之父都发声力挺!
就在不久前,kite——那个能够自己编写python代码的AI,Python 之父 Guido van Rossum 使用之后,也发出了「really love」感叹,向大家墙裂推荐了这一高效工具 ...
- 使用Scrapy编写爬虫程序中遇到的问题及解决方案记录
1.创建与域名不一致的Request时,请求会报错 解决方法:创建时Request时加上参数dont_filter=True 2.当遇到爬取失败(对方反爬检测或网络问题等)时,重试,做法为在解析res ...
- Android网络爬虫程序(基于Jsoup)
摘要:基于 Jsoup 实现一个 Android 的网络爬虫程序,抓取网页的内容并显示出来.写这个程序的主要目的是抓取海投网的宣讲会信息(公司.时间.地点)并在移动端显示,这样就可以随时随地的浏览在学 ...
- 为编写网络爬虫程序安装Python3.5
1. 下载Python3.5.1安装包1.1 进入python官网,点击menu->downloads,网址:https://www.python.org/downloads/ 1.2 根据系统 ...
- 【C/C++】用C语言编写爬虫—爬虫程序优化要点
写一个网络爬虫 用C语言来写一个网络爬虫,来获取一个网站上感兴趣的信息,抓取自己需要的一切. #include<cspider/spider.h>/* 自定义的解析函数,d为获取到的h ...
- python爬虫__第一个爬虫程序
前言 机缘巧合,最近在学习机器学习实战, 本来要用python来做实验和开发环境 得到一个需求,要爬取大众点评中的一些商户信息, 于是开启了我的第一个爬虫的编写,里面有好多心酸,主要是第一次. 我的文 ...
- 开发记录_自学Python写爬虫程序爬取csdn个人博客信息
每天刷开csdn的博客,看到一整个页面,其实对我而言,我只想看看访问量有没有上涨而已... 于是萌生了一个想法: 想写一个爬虫程序把csdn博客上边的访问量和评论数都爬下来. 打算通过网络各种搜集资料 ...
- webmagic学习-使用注解编写爬虫
写在前面: 官方文档:http://webmagic.io/docs/zh/posts/ch5-annotation/README.html WebMagic支持使用独有的注解风格编写一个爬虫,引入w ...
随机推荐
- Android版本铎A梦幻连连看游戏源代码完整版
我写主代码,没有版权问题,它少量小游戏和应用源代码稍后会陆续上线!哆啦A梦连连看包含了2种游戏模式和60关卡,并能够通过改动配置文件非常方便的实现自行添加新关卡.採用andengine游戏引擎开发,内 ...
- html弹窗,与弹出对话框
弹出对话框 <script type="text/JavaScript"> <!-- alert("Good Morning!"); //al ...
- windows下cocos2dx3.0开发环境及Android编译环境搭建
cocos2dx更新到了3.x版本号,自己一直没有换,如今开发组要求统一换版本号,我就把搭建好开发环境的过程记录下来. 一.Windowns下开发环境搭建 1. 所需工具 1)coc ...
- MySQL的create table as 与 like区别(转)
对于mysql的复制相同表结构方法,有create table as 和create table like 两种,区别是什么呢? create table t2 as select * from t1 ...
- 【剑指offer】q50:树节点最近的祖先
#@ root: the root of searched tree #@ nodeToFind: the tree-node to be found #@ path: the path from r ...
- 用MODELLER构建好模型后对loop区域进行自动的优化过程
一:对生成的模型的所有的loop区域进行优化 # Homology modeling by the automodel class from modeller import * from modell ...
- [Python网络编程]gevent httpclient以及网页编码
之前看到geventhttpclient这个项目,https://github.com/gwik/geventhttpclient,官方文档说非常快,因为响应使用了C的解析,所以我一直想把这玩意用到项 ...
- SharePoint 2010 新列表模板列表
SharePoint 2010 新列表模板列表 项目描述叙事 发展环境创造了良好的名单为模板.然后使用列表模板将其复制到生产环境. 脚步 1. 打开"列表设置",找到"将 ...
- 左右PHP自增力、神秘递减操作
首先看一个面试题: $a = 1; $b = &$a; if ($b == $a++) echo "true"; else echo "false"; ...
- 【Nginx】开发一个简单的HTTP模块
首先来分析一下HTTP模块是怎样介入Nginx的. 当master进程fork出若干个workr子进程后,每一个worker子进程都会在自己的for死循环中不断调用事件模块: for ( ;; ) { ...