
Logstash学习之路(五)使用Logstash抽取mysql数据到kakfa
一、Logstash对接kafka测通
说明:
由于我这里kafka是伪分布式,且kafka在伪分布式下,已经集成了zookeeper。
1、先将zk启动,如果是在伪分布式下,kafka已经集成了zk
[root@master zookeeperData]# nohup /mnt/kafka/bin/zookeeper-server-start.sh /mnt/kafka/config/zookeeper.properties &
2、启动broker
[root@master mnt]# nohup /mnt/kafka/bin/kafka-server-start.sh /mnt/kafka/config/server.properties &
3、创建topic
[root@master bin]# ./kafka-topics.sh --create --zookeeper 192.168.200.100:2181 --topic test --partition 1 --replication-factor 1

Created topic "test".
4、创建消费者
[root@master bin]# ./kafka-console-consumer.sh --topic test --zookeeper localhost:2181
5、配置Logstash对接kafka的配置文件
input{

    stdin{}

}

output{

    kafka{

        topic_id => "test"

        bootstrap_servers => "192.168.200.100:9092" # kafka的地址

       # batch_size => 5

    }

    stdout{

        codec => rubydebug

    }

}
6、测试
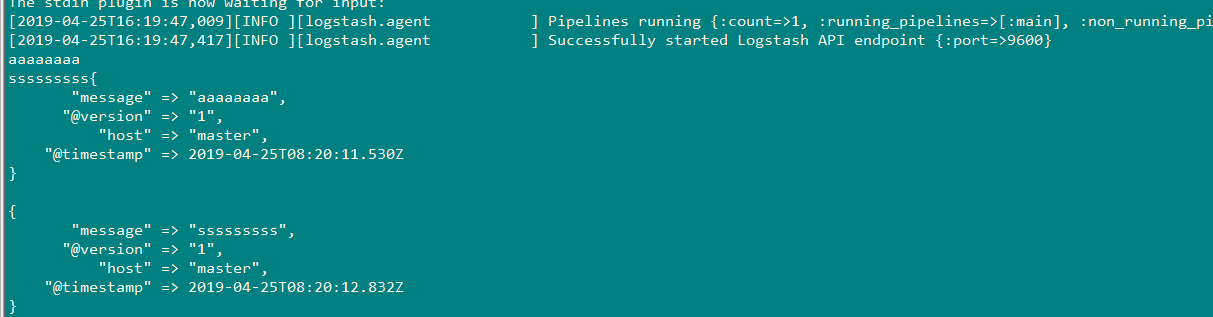
启动日志:
[root@master bin]# ./logstash -f kafka.conf

Sending Logstash's logs to /mnt/logstash/logs which is now configured via log4j2.properties

[2019-04-25T16:19:38,811][WARN ][logstash.config.source.multilocal] Ignoring the 'pipelines.yml' file because modules or command line options are specified

[2019-04-25T16:19:40,075][INFO ][logstash.runner          ] Starting Logstash {"logstash.version"=>"6.3.1"}

[2019-04-25T16:19:46,274][INFO ][logstash.pipeline        ] Starting pipeline {:pipeline_id=>"main", "pipeline.workers"=>2, "pipeline.batch.size"=>125, "pipeline.batch.delay"=>50}

[2019-04-25T16:19:46,583][INFO ][org.apache.kafka.clients.producer.ProducerConfig] ProducerConfig values:

        acks = 1

        batch.size = 16384

        bootstrap.servers = [192.168.200.100:9092]

        buffer.memory = 33554432

        client.id =

        compression.type = none

        connections.max.idle.ms = 540000

        enable.idempotence = false

        interceptor.classes = []

        key.serializer = class org.apache.kafka.common.serialization.StringSerializer

        linger.ms = 0

        max.block.ms = 60000

        max.in.flight.requests.per.connection = 5

        max.request.size = 1048576

        metadata.max.age.ms = 300000

        metric.reporters = []

        metrics.num.samples = 2

        metrics.recording.level = INFO

        metrics.sample.window.ms = 30000

        partitioner.class = class org.apache.kafka.clients.producer.internals.DefaultPartitioner

        receive.buffer.bytes = 32768

        reconnect.backoff.max.ms = 10

        reconnect.backoff.ms = 10

        request.timeout.ms = 30000

        retries = 0

        retry.backoff.ms = 100

        sasl.jaas.config = null

        sasl.kerberos.kinit.cmd = /usr/bin/kinit

        sasl.kerberos.min.time.before.relogin = 60000

        sasl.kerberos.service.name = null

        sasl.kerberos.ticket.renew.jitter = 0.05

        sasl.kerberos.ticket.renew.window.factor = 0.8

        sasl.mechanism = GSSAPI

        security.protocol = PLAINTEXT

        send.buffer.bytes = 131072

        ssl.cipher.suites = null

        ssl.enabled.protocols = [TLSv1.2, TLSv1.1, TLSv1]

        ssl.endpoint.identification.algorithm = null

        ssl.key.password = null

        ssl.keymanager.algorithm = SunX509

        ssl.keystore.location = null

        ssl.keystore.password = null

        ssl.keystore.type = JKS

        ssl.protocol = TLS

        ssl.provider = null

        ssl.secure.random.implementation = null

        ssl.trustmanager.algorithm = PKIX

        ssl.truststore.location = null

        ssl.truststore.password = null

        ssl.truststore.type = JKS

        transaction.timeout.ms = 60000

        transactional.id = null

        value.serializer = class org.apache.kafka.common.serialization.StringSerializer

[2019-04-25T16:19:46,705][INFO ][org.apache.kafka.common.utils.AppInfoParser] Kafka version : 1.1.0

[2019-04-25T16:19:46,706][INFO ][org.apache.kafka.common.utils.AppInfoParser] Kafka commitId : fdcf75ea326b8e07

[2019-04-25T16:19:46,854][INFO ][logstash.pipeline        ] Pipeline started successfully {:pipeline_id=>"main", :thread=>"#<Thread:0x11d30400 run>"}

The stdin plugin is now waiting for input:

[2019-04-25T16:19:47,009][INFO ][logstash.agent           ] Pipelines running {:count=>1, :running_pipelines=>[:main], :non_running_pipelines=>[]}

[2019-04-25T16:19:47,417][INFO ][logstash.agent           ] Successfully started Logstash API endpoint {:port=>9600}

二、使用Logstash抽取mysql数据到kafka
配置文件:
input {

        stdin {}

        jdbc {

                type => "jdbc"

                jdbc_connection_string => "jdbc:mysql://192.168.200.100:3306/yang?characterEncoding=UTF-8&autoReconnect=true"

                 # 数据库连接账号密码;

                jdbc_user => "root"

                jdbc_password => "010209"

                 # MySQL依赖包路径;

                jdbc_driver_library => "/mnt/mysql-connector-java-5.1.38.jar"

                 # the name of the driver class for mysql

                jdbc_driver_class => "com.mysql.jdbc.Driver"

                statement => "SELECT * FROM `im`"

        }

}

output {

        kafka{

                 topic_id => "test"

                 bootstrap_servers => "192.168.200.100:9092" # kafka的地址

                 batch_size => 5

        }

        stdout {

        }

}
Logstash学习之路(五)使用Logstash抽取mysql数据到kakfa的更多相关文章
- Logstash学习之路(四)使用Logstash将mysql数据导入elasticsearch(单表同步、多表同步、全量同步、增量同步)
一.使用Logstash将mysql数据导入elasticsearch 1.在mysql中准备数据: mysql> show tables; +----------------+ | Table ...
- logstash使用template提前设置好maping同步mysql数据到Elasticsearch5.5.2
上篇blog说到采用logstash-input-jdbc将mysql数据同步到ES(http://www.cnblogs.com/jstarseven/p/7704893.html),但是这里有一个 ...
- Logstash学习之路(一)Logstash的安装
一.Logstash简介 Logstash 是一个实时数据收集引擎,可收集各类型数据并对其进行分析,过滤和归纳.按照自己条件分析过滤出符合数据导入到可视化界面.它可以实现多样化的数据源数据全量或增量传 ...
- Logstash学习之路(二)Elasticsearch导入json数据文件
一.数据从文件导入elasticsearch 1.数据准备: 1.数据文件:test.json 2.索引名称:index 3.数据类型:doc 4.批量操作API:bulk {"index& ...
- Logstash学习之路(三)Logstash处理时区、类型转换、删除字段的案例配置
#输入 input { file { path => ["文件路径"] #自定义类型 type => "自定义" start_position =& ...
- redis——学习之路五(简单的C#使用redis)
redis官方推荐使用的客户端程序 打星星表示推荐使用的客户端程序,一个笑脸表示最近6个月内有过正式活动的.http://redis.io/clients/#c 从这里我们可以判断官方推荐我们使用Se ...
- zigbee学习之路(五):定时器1(查询方式)
一.前言 今天,我们来学习几乎所有单片机都有的功能,定时器的使用,定时器对单片机来说是相当重要的,有了它,单片机就可以进行一些复杂的工作. 二.原理与分析 谈到定时器的控制,我们最先想到的是要给它赋初 ...
- MongoDB学习之路(五)
MongoDB $type 操作符 类型 数字 备注 Double 1 String 2 Object 3 Array 4 Binary data 5 Undefined 6 已废弃 Object i ...
- Java学习之路(五):常见的对象操作
Object对象 我们先来介绍一下API API(Application Programming Interface):应用程序编程接口 Java API 就是Java提供给我们使用的类,这些类将底层 ...
随机推荐
- PyQt(Python+Qt)学习随笔:Qt Designer中toolBar的orientation属性和iconSize属性
orientation属性 orientation属性用于确认工具栏是水平方向还是垂直方向,这个属性对于QMainWindow中的工具栏来说没有意义,因为QMainWindow中的工具栏支持在上下左右 ...
- PyQt(Python+Qt)学习随笔:Designer中PushButton按钮flat属性
flat属性用于确认按钮边框是否凸起,如果为False则凸起,如果为True则边框与背景是平坦的. 默认值为False,如果设置为True,则除非按下按钮,否则大多数样式都不会绘制按钮背景.通过使用s ...
- 基于CefSharp开发(六)浏览器网页缩放
一.网页缩放分析 缩放入口 1.Ctrl + 鼠标滑轮缩放 2.菜单中缩放子菜单缩放 3.搜索框中网页缩放按钮缩放 缩放属性及命令 ChromiumWebBrowser 提供了缩放量值.缩放级别.放大 ...
- 一些vue项目
https://segmentfault.com/a/1190000010330905
- NOI2020网上同步赛 游记
Day1 预计得分:\(32pts\)(我裂开了--) T1 美食家 表示考试的时候想到了关于矩阵快速幂的想法,甚至连分段后怎么处理都想好了,但是没有想到拆点,还有不知道怎么处理重边(这个考虑是多余的 ...
- AcWing 361. 观光奶牛
01规划 设答案为 \(ans\). 二分答案,设当前二分值为 \(mid\). 设一个环 \(S\) 的边权为 \(t_1, t_2, t_3...\),点权为 \(f_1, f_2, f_3... ...
- Reflect个人记录
Reflect是一个内置方法,并不能通过构造函数的来进行构建 Reflect.construct: 与new操作父有一些类似,相当于new target(...) 例: 我们先自己定义一个类 clas ...
- KafkaMirrorMaker 的不足以及一些改进
背景 某系统使用 Kafka 存储实时的行情数据,为了保证数据的实时性,需要在多地机房维护多个 Kafka 集群,并将行情数据同步到这些集群上. 一个常用的方案就是官方提供的 KafkaMirrorM ...
- postgresql 运行sql文件
方法一: [postgres@node01 ~]$ psql -Upostgres postgres=# \l List of databases Name | Owner | Encoding | ...
- vue 重置data
Object.assign(this.$data, this.$options.data())