
机器学习实战基础(十):sklearn中的数据预处理和特征工程(三) 数据预处理 Preprocessing & Impute 之 缺失值
缺失值
机器学习和数据挖掘中所使用的数据,永远不可能是完美的。很多特征,对于分析和建模来说意义非凡,但对于实际收集数据的人却不是如此,因此数据挖掘之中,常常会有重要的字段缺失值很多,但又不能舍弃字段的情况。因此,数据预处理中非常重要的一项就是处理缺失值。
import pandas as pd

data = pd.read_csv(r"C:\work\learnbetter\micro-class\

                    week 3 Preprocessing\Narrativedata.csv",index_col=0)

data.head()
这里,我们使用从泰坦尼克号提取出来的数据,这个数据有三个特征,一个数值型,两个字符型,标签也是字符型。从这里开始,我们就使用这个数据给大家作为例子,让大家慢慢熟悉sklearn中数据预处理的各种方式。
impute.SimpleImputer
class sklearn.impute.SimpleImputer (missing_values=nan, strategy=’mean’, fill_value=None, verbose=0,

copy=True)
这个类是专门用来填补缺失值的。它包括四个重要参数:
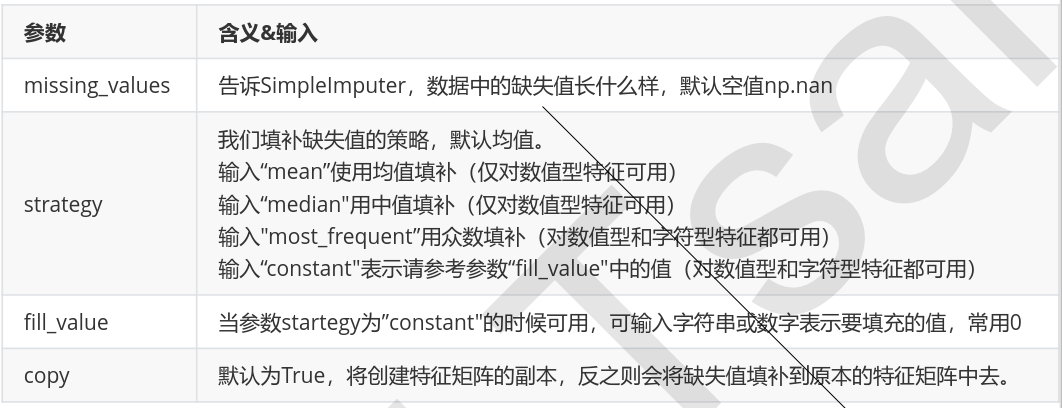
data.info()

#填补年龄

Age = data.loc[:,"Age"].values.reshape(-1,1)            #sklearn当中特征矩阵必须是二维

Age[:20]

from sklearn.impute import SimpleImputer

imp_mean = SimpleImputer()                              #实例化,默认均值填补

imp_median = SimpleImputer(strategy="median")           #用中位数填补

imp_0 = SimpleImputer(strategy="constant",fill_value=0) #用0填补

imp_mean = imp_mean.fit_transform(Age)                  #fit_transform一步完成调取结果

imp_median = imp_median.fit_transform(Age)

imp_0 = imp_0.fit_transform(Age)

imp_mean[:20]

imp_median[:20]

imp_0[:20]

#在这里我们使用中位数填补Age

data.loc[:,"Age"] = imp_median

data.info()

#使用众数填补Embarked

Embarked = data.loc[:,"Embarked"].values.reshape(-1,1)

imp_mode = SimpleImputer(strategy = "most_frequent")

data.loc[:,"Embarked"] = imp_mode.fit_transform(Embarked)

data.info()
BONUS:用Pandas和Numpy进行填补其实更加简单
import pandas as pd

data = pd.read_csv(r"C:\work\learnbetter\micro-class\week 3

Preprocessing\Narrativedata.csv",index_col=0)

data.head()

data.loc[:,"Age"] = data.loc[:,"Age"].fillna(data.loc[:,"Age"].median())

#.fillna 在DataFrame里面直接进行填补

data.dropna(axis=0,inplace=True)

#.dropna(axis=0)删除所有有缺失值的行,.dropna(axis=1)删除所有有缺失值的列

#参数inplace,为True表示在原数据集上修改,为False生成一个复制对象,不改变原来的值,默认False
机器学习实战基础(十):sklearn中的数据预处理和特征工程(三) 数据预处理 Preprocessing & Impute 之 缺失值的更多相关文章
- 机器学习实战基础(八):sklearn中的数据预处理和特征工程(一)简介
1 简介 数据挖掘的五大流程: 1. 获取数据 2. 数据预处理 数据预处理是从数据中检测,纠正或删除损坏,不准确或不适用于模型的记录的过程 可能面对的问题有:数据类型不同,比如有的是文字,有的是数字 ...
- sklearn中的数据预处理和特征工程
小伙伴们大家好~o( ̄▽ ̄)ブ,沉寂了这么久我又出来啦,这次先不翻译优质的文章了,这次我们回到Python中的机器学习,看一下Sklearn中的数据预处理和特征工程,老规矩还是先强调一下我的开发环境是 ...
- 机器学习实战基础(十四):sklearn中的数据预处理和特征工程(七)特征选择 之 Filter过滤法(一) 方差过滤
Filter过滤法 过滤方法通常用作预处理步骤,特征选择完全独立于任何机器学习算法.它是根据各种统计检验中的分数以及相关性的各项指标来选择特征 1 方差过滤 1.1 VarianceThreshold ...
- 机器学习实战基础(十八):sklearn中的数据预处理和特征工程(十一)特征选择 之 Wrapper包装法
Wrapper包装法 包装法也是一个特征选择和算法训练同时进行的方法,与嵌入法十分相似,它也是依赖于算法自身的选择,比如coef_属性或feature_importances_属性来完成特征选择.但不 ...
- 机器学习实战基础(十七):sklearn中的数据预处理和特征工程(十)特征选择 之 Embedded嵌入法
Embedded嵌入法 嵌入法是一种让算法自己决定使用哪些特征的方法,即特征选择和算法训练同时进行.在使用嵌入法时,我们先使用某些机器学习的算法和模型进行训练,得到各个特征的权值系数,根据权值系数从大 ...
- 机器学习实战基础(十五):sklearn中的数据预处理和特征工程(八)特征选择 之 Filter过滤法(二) 相关性过滤
相关性过滤 方差挑选完毕之后,我们就要考虑下一个问题:相关性了. 我们希望选出与标签相关且有意义的特征,因为这样的特征能够为我们提供大量信息.如果特征与标签无关,那只会白白浪费我们的计算内存,可能还会 ...
- 机器学习实战基础(二十):sklearn中的降维算法PCA和SVD(一) 之 概述
概述 1 从什么叫“维度”说开来 我们不断提到一些语言,比如说:随机森林是通过随机抽取特征来建树,以避免高维计算:再比如说,sklearn中导入特征矩阵,必须是至少二维:上周我们讲解特征工程,还特地提 ...
- 机器学习实战基础(十一):sklearn中的数据预处理和特征工程(四) 数据预处理 Preprocessing & Impute 之 处理分类特征:编码与哑变量
处理分类特征:编码与哑变量 在机器学习中,大多数算法,譬如逻辑回归,支持向量机SVM,k近邻算法等都只能够处理数值型数据,不能处理文字,在sklearn当中,除了专用来处理文字的算法,其他算法在fit的 ...
- 机器学习实战基础(九):sklearn中的数据预处理和特征工程(二) 数据预处理 Preprocessing & Impute 之 数据无量纲化
1 数据无量纲化 在机器学习算法实践中,我们往往有着将不同规格的数据转换到同一规格,或不同分布的数据转换到某个特定分布的需求,这种需求统称为将数据“无量纲化”.譬如梯度和矩阵为核心的算法中,譬如逻辑回 ...
随机推荐
- PE文件介绍 (1)
PE文件介绍 PE文件主要是windows操作系统下使用的可执行文件格式,PE文件是指32位的可执行文件也叫做PE32,64位可执行文件叫做PE+或者PE32+ PE文件格式 种类 主扩展名 可执行类 ...
- 14.Django-JWT
一.基于JWT的Token登录认证 1. JWT简介 json Web Token(缩写JWT)是目前最流行的跨域认证解决方案 session登录的认证方案是看,用户从客户端传递用户名和密码登录信息, ...
- Head_First_Python(中文版)完整版PDF免费下载_百度云盘
Head_First_Python(中文版)完整版PDF免费下载_百度云盘 提取码:bjbg 本书特色 根据认知科学和学习理论的最新研究成果,这本书采用一种适合大脑的丰富格式娓娓道来,而不是长篇累牍地 ...
- 上海开发票/v电13543443967
关于事项:Iㄋ5一★4З44一★ㄋ9.б7开发票的准备资料必须要公司名称个人的话就用个人名字和身份证去税务柜台申请办理!公司的话要提供公司全称就是营业执照上的名称,纳税人税号,如果是开普通增值税发票的 ...
- 乌班图设置C++11
zsh: echo "alias g++='g++ -std=c++11'" >> ~/.zshrc source ~/.zshrc bash: echo " ...
- 【解读】TCP粘包拆包
一.TCP粘包.拆包图解 假设客户端分别发送了两个数据包D1和D2给服务端,由于服务端一次读取到字节数是不确定的,故可能存在以下四种情况: 1)服务端分两次读取到了两个独立的数据包,分别是D1和D2, ...
- Spring系列.SpEL表达式
Spring表达式语言 SpEL语言是一种强大的表达式语言,支持在运行时查询和操作对象.SpEL表达式不一定要创建IOC容器后才能使用.用户完全可以单独调用SpEL的API来独立的使用时SpEL表达式 ...
- 【转】HBase中Zookeeper,RegionServer,Master,Client之间关系
在2.0之前HDFS中只有一个NameNode,但对于在线的应用只有一个NameNode是不安全的,故在2.0中对NameNode进行抽象,抽象成NamService其下包含有多个NameNode,但 ...
- 如何在Vim中更改颜色和主题
大家好,我是良许. Vim是我们在Linux中非常常用的一款文本编辑器.Vim 是一款免费.开源的文本编辑器,它的功能和许多其他的文本编辑器大致相同,比如 Sublime 和 Notepad++ .V ...
- mackdown基础语法
目录 前言 二.Markdown基本语法 前言 由于有些语法无法在博客园展示,推荐使用Typora解锁全套,下载地址:https://www.typora.io/ Markdown是一种可以使用普通文 ...