
搜索引擎ElasticSearch系列(五): ElasticSearch2.4.4 IK中文分词器插件安装
一:IK分词器简介
IK Analyzer是一个开源的,基于java语言开发的轻量级的中文分词工具包。从2006年12月推出1.0版开始, IKAnalyzer已经推出了4个大版本。最初,它是以开源项目Luence为应用主体的,结合词典分词和文法分析算法的中文分词组件。从3.0版本开 始,IK发展为面向Java的公用分词组件,独立于Lucene项目,同时提供了对Lucene的默认优化实现。在2012版本中,IK实现了简单的分词 歧义排除算法,标志着IK分词器从单纯的词典分词向模拟语义分词衍化。
IK Analyzer 2012特性:
1.采用了特有的“正向迭代最细粒度切分算法“,支持细粒度和智能分词两种切分模式;
2.在系统环境:Core2 i7 3.4G双核,4G内存,window 7 64位, Sun JDK 1.6_29 64位 普通pc环境测试,IK2012具有160万字/秒(3000KB/S)的高速处理能力。
3.2012版本的智能分词模式支持简单的分词排歧义处理和数量词合并输出。
4.采用了多子处理器分析模式,支持:英文字母、数字、中文词汇等分词处理,兼容韩文、日文字符
5.优化的词典存储,更小的内存占用。支持用户词典扩展定义。特别的,在2012版本,词典支持中文,英文,数字混合词语。
二:默认standard分词器测试
1)启动es服务
2)打开浏览器输入: http://localhost:9200/_analyze?analyzer=standard&pretty=true&text=中华人民共和国
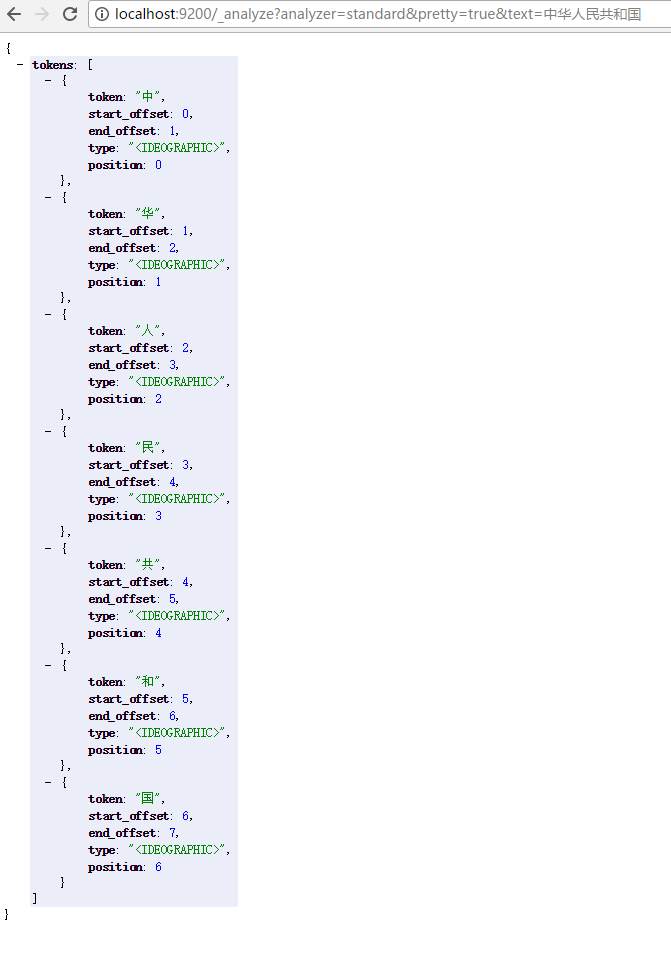
我们可以看到 “中华人民共和国” 被分成了单个汉字。
三:Ik中文分词器安装
插件下载: https://github.com/medcl/elasticsearch-analysis-ik
我们以1.10.4版本为例: http://files.cnblogs.com/files/sunyj/elasticsearch-analysis-ik-1.10.4.zip
1)在plugins文件夹下建ik文件夹
2)把下载的ik安装包解压后放到ik文件夹里,如下图:
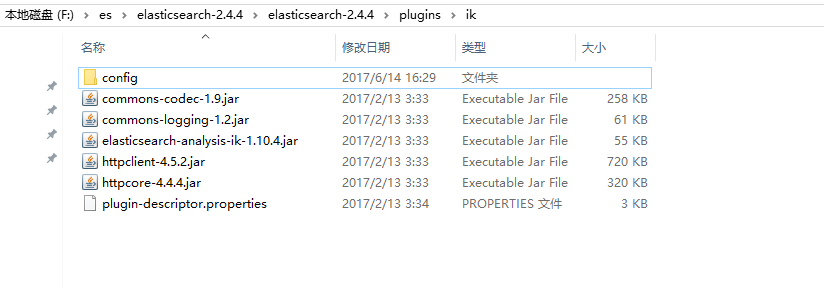
3)重新启动es服务
4)打开浏览器输入:http://localhost:9200/_analyze?analyzer=ik&pretty=true&text=中华人民共和国


我们可以看到用analyzer=ik “中华人民共和国”被按中文的习惯分成了多个词组
Tips:
我们再分别输入:
http://localhost:9200/_analyze?analyzer=ik_max_word&pretty=true&text=中华人民共和国国歌
http://localhost:9200/_analyze?analyzer=ik_smart&pretty=true&text=中华人民共和国国歌
ik_max_word: 会将文本做最细粒度的拆分,比如会将“中华人民共和国国歌”拆分为“中华人民共和国,中华人民,中华,华人,人民共和国,人民,人,民,共和国,共和,和,国国,国歌”,会穷尽各种可能的组合;
ik_smart: 会做最粗粒度的拆分,比如会将“中华人民共和国国歌”拆分为“中华人民共和国,国歌”。
四:Ik在索引中的使用
新建index索引
PUT index

{

    "settings": {

        "number_of_shards": 5

    },

    "mappings": {

        "fulltext": {

            "_all": {

                "analyzer": "ik_max_word",

                "search_analyzer": "ik_max_word",

                "term_vector": "no",

                "store": "false"

            },

            "properties": {

                "content": {

                    "type": "string",

                    "analyzer": "ik_max_word",

                    "search_analyzer": "ik_max_word",

                    "include_in_all": "true",

                    "boost": 8

                }

            }

        }

    }

}
插入一条数据
PUT /index/fulltext/1

{"content":"美国留给伊拉克的是个烂摊子吗"}
查询测试,输入
POST /index/fulltext/_search

{

    "query": {

        "match": {

            "content": "美国"

        }

    },

    "highlight": {

        "pre_tags": [

            "<tag1>",

            "<tag2>"

        ],

        "post_tags": [

            "</tag1>",

            "</tag2>"

        ],

        "fields": {

            "content": {}

        }

    }

}
结果如图所示:

搜索引擎ElasticSearch系列(五): ElasticSearch2.4.4 IK中文分词器插件安装的更多相关文章
- 30.IK中文分词器的安装和简单使用
在之前我们学的都是英文,用的也是英文的standard分词器.从这一节开始,学习中文分词器.中国人基本上都是中文应用,很少是英文的,而standard分词器是没有办法对中文进行合理分词的,只是将每个中 ...
- elasticsearch ik中文分词器的安装配置使用
安装步骤 https://github.com/medcl/elasticsearch-analysis-ik 以插件形式安装: [elsearch@localhost elasticsearch- ...
- ES[7.6.x]学习笔记(七)IK中文分词器
在上一节中,我们给大家介绍了ES的分析器,我相信大家对ES的全文搜索已经有了深刻的印象.分析器包含3个部分:字符过滤器.分词器.分词过滤器.在上一节的例子,大家发现了,都是英文的例子,是吧?因为ES是 ...
- 【自定义IK词典】Elasticsearch之中文分词器插件es-ik的自定义词库
Elasticsearch之中文分词器插件es-ik 针对一些特殊的词语在分词的时候也需要能够识别 有人会问,那么,例如: 如果我想根据自己的本家姓氏来查询,如zhouls,姓氏“周”. 如 ...
- elasticsearch使用ik中文分词器
elasticsearch使用ik中文分词器 一.背景 二.安装 ik 分词器 1.从 github 上找到和本次 es 版本匹配上的 分词器 2.使用 es 自带的插件管理 elasticsearc ...
- elasticsearch ik中文分词器安装
特殊说明:灰色文字用来辅助理解的. 安装IK中文分词器 我在百度上搜索了下,大多介绍的都是用maven打包下载下来的源码,这种方法也行,但是不够方便,为什么这么说? 首先需要安装maven吧?其次需要 ...
- ElasticSearch速学 - IK中文分词器远程字典设置
前面已经对”IK中文分词器“有了简单的了解: 但是可以发现不是对所有的词都能很好的区分,比如: 逼格这个词就没有分出来. 词库 实际上IK分词器也是根据一些词库来进行分词的,我们可以丰富这个词库. ...
- Elasticsearch:IK中文分词器
Elasticsearch内置的分词器对中文不友好,只会一个字一个字的分,无法形成词语,比如: POST /_analyze { "text": "我爱北京天安门&quo ...
- Elasticsearch之中文分词器插件es-ik(博主推荐)
前提 什么是倒排索引? Elasticsearch之分词器的作用 Elasticsearch之分词器的工作流程 Elasticsearch之停用词 Elasticsearch之中文分词器 Elasti ...
随机推荐
- StackExchange.Redis学习笔记(二) Redis查询 五种数据类型的应用
ConnectionMultiplexer ConnectionMultiplexer 是StackExchange.Redis的核心对象,用这个类的实例来进行Redis的一系列操作,对于一个整个应用 ...
- Spring(十四)之事务
事务管理 一个数据库事务是一个被视为单一的工作单元的操作序列.这些操作应该要么完整地执行,要么完全不执行.事务管理是一个重要组成部分,RDBMS 面向企业应用程序,以确保数据完整性和一致性.事务的概念 ...
- 获取 当前显示的 UIViewController
UIViewController * findBestVC(UIViewController *vc) { if (vc.presentedViewController) { return findB ...
- css z-index之object flash层级问题
<object type="application/x-shockwave-flash" data="flash文件路径" style="z-i ...
- 记2019年目标之一没有996的大数据分析BI实战历程
本文略长,阅读大约需要10分钟. 懵懵懂懂的学习了python,然后一发不可收拾的爱上了python大数据分析,慢慢的走进了大数据的学堂,学习如何大数据挖掘,大数据分析,到BI系统建设使用. 大数据的 ...
- 【腾讯敏捷转型No.6】如何打造称手的敏捷工具
通常情况下,大家对于敏捷的感受就是:大家一起来开站立晨会啦!然后一大早,大家拿着早餐,围成一个圈,听一个人在讲话. 在很多公司,决定采用敏捷之后,都会从晨会开始,因为很多人觉得敏捷其它模块都很难学习, ...
- python3爬虫-爬取B站排行榜信息
import requests, re, time, os category_dic = { "all": "全站榜", "origin": ...
- mysql5.7关于使用到OR是否会用到索引并提高查询效率的探讨
相信很多人在mysql中看到了where条件中使用到了or就会以为这样是不会走索引的,通常会使用union all或者in 来进行优化,事实并不是想象的这样具体问题具体分析. 下面我们来看看 首先我们 ...
- OpenStack(queens)最小化搭建记录——控制与计算共两个节点
境: 2台安装了centos7-minimal的主机 ip地址: 10.132.226.103/24 (controller) 10.132.226.104/24 (compute1) 1.配置主机名 ...
- md5,md2加密加盐
数组是没有重写object的toString()方法.byte[].toString()