
论文笔记:Real-Time MDNet
Real-Time MDNet
ECCV 2018 2018-10-22 15:52:01
Code (PyTorch): https://github.com/IlchaeJung/RT-MDNet
Reference Paper:
1. Learning Multi-Domain Convolutional Neural Networks for Visual Tracking CVPR-2016 paper code
2. BranchOut: Regularization for Online Ensemble Tracking with Convolutional Neural Networks CVPR-2017 paper
3. "Meta-Tracker: Fast and Robust Online Adaptation for Visual Object Trackers." ECCV-2018 Paper Code
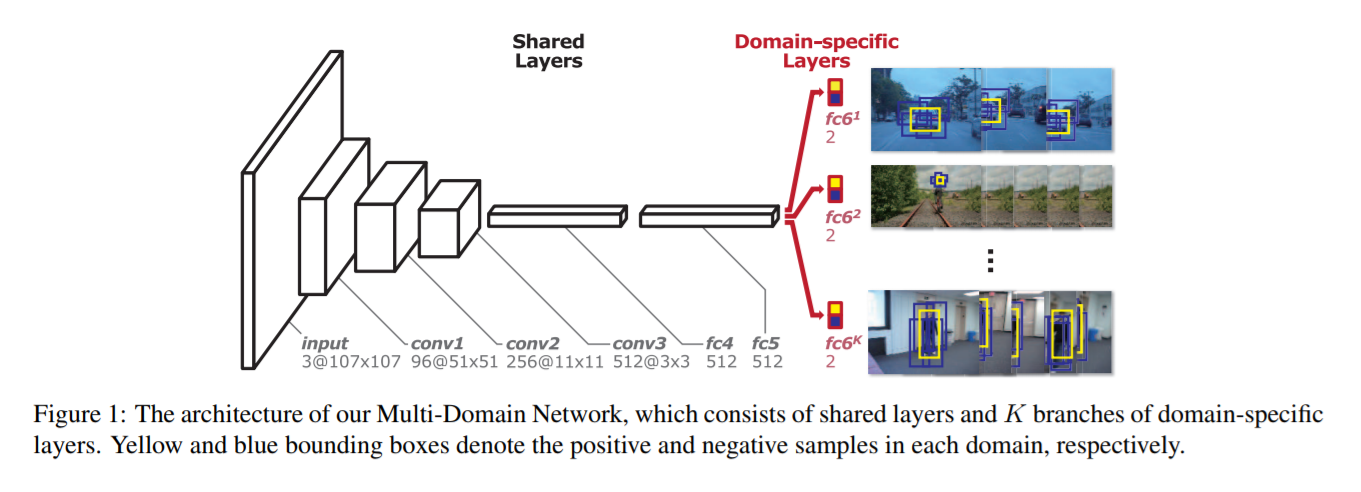
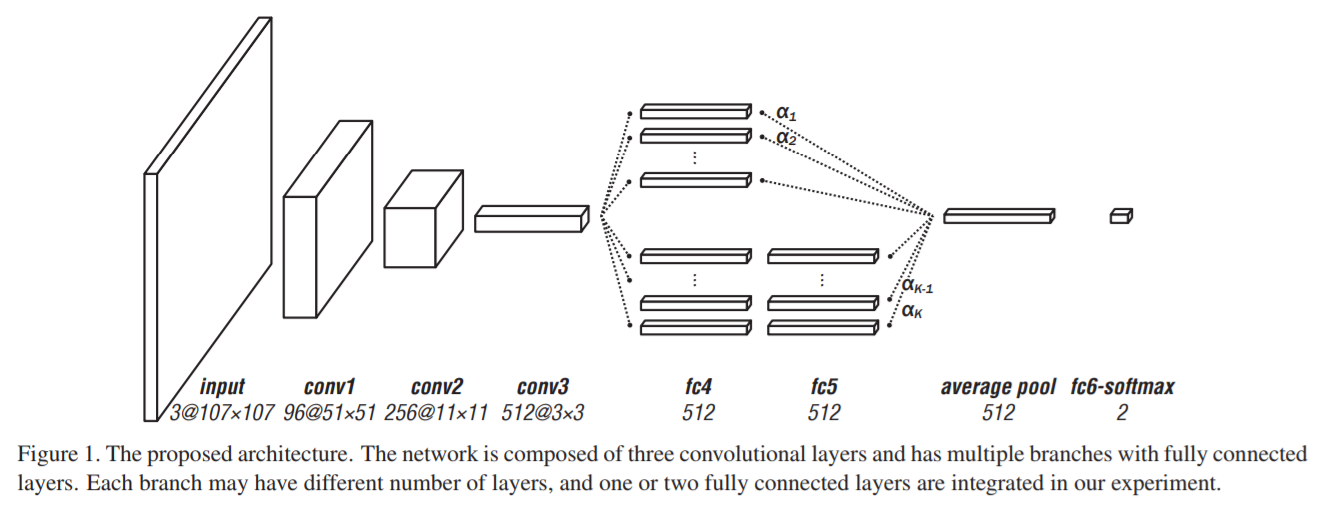
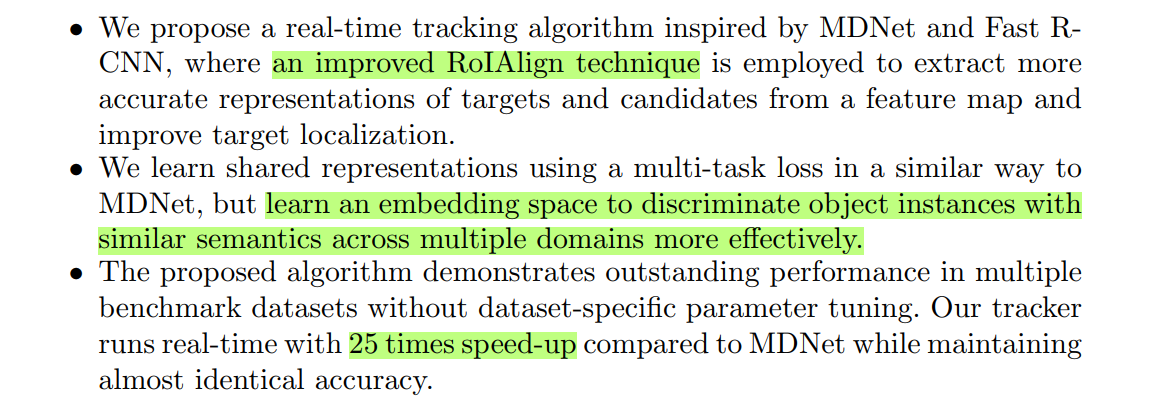
上面两个流程图分别是 MDNet 以及 MDNet 的一个改进 Branchout。本文是基于 MDNet 进行改进的,主要是在速度上进行大幅度的提升,因为原始的 MDNet 采用的是 RCNN 的思路,暴力的进行特征的提取,而本文采用改进的 ROI Align 的方法进行更加高效的特征提取。此外,作者提出一种新的 loss function 使其能够取更好的区分前景背景。主要的贡献如下:
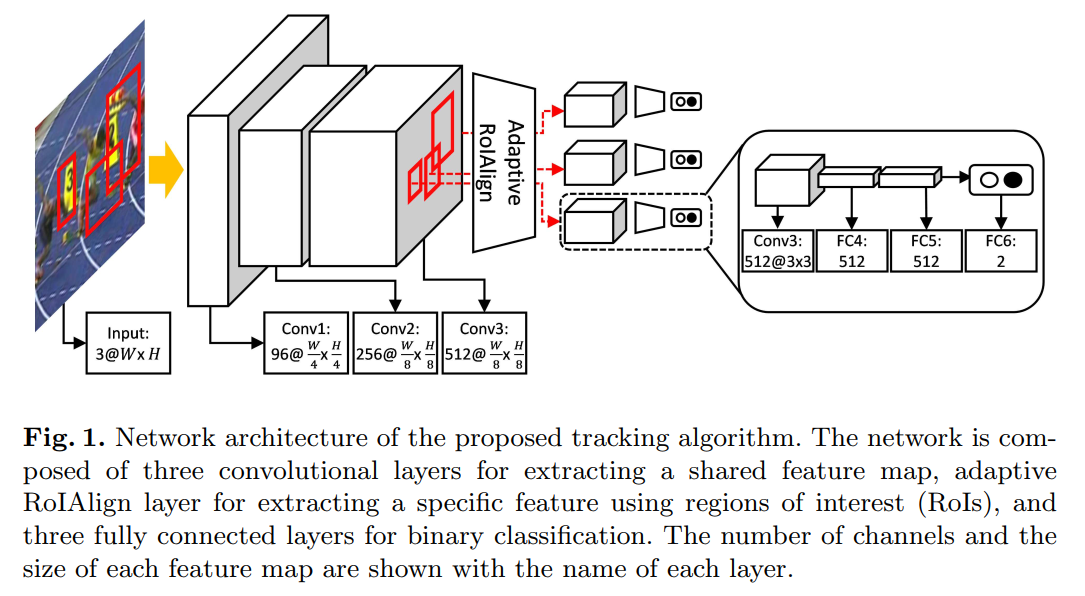
本文所提出的网络结构如下所示:
Efficient Feature Extraction and Discriminative Feature Learning:
1. Network Architecture:
如图1所示,网络结构上与 MDNet 基本一致,最大的改动就是采用 改进的 ROI Align 算法 替换掉了原本的暴力的特征提取流程。所以,该网络结构就变成了:3 conv + Adaptive ROI Align layer + fc layers 。
2. Improved RoIAlign for Visual Tracking:
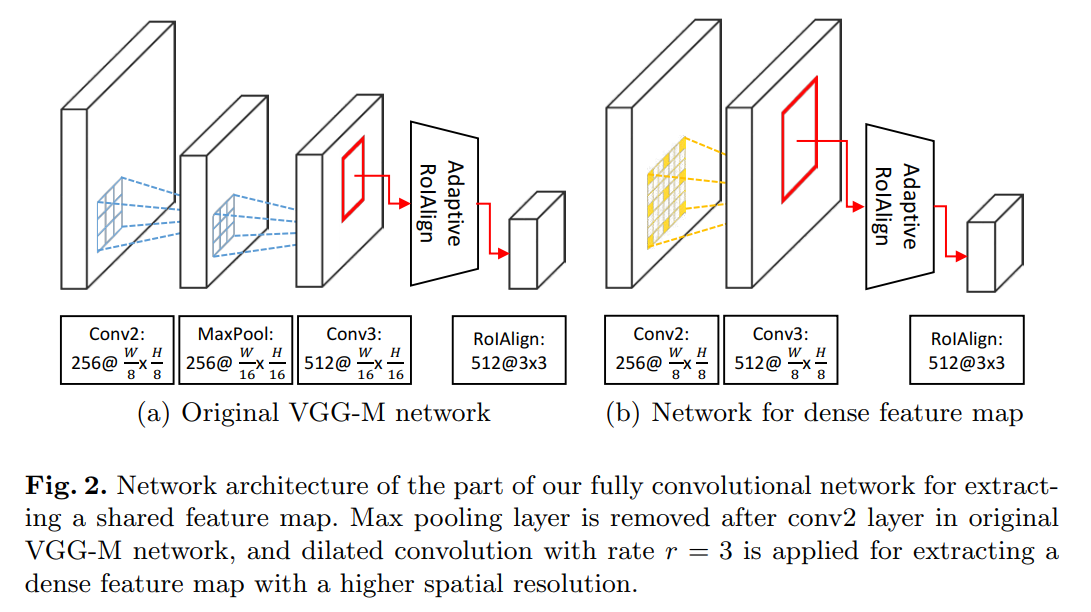
直接采用 RoIAlign 算法得到的 feature map 是比较粗糙的( compared to the ones from individual proposal bounding box)。为了提升 RoIs 的质量,我们需要构建一个 feature map,使得该 feature map 有较高的分辨率 以及 丰富的语义信息。这些需求可以通过获取更加 dense 的全卷机特征图以及扩张每一个激活的感受野来实现(by computing a denser fully convolutional feature map and enlarging the receptive field of each activitation)。所以,我们移除了 a max pooling layer followed by conv2 layer in VGG-M network,然后利用空洞卷积来提升分辨率(with rate r =3)。这个策略可以得到比常规的卷积更大的 feature map。它可以提取到更大的 feature maps,可以很大程度上改善表达的质量。图2展示了常规的 MDNet 与 加入了 dilated layers 之后的网络,进行了对比。
3. Pretraining for Dsicriminative Instance Embedding:
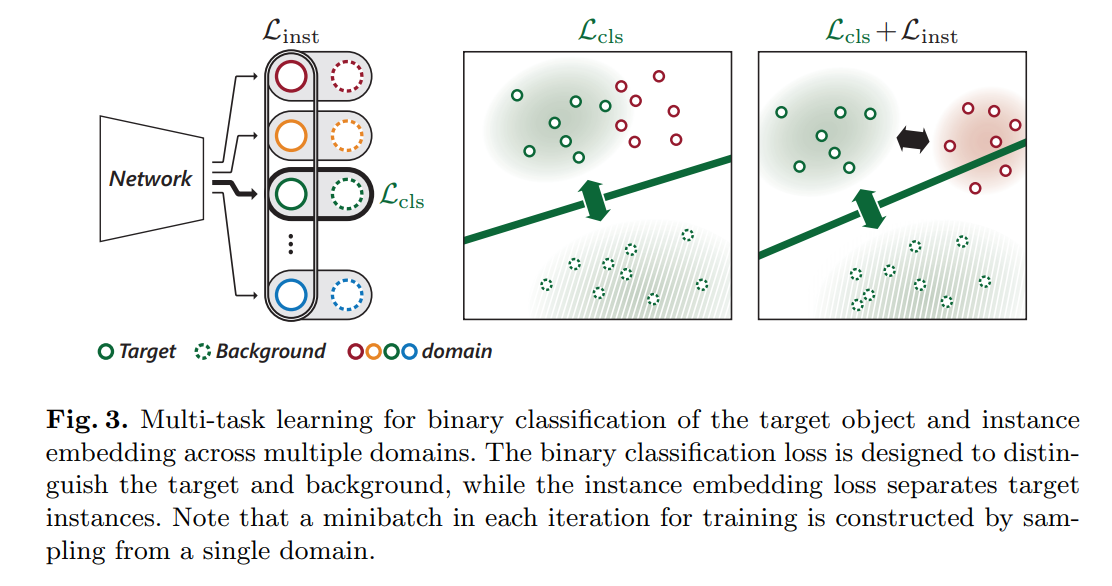
我们的学习算法的目标是训练一个判别性的特征映射,来应用到 multiple domains。MDNet 划分出 shared and domain separate layers 来学习表示以区分出前景和背景。除了这个目标之外,我们提出一种新的 loss,即:instance embedding loss,enforces target objects in different domains to be embedded far from each other in a shared feature space and enables to learn discriminative represenations of the unseen target objects in new test sequences. 换句话说,MDNet 仅仅考虑在单独的 domain 来区分 target 和 background,可能在不同 domains 之间来判断 foreground objects 没那么好,特别是当前景物体属于同一个 semantic class 或者 有类似的外观时。这可能是由于原始的 CNN 是用来训练做分类的。为了解决这个问题,我们的算法将额外的约束考虑进来,对前景物体进行 embedding,使得在不同 videos 之间彼此远离(embeds foreground objects from multiple videos to be apart from each other)。
给定一张图像 $x_d$,在domain d,以及 BBox R,网络输出的得分,记为 fd, 通过 concatenating 最后的 fc layers 的激活来构成:
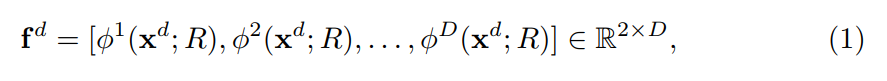
其中, 是一个 2D binary classification score in domain d,D 是训练结合中 domain 的个数。输出的 feature 被送到 softmax function 中进行二分类,来确定是否一个 BBox R 是前景或者背景图像 in domain d。另外,输出的 feature 通过另一个 softmax operator 来进行 multiple domains 的 instances 判断。这两个 softmax 可以表达为:

其中, 比较了在每一个 domain 中,目标物体和背景物体之间的得分,
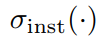 对比了所有 domains 的物体的 pos score。
我们网络优化一个多任务的 loss L,可以表达为:
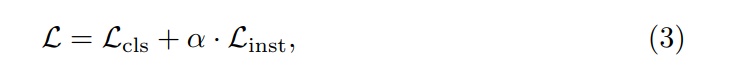
其中,$L_{cls}$ 以及 $L_{inst}$ 分别是 binary classification 与 discriminative instance embedding 的 loss function。详细的表达式,可以分别记为:
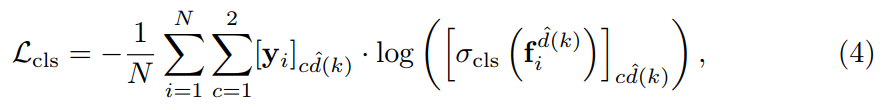

注意到,the instance embedding loss 仅仅对 positive examples 进行处理。
Online Tracking Algorithm:
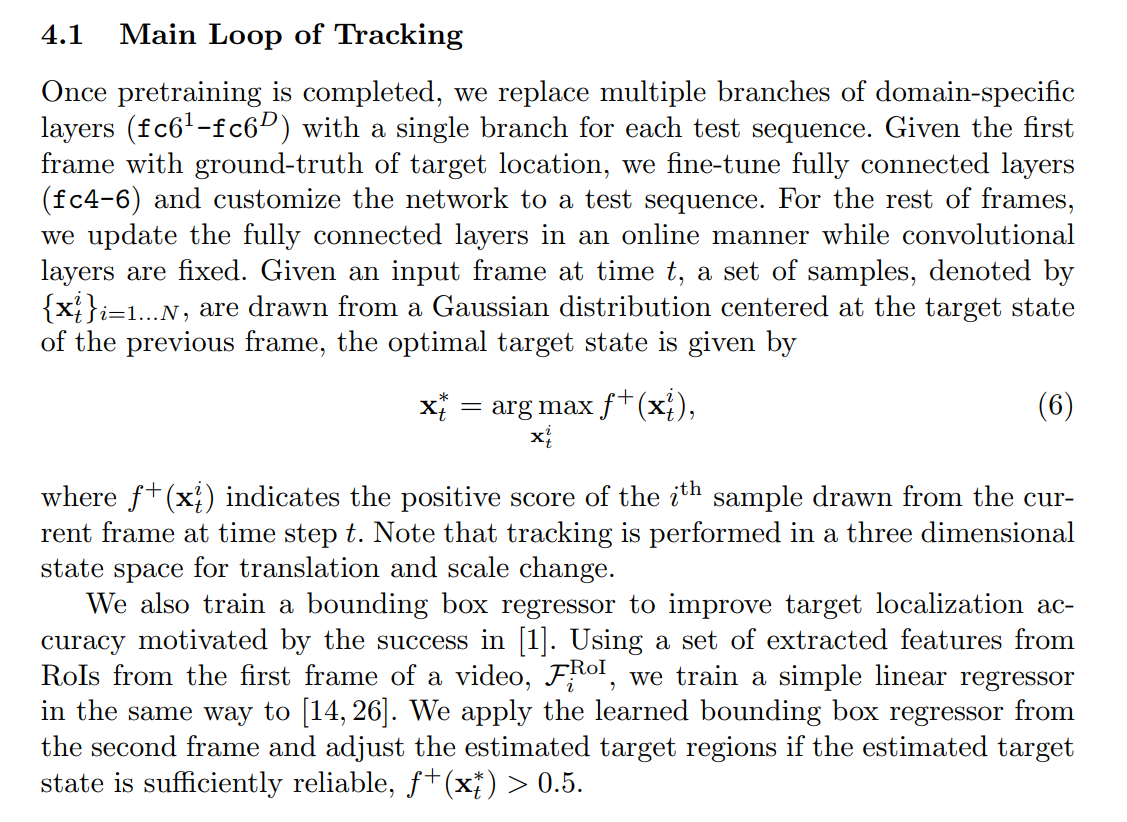
4.2 Online Model Updates:
We perform two complementary update strategies as in MDNet [1]: long-term and short-term updates to maintain robustness and adaptiveness, respectively. Long-term updates are regularly applied using the samples collected for a long period of time, while short-term updates are triggered whenever the score of the estimated target is below a threshold and the result is unreliable.
与 MDNet 不同的是,作者并没有利用 VOT 训练 OTB 测试 或者相反的思路,而是用 ImageNet-VID 上的视频,将近有 4500 个视频,作者随机挑选了 100 videos 来进行offline pretraining。
5. Experiments:
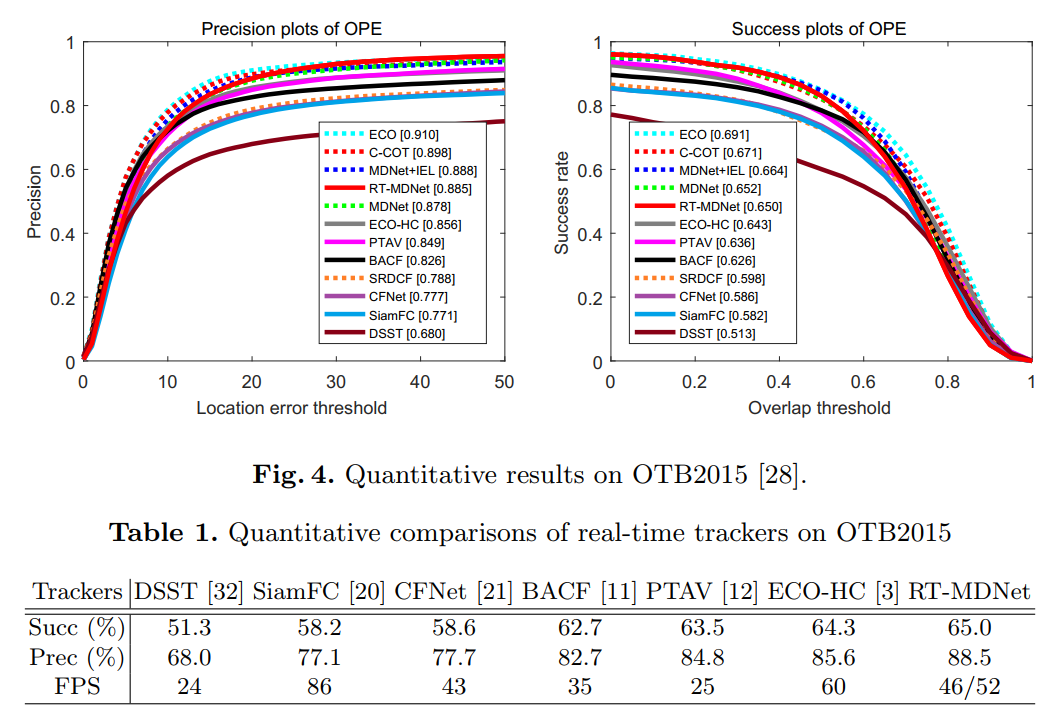
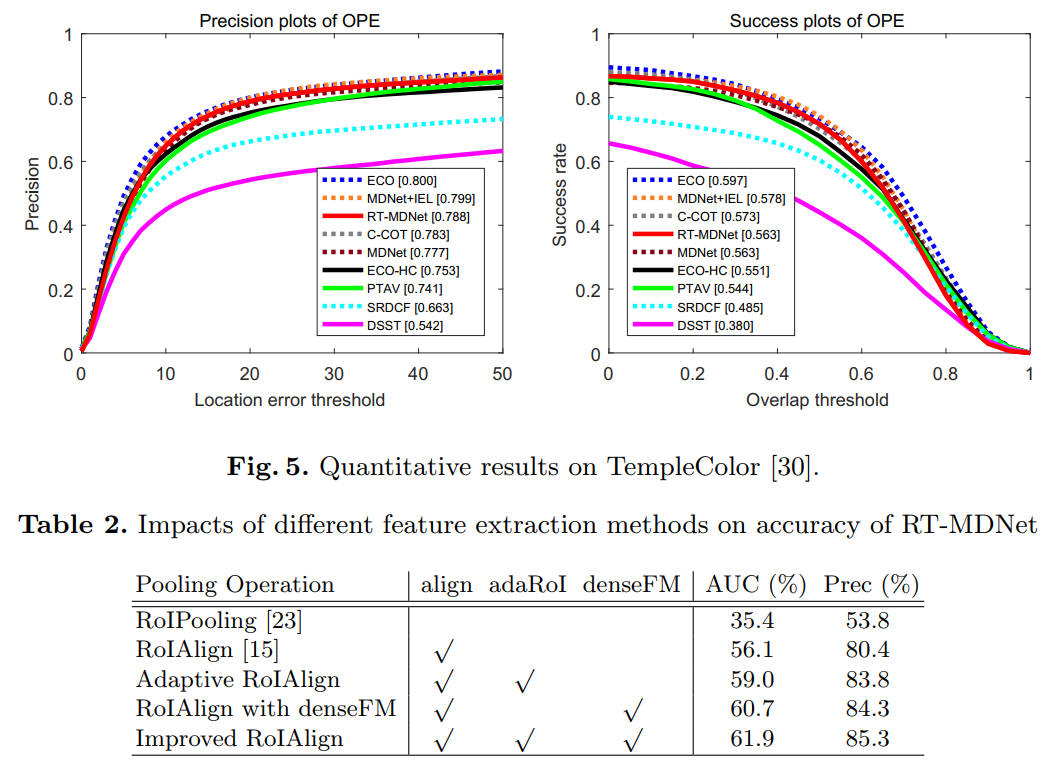
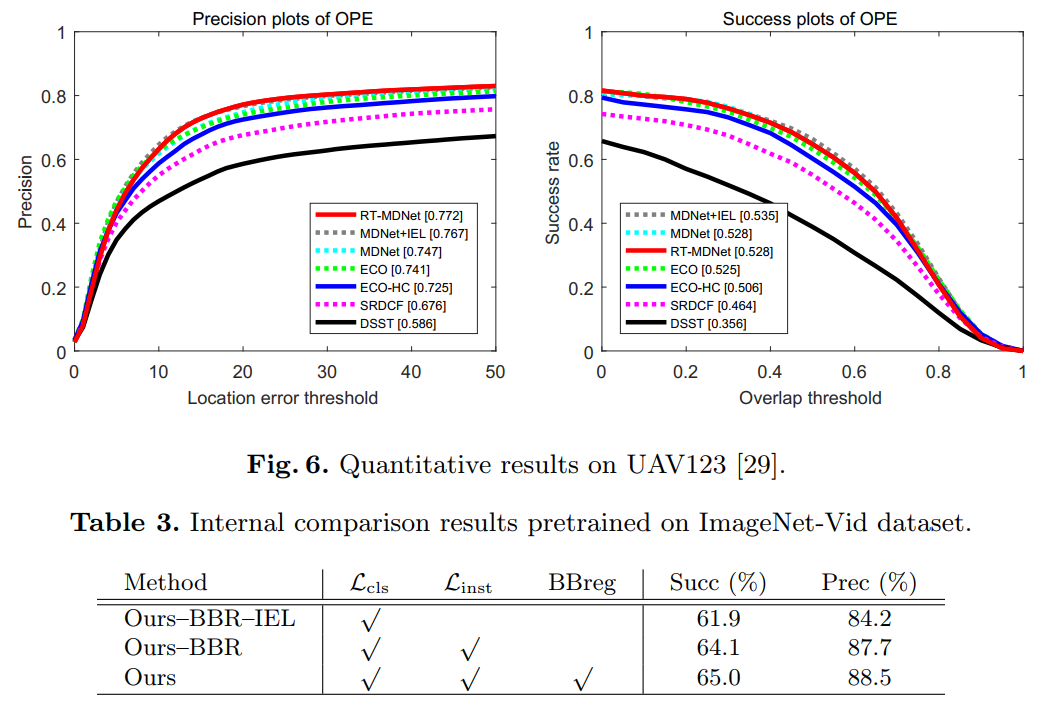
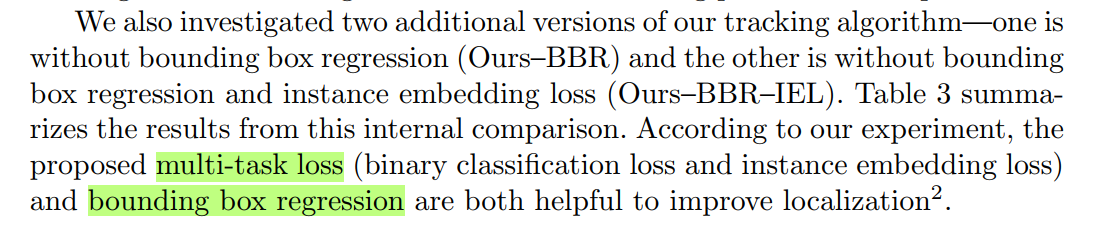
可以看到,作者在后续跟踪过程中,采用了 BBox regression 的技术,但是没有提到是否采用了 MDNet 中用到的 Hard Negative Mining(没有说,默认就是没有用咯 o(╯□╰)o)。
论文笔记:Real-Time MDNet的更多相关文章
- 论文笔记之:Action-Decision Networks for Visual Tracking with Deep Reinforcement Learning
论文笔记之:Action-Decision Networks for Visual Tracking with Deep Reinforcement Learning 2017-06-06 21: ...
- Deep Learning论文笔记之(四)CNN卷积神经网络推导和实现(转)
Deep Learning论文笔记之(四)CNN卷积神经网络推导和实现 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些论文, ...
- 论文笔记之:Visual Tracking with Fully Convolutional Networks
论文笔记之:Visual Tracking with Fully Convolutional Networks ICCV 2015 CUHK 本文利用 FCN 来做跟踪问题,但开篇就提到并非将其看做 ...
- Deep Learning论文笔记之(八)Deep Learning最新综述
Deep Learning论文笔记之(八)Deep Learning最新综述 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些论文,但老感觉看完 ...
- Twitter 新一代流处理利器——Heron 论文笔记之Heron架构
Twitter 新一代流处理利器--Heron 论文笔记之Heron架构 标签(空格分隔): Streaming-process realtime-process Heron Architecture ...
- Deep Learning论文笔记之(六)Multi-Stage多级架构分析
Deep Learning论文笔记之(六)Multi-Stage多级架构分析 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些 ...
- Multimodal —— 看图说话(Image Caption)任务的论文笔记(一)评价指标和NIC模型
看图说话(Image Caption)任务是结合CV和NLP两个领域的一种比较综合的任务,Image Caption模型的输入是一幅图像,输出是对该幅图像进行描述的一段文字.这项任务要求模型可以识别图 ...
- 论文笔记(1):Deep Learning.
论文笔记1:Deep Learning 2015年,深度学习三位大牛(Yann LeCun,Yoshua Bengio & Geoffrey Hinton),合作在Nature ...
- 论文笔记(2):A fast learning algorithm for deep belief nets.
论文笔记(2):A fast learning algorithm for deep belief nets. 这几天继续学习一篇论文,Hinton的A Fast Learning Algorithm ...
随机推荐
- 10.17小结:table.copy() 和 distinct 查询
1. 当datatable 已存在于一个dataset中时,可以使用 ds.tables.add(dt.copy()) 来向dataset 中添加datatable; 2. 当datarow已存在于一 ...
- nginx配置框架问题
1.框架源文件没有引入 2.nginx fastcgi.conf配置允许访问上级目录地址 3.使用autoindex on;参数
- [daily] 比端口转发更高级的ssh device tunnel转发
没有什么能够阻挡,你对自由的向往. 场景: 我有一台设备Server100,在某一个f复杂的内网里,需要多次ssh跳转可以访问到.但是它不能直接访问internet. 我现在需要在我的ssh路径上,搭 ...
- Linux服务器上搭建web项目环境
一.下载并安装jdk 去官网下载linux系统上jdk的安装包jdk-8u181-linux-x64.tar.gz,在Linux的/usr目录下新建文件夹java,可以使用命令:cd /usr ...
- container_of 例子说明
很早前之前看的linux内核,一直想把container_of记录一下,趁今天想起就记录一下: 内核中的描述 /** * container_of - cast a member of a struc ...
- java之动态代理
摘要 相比于静态代理,动态代理避免了开发人员编写各个繁锁的静态代理类,只需简单地指定一组接口及目标类对象就能动态的获得代理对象. 这里说的静态代理可以理解为之前使用的装饰者模式,从之前使用装饰者模式实 ...
- python框架之Flask(2)-路由和视图&Session
路由和视图 这一波主要是通过看源码加深对 Flask 中路由和视图的了解,可以先回顾一下装饰器的知识:[装饰器函数与进阶] 路由设置的两种方式 # 示例代码 from flask import Fla ...
- vs安装问题
1 首先windows update异常,导致vs2015的一个安装不上,先试着修一下: https://support.microsoft.com/zh-cn/help/2629484 如果提示:“ ...
- Ethzasl MSF源码阅读(2):百川汇海
这里有个感觉,就是百川汇海.即IMU数据和相机的消息数据都汇集到msf_core进行处理.接上一篇, 1. 查看IMUHandler_ROS::IMUCallback和IMUHandler_ROS:: ...
- 如何用VSCode手动编译Ace Editor
对于习惯微软VS的用户,可能很不习惯开源社区兴起的前端开发流程.随着NodeJs的兴起,JavaScript已经成为Github上开源项目最多的语言.使用微软提供的VSCode可以很好地利用这些开源项 ...