
elasticsearch global 、 filters 和 cardinality 聚合
1. 背景
此处将单记录一下 global 、 filters和cardinality的聚合操作。
2、解释
1、global
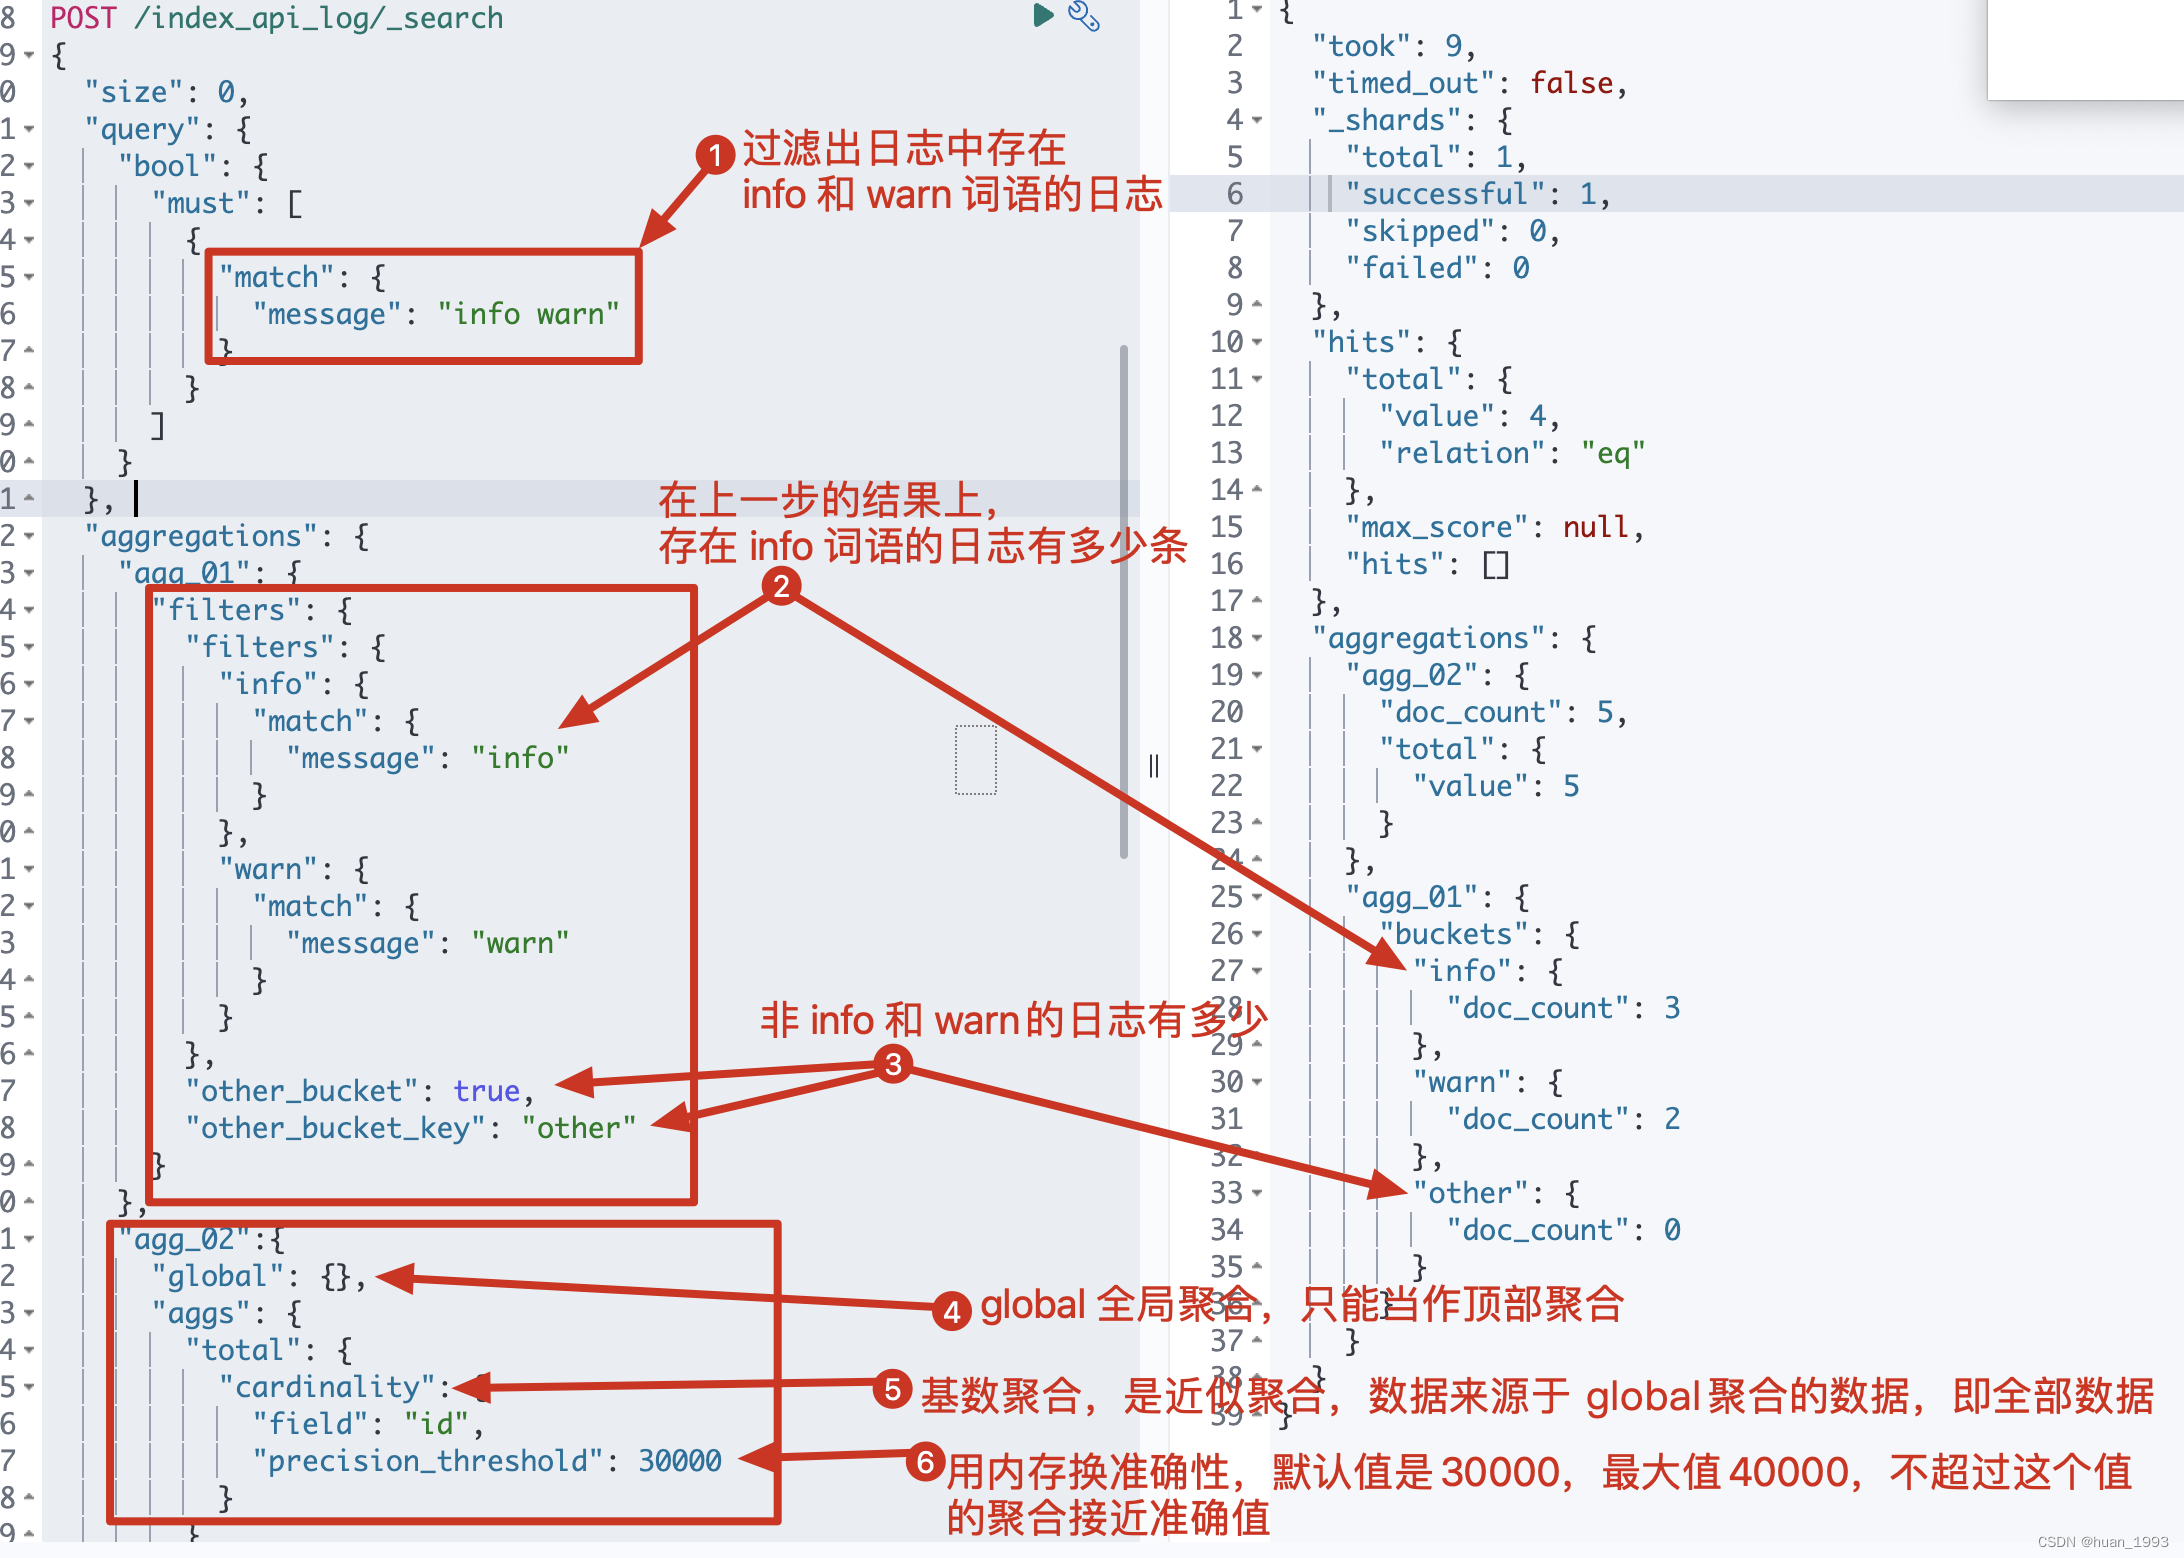
global聚合是全局聚合,是对所有的文档进行聚合,而不受查询条件的限制。
global 聚合器只能作为顶级聚合器,因为将一个 global 聚合器嵌入另一个桶聚合器是没有意义的。
比如: 我们有50个文档,通过查询条件筛选之后存在10个文档,此时我想统计总共有多少个文档。是50个,因为global统计不受查询条件的限制。
2、filters
定义一个多桶聚合,其中每个桶都与一个过滤器相关联。每个桶都会收集与其关联的过滤器匹配的所有文档。
比如: 我们总共有50个文档,通过查询条件筛选之后存在10个文档,此时我想统计 这10个文档中,出现info词语的文档有多少个,出现warn词语的文档有多少个。
3、cardinality
类似于 SQL中的 COUNT(DISTINCT(字段)),不过这个是近似统计,是基于 HyperLogLog++ 来实现的。
3、需求
我们有一组日志,每条日志都存在id和message2个字段。此时根据message字段过滤出存在info warn的日志,然后进行统计:
- 系统中总共有多少条日志(
global + cardinality) - info和warn级别的日志各有多少条(
filters)
4、前置条件
4.1 创建mapping
PUT /index_api_log

{

  "settings": {

    "number_of_shards": 1

  },

  "mappings": {

    "properties": {

      "message":{

        "type": "text"

      },

      "id": {

        "type": "long"

      }

    }

  }

}
4.2 准备数据
PUT /index_api_log/_bulk

{"index":{"_id":1}}

{"message": "this is info message-01","id":1}

{"index":{"_id":2}}

{"message": "this is info message-02","id":2}

{"index":{"_id":3}}

{"message": "this is warn message-01","id":3}

{"index":{"_id":4}}

{"message": "this is error message","id":4}

{"index":{"_id":5}}

{"message": "this is info and warn message","id":5}
5、实现3的需求
5.1 dsl
POST /index_api_log/_search

{

  "size": 0,

  "query": {

    "bool": {

      "must": [

        {

          "match": {

            "message": "info warn"

          }

        }

      ]

    }

  },

  "aggregations": {

    "agg_01": {

      "filters": {

        "filters": {

          "info": {

            "match": {

              "message": "info"

            }

          },

          "warn": {

            "match": {

              "message": "warn"

            }

          }

        },

        "other_bucket": true,

        "other_bucket_key": "other"

      }

    },

    "agg_02":{

      "global": {},

      "aggs": {

        "total": {

          "cardinality": {

            "field": "id",

            "precision_threshold": 30000

          }

        }

      }

    }

  }

}
5.2 java 代码
@Test

@DisplayName("global and filters and cardinality 聚合")

public void test01() throws IOException {

    SearchRequest request = SearchRequest.of(searchRequest ->

            searchRequest.index("index_api_log")

                    // 查询 message 中存在 info 和 warn 的日志

                    .query(query -> query.bool(bool -> bool.must(must -> must.match(match -> match.field("message").query("info warn")))))

                    // 查询的结果不返回

                    .size(0)

                    // 第一个聚合

                    .aggregations("agg_01", agg ->

                            agg.filters(filters ->

                                    filters.filters(f ->

                                                    f.array(

                                                            Arrays.asList(

                                                                    // 在上一步query的结果中,将 message中包含info的进行聚合

                                                                    Query.of(q -> q.match(m -> m.field("message").query("info"))),

                                                                    // 在上一步query的结果中,将 message中包含warn的进行聚合

                                                                    Query.of(q -> q.match(m -> m.field("message").query("warn")))

                                                            )

                                                    )

                                            )

                                            // 如果上一步的查询中,存在非 info 和 warn的则是否聚合到 other 桶中

                                            .otherBucket(true)

                                            // 给 other 桶取一个名字

                                            .otherBucketKey("other")

                            )

                    )

                    // 第二个聚合

                    .aggregations("agg_02", agg ->

                            agg

                                    // 此处的 global 聚合只能放在顶部

                                    .global(global -> global)

                                    // 子聚合,数据来源于所有的文档,不受上一步query结果的限制

                                    .aggregations("total", subAgg ->

                                            // 类似于SQL中的 count(distinct(字段)),是一个近似统计

                                            subAgg.cardinality(cardinality ->

                                                    // 统计的字段

                                                    cardinality.field("id")

                                                            // 精度,默认值是30000,最大值也是40000,不超过这个值的聚合近似准确值

                                                            .precisionThreshold(30000)

                                            )

                                    )

                    )

    );

    System.out.println("request: " + request);

    SearchResponse<String> response = client.search(request, String.class);

    System.out.println("response: " + response);

}
5.3 运行结果
6、实现代码
7、参考文档
elasticsearch global 、 filters 和 cardinality 聚合的更多相关文章
- Elasticsearch 第六篇:聚合统计查询
h2.post_title { background-color: rgba(43, 102, 149, 1); color: rgba(255, 255, 255, 1); font-size: 1 ...
- 把 Elasticsearch 当数据库使:聚合后排序
使用 https://github.com/taowen/es-monitor 可以用 SQL 进行 elasticsearch 的查询.有的时候分桶聚合之后会产生很多的桶,我们只对其中部分的桶关心. ...
- Elasticsearch学习系列四(聚合搜索)
聚合分析 聚合分析是数据库中重要的功能特性,完成对一个查询的集中数据的聚合计算.如:最大值.最小值.求和.平均值等等.对一个数据集求和,算最大最小值等等,在ES中称为指标聚合,而对数据做类似关系型数据 ...
- ElasticSearch的高级复杂查询:非聚合查询和聚合查询
一.非聚合复杂查询(这儿展示了非聚合复杂查询的常用流程) 查询条件QueryBuilder的构建方法 1.1 精确查询(必须完全匹配上,相当于SQL语句中的“=”) ① 单个匹配 termQuery ...
- ElasticSearch入门系列(三)文档,索引,搜索和聚合
一.文档 在实际使用中的对象往往拥有复杂的数据结构 Elasticsearch是面向文档的,这意味着他可以存储整个对象或文档,然而他不仅仅是存储,还会索引每个文档的内容使之可以被搜索,在Elastic ...
- ElasticSearch 的 聚合(Aggregations)
Elasticsearch有一个功能叫做 聚合(aggregations) ,它允许你在数据上生成复杂的分析统计.它很像SQL中的 GROUP BY 但是功能更强大. Aggregations种类分为 ...
- ElasticSearch - 信息聚合系列之聚合过滤
摘要 聚合范围限定还有一个自然的扩展就是过滤.因为聚合是在查询结果范围内操作的,任何可以适用于查询的过滤器也可以应用在聚合上. 版本 elasticsearch版本: elasticsearch-2. ...
- elasticsearch聚合操作——本质就是针对搜索后的结果使用桶bucket(允许嵌套)进行group by,统计下分组结果,包括min/max/avg
分析 Elasticsearch有一个功能叫做聚合(aggregations),它允许你在数据上生成复杂的分析统计.它很像SQL中的GROUP BY但是功能更强大. 举个例子,让我们找到所有职员中最大 ...
- ElasticSearch 2 (33) - 信息聚合系列之聚合过滤
ElasticSearch 2 (33) - 信息聚合系列之聚合过滤 摘要 聚合范围限定还有一个自然的扩展就是过滤.因为聚合是在查询结果范围内操作的,任何可以适用于查询的过滤器也可以应用在聚合上. 版 ...
- ElasticSearch 2 (30) - 信息聚合系列之条形图
ElasticSearch 2 (30) - 信息聚合系列之条形图 摘要 版本 elasticsearch版本: elasticsearch-2.x 内容 聚合还有一个令人激动的特性就是能够十分容易地 ...
随机推荐
- 数据卷Volume
数据卷概述 Kubernetes Volume(数据卷)主要解决了如下两方面问题: 数据持久性:通常情况下,容器运行起来之后,写入到其文件系统的文件暂时性的.当容器崩溃后,kubelet 将会重启该容 ...
- flask中验证用户登录的装饰器
from flask import Flask,render_template,redirect,request,session from functools import wraps app = F ...
- MySql的InnoDB的三层B+树可以存储两千万左右条数据的计算逻辑
总结/朱季谦 B+树是一种在非叶子节点存放排序好的索引而在叶子节点存放数据的数据结构,值得注意的是,在叶子节点中,存储的并非只是一行表数据,而是以页为单位存储,一个页可以包含多行表记录.非叶子节点存放 ...
- Python实现给图片加水印功能
前言 最近忙得连轴转,很久没更新博客了,代码倒是没啥写,积累了好些东西,接下来一有时间就来更新吧~ 本文记录使用Python实现给图片添加水印的功能实现过程 先看效果 把公众号的封面作为素材 原图是这 ...
- 支付宝沙箱服务 (结合springboot实现,这里对接的是easy版本,工具用的是IDEA,WebStrom)
一:打开支付宝开发平台,登录,然后点击控制台 https://open.alipay.com/ 二:滚动到底部,选着沙箱服务 三:获取到对接要用的appId和公钥私钥 四:打开IDEA导入所需的xml ...
- Codeforces Round #577 (Div. 2) C. Maximum Median
题意:就是给一n(奇数)个元素数组,可以对它的元素执行k次+1操作,递增排序,求中位数最大是多少. 那我们在排完序之后,中位数前的元素可以不管它,只要对中位数后的操作就行,我们要判断和中位数相等的元素 ...
- POJ2533 Longest Ordered Subsequence (线性DP)
设dp[i]表示以i结尾的最长上升子序列的长度. dp[i]=max(dp[i],dp[j]+1). 1 #include <map> 2 #include <set> 3 # ...
- 计算机保研,maybe this is all you need(普通双非学子上岸浙大工程师数据科学项目)
写在前面 9.28接收了拟录取通知,也终究是尘埃落定了,我人生的又一个阶段也终于结束.面对最终录取结果,或多或少会有所遗憾,但也还是基本达到了预期的目标了. 作为在今年严峻的保研形势下幸存的我,一直想 ...
- Go Micro介绍与入门
一 什么是Micro? Micro是一个微服务生态系统,致力于提供产品,服务和解决方案,以实现现代软件驱动型企业的创新.我们计划成为任何与微服务相关的事实资源,并期待公司能够利用这项技术为自己的业务. ...
- 关于从Ecplise导入项目到MyEclipse会出现冲突的原因。
昨天,从网上下了一个Eclipse的小项目导入到MyEclipse中,出现了许多错误. 原因如下. JDK的编译版本和JRE的运行版本不一致导致了这个问题. 在MyEclipse中,对项目进行Buil ...