
Logstash & 索引生命周期管理(ILM)
Grok语法
Grok是通过模式匹配的方式来识别日志中的数据,可以把Grok插件简单理解为升级版本的正则表达式。它拥有更多的模式,默认,Logstash拥有120个模式。如果这些模式不满足我们解析日志的需求,我们可以直接使用正则表达式来进行匹配。
官网:
https://github.com/logstash-plugins/logstash-patterns-core/blob/master/patterns/grok-patterns
grok模式的语法是:%{SYNTAX:SEMANTIC}
SYNTAX指的是Grok模式名称,SEMANTIC是给模式匹配到的文本字段名。例如:
%{NUMBER:duration} %{IP:client}

duration表示:匹配一个数字,client表示匹配一个IP地址。
默认在Grok中,所有匹配到的的数据类型都是字符串,如果要转换成int类型(目前只支持int和float),可以这样:%{NUMBER:duration:int} %{IP:client}
以下是常用的Grok模式:
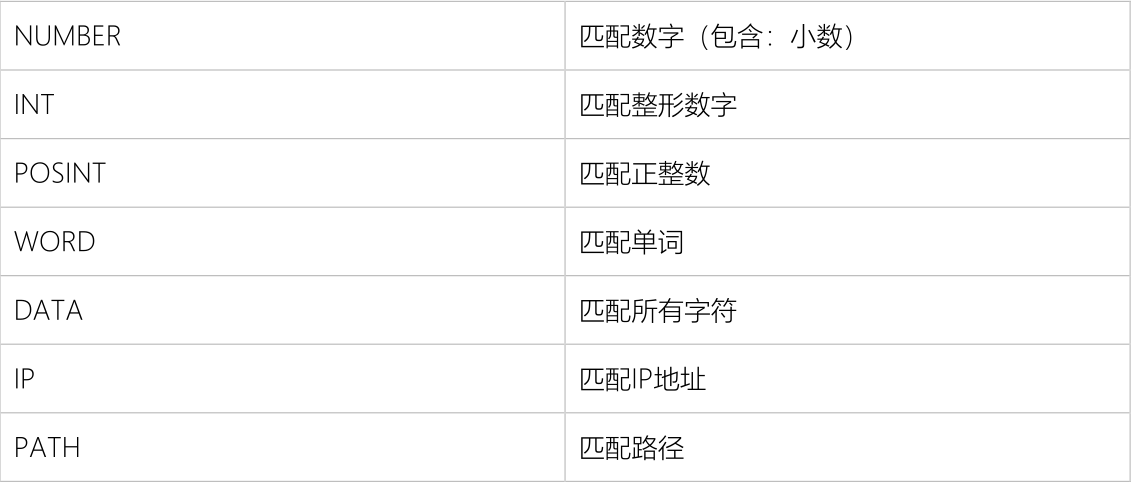
索引生命周期管理(ILM)
Elasticsearch索引生命周期管理指的是:Elasticsearch从创建索引、打开索引、关闭索引、删除索引的全生命过程的管理。
在大型Elasticsearch应用中,一般采用多索引结合基于时间、索引大小的横向扩展方式存储数据,随着数据量的增加,而不需要修改索引的底层架构。
- 索引生命周期管理 (ILM) 是在Elasticsearch 6.6首次引入,并在 6.7 版正式推出的一项功能
- ILM 是Elasticsearch的一部分,主要用来帮助管理索引
- 基于Elasticsearch的ILM可以实现热温冷架构
热温冷架构
- 热温冷架构常用于日志或指标类的时序数据
- 例如,假设正在使用 Elasticsearch 聚合来自多个系统的日志文件
- 今天的日志正在频繁地被索引,且本周的日志搜索量最大(热)
- 上周的日志可能会被频繁搜索,但频率没有本周日志那么高(温)
- 上月日志的搜索频率可能较高,也可能较低,但最好保留一段时间以防万一(冷)
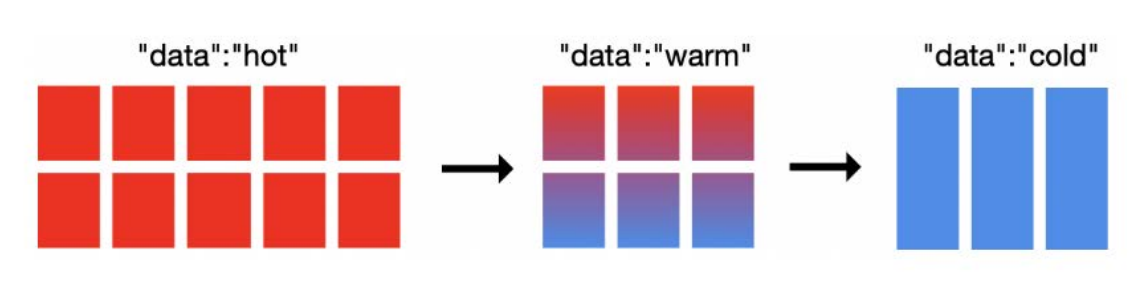
上图, 集群中有19个节点: 10个了热节点、 6个温节点、 3个冷节点。 冷节点是可选的。 Elasticsearch中,可以定义哪些节点是热节点、温节点或冷节点。
- ILM 允许定义何时在两个阶段之间移动,以及在进入那个阶段时如何处理索引
- 对于热温冷架构,没有一成不变的设置。但是,通常而言,热节点需要较多的 CPU 资源和较快的 IO。对于温节点和冷节点来说,通常每个节点会需要更多的磁盘空间,但即便使用较少的 CPU 资源和较慢的 IO 设备,也能勉强应付
配置分片分配感知
热温冷依赖于分片分配感知,因此,首先标记哪些节点是热节点、温节点和(可选)冷节点。
集群规划:

使用以下命令可以一键关键Elasticsearch集群:
jps | grep Elasticsearch | cut -f1 -d" " | xargs kill -9
配置ILM策略
- 要进行索引生命周期管理,需要配置ILM策略,ILM策略可以在选择的任意索引应用
- ILM策略主要分为四个主要阶段:热、温、冷、删除
- 不需要在一个策略中定义每个阶段, ILM 会始终按该顺序执行各个阶段 (跳过任何未定义的阶段)
- 可以通过配置ILM策略来定义什么时间进入该阶段,还可以定义按照什么样的方式来管理索引
以下代码是创建一个最基本的ILM策略:
PUT /_ilm/policy/my_policy

{

    "policy":{

        "phases":{

            "hot":{

                "actions":{

                    "rollover":{

                        "max_size":"50gb",

                        "max_age":"30d"

                    }

                }

            }

        }

    }

}
这个策略规定,在索引存储时间达到 30 天后或者索引大小达到 50GB(基于主分片)时,就会滚更新该索引并开始写入一个新索引。
ILM与索引模板
当索引类型和配置信息都一样,就可以使用索引模板来处理,不然每次创建索引都需要指定很多的索引参数。例如:指定refresh的周期、主分片的数量、副本数量、以及translog的一些配置等等
创建一个名为my_template模板,并与ILM策略关联:
PUT _template/my_template

{

    "index_patterns": ["test-*"],

        "settings": {

        "index.lifecycle.name": "my_policy",

        "index.lifecycle.rollover_alias": "test-alias"

    }

}
对于配置了滚动更新操作的策略,必须要在创建索引模板后使用写入别名启动索引
PUT test-000001

{

    "aliases": {

        "test-alias":{

            "is_write_index": true

        }

    }

}
配置了滚动更新的要求得到满足后,任何以 test-* 开头的新索引将在 30 天后或达到 50GB 时自动滚动更新。通过使用滚动更新管理以 max_size 开头的索引后,可以极大减少索引的分片数量,进而减少开销。
配置用于采集的ILM策略
- Beats 和 Logstash 都支持 ILM,并在启用后将设置一个类似上例所示的默认策略
- 当为 Beats 和 Logstash 启用 ILM 时,除非每天索引量很大(大于 50GB/天),否则索引大小将可能是确定何时创建新索引的主要因素
- 从 7.0.0 开始,带有滚动更新的 ILM 将是 Beats 和 Logstash 的默认配置
- 由于针对热温冷架构没有一成不变的设置,因此,Beats 和 Logstash 将不会自动配置好热温冷策略。我们可以制定一个适用于热温冷的新策略,并在这一过程中进行一些优化。
针对温热冷优化ILM策略
下面配置创建了针对热温冷架构优化的 ILM 策略。
PUT _ilm/policy/hot-warm-cold-delete-60days

{

    "policy": {

        "phases": {

            "hot": {

                "actions": {

                    "rollover": {

                        "max_size": "50gb",

                        "max_age": "30d"

                    },

                    "set_priority": {

                        "priority": 50

                    }

                }

            },

            "warm": {

                "min_age": "7d",

                "actions": {

                    "forcemerge": {

                        "max_num_segments": 1

                    },

                    "shrink": {

                        "number_of_shards": 1

                    },

                    "allocate": {

                        "require": {

                            "data": "warm"

                        }

                    },

                    "set_priority": {

                        "priority": 25

                    }

                }

            },

            "cold": {

                "min_age": "30d",

                "actions": {

                    "set_priority": {

                        "priority": 0

                    },

                    "freeze": {},

                    "allocate": {

                        "require": {

                            "data": "cold"

                        }

                    }

                }

            },

            "delete": {

                "min_age": "60d",

                "actions": {

                    "delete": {}

                }

            }

        }

    }

}
"hot": {

    "actions": {

        "rollover": {

            "max_size": "50gb",

            "max_age": "30d"

        },

        "set_priority": {

            "priority": 50

        }

    }

}
- 这个 ILM 策略首先会将索引优先级设置为一个较高的值,以便热索引在其他索引之前恢复
- 30天后或达到 50GB 时(符合任何一个即可),该索引将滚动更新,系统将创建一个新索引
- 该新索引将重新启动策略,而当前的索引(刚刚滚动更新的索引)将在滚动更新后等待 7 天再进入温阶段
"warm": {

    "min_age": "7d", # 索引7天进入到温阶段

    "actions": {

        "forcemerge": {

            "max_num_segments": 1 # 前置合并segment为1

        },

        "shrink": {

            "number_of_shards": 1 # 设置分片数量为1

        },

        "allocate": {

            "require": {

                "data": "warm" # 移动到温节点

            }

        },

        "set_priority": {

            "priority": 25 # 优先级比热阶段低

        }

    }

}
索引进入温阶段后,ILM 会将索引收缩到 1 个分片,将索引强制合并为 1 个段,并将索引优先级设置为比热阶段低(但比冷阶段高)的值,通过分配操作将索引移动到温节点。完成该操作后,索引将等待 30 天(从滚动更新时算起)后进入冷阶段。
"cold": {

    "min_age": "30d", # 索引进入温阶段后,经过30天进入冷阶段

    "actions": {

        "set_priority": {

            "priority": 0 # 优先级更低

        },

        "freeze": {},

        "allocate": {

            "require": {

                "data": "cold" # 将索引移动到冷节点

            }

        }

    }

}
索引进入冷阶段后, ILM 将再次降低索引优先级, 以确保热索引和温索引得到先行恢复。 然后, ILM将冻结索引并将其移动到冷节点。完成该操作后,索引将等待 60 天(从滚动更新时算起)后进入删除阶段。
"delete": {

    "min_age": "60d",

    "actions": {

        "delete": {}

    }

}
删除阶段具有用于删除索引的删除操作。在删除阶段,您将始终需要有一个 min_age 条件,以允许索引在给定时段内待在热、温或冷阶段。
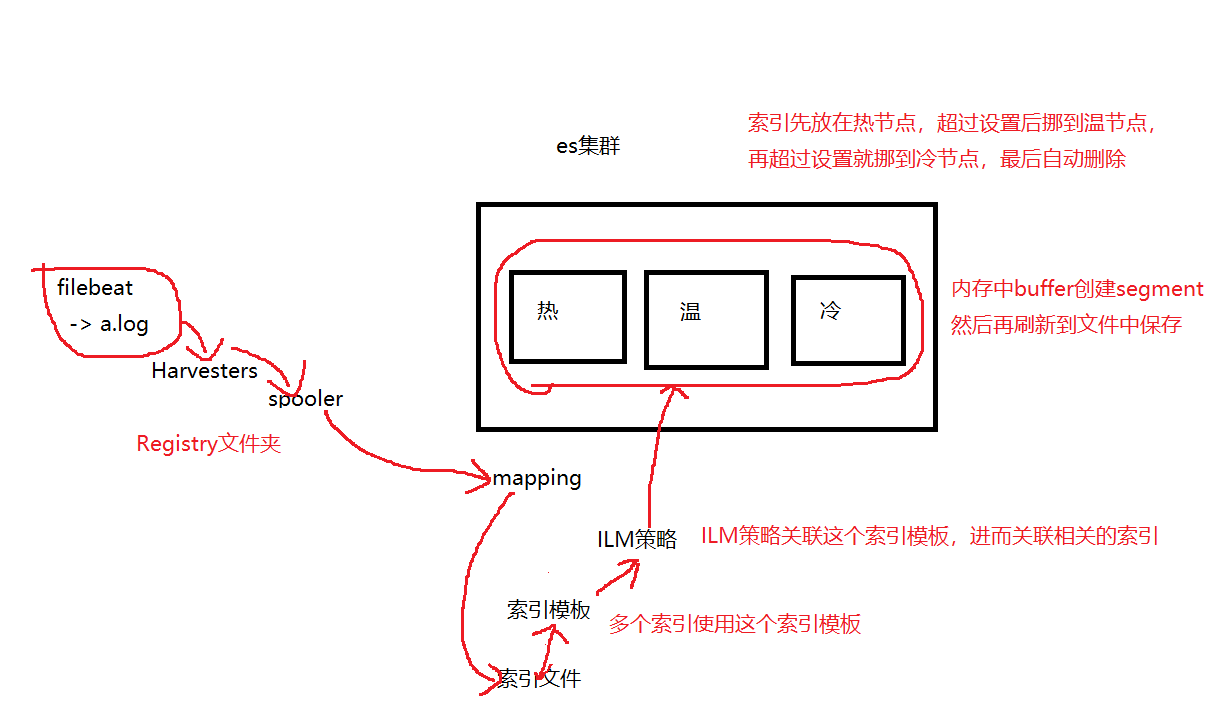
图示汇总
Logstash & 索引生命周期管理(ILM)的更多相关文章
- Elasticsearch 索引生命周期管理 ILM 实战指南
文章转载自:https://mp.weixin.qq.com/s/7VQd5sKt_PH56PFnCrUOHQ 1.什么是索引生命周期 在基于日志.指标.实时时间序列的大型系统中,集群的索引也具备类似 ...
- Elastic 使用索引生命周期管理实现热温冷架构
Elastic: 使用索引生命周期管理实现热温冷架构 索引生命周期管理 (ILM) 是在 Elasticsearch 6.6(公测版)首次引入并在 6.7 版正式推出的一项功能.ILM 是 Elast ...
- Elasticsearch索引生命周期管理方案
一.前言 在 Elasticsearch 的日常中,有很多如存储 系统日志.行为数据等方面的应用场景,这些场景的特点是数据量非常大,并且随着时间的增长 索引 的数量也会持续增长,然而这些场景基本上只有 ...
- Elasticsearch7.X ILM索引生命周期管理(冷热分离)
Elasticsearch7.X ILM索引生命周期管理(冷热分离) 一.“索引生命周期管理”概述 Elasticsearch索引生命周期管理指:Elasticsearch从设置.创建.打开.关闭.删 ...
- 这么简单的ES索引生命周期管理,不了解一下吗~
对于日志或指标(metric)类时序性强的ES索引,因为数据量大,并且写入和查询大多都是近期时间内的数据.我们可以采用hot-warm-cold架构将索引数据切分成hot/warm/cold的索引.h ...
- ElasticSearch——索引生命周期管理
从ES6.6开始,Elasticsearch提供索引生命周期管理功能,索引生命周期管理可以通过API或者kibana界面配置,详情参考[index-lifecycle-management] 本文仅通 ...
- ES 7.13版本设置索引模板和索引生命周期管理
第一步:索引管理中查看都有哪些索引文件,然后添加索引模式(后面的日期用*表示) 第二步:索引生命周期管理 自带的有一个log,就使用这个,不用再新建了,根据需求修改里面的配置就行了 第三步:添加索引模 ...
- Elasticsearch索引生命周期管理探索
文章转载自: https://mp.weixin.qq.com/s?__biz=MzI2NDY1MTA3OQ==&mid=2247484130&idx=1&sn=454f199 ...
- ELK 索引生命周期管理
kibana 索引配置 管理索引 点击设置 --- Elasticsearch 的 Index management 可以查看 elk 生成的所有索引 (设置,Elasticsearch ,管理) 配 ...
随机推荐
- kubernetes 调度
pod 分配给特定的node节点 目的:在一般业务场景,有些pod需要运行在特定的物理节点上,可以通过kubernetes的nodeSelector.nodeName安排pod到指定的节点上运行. # ...
- 5-18 Nacos配置中心 | RestTemplate
配置中心 什么是配置中心 所谓配置中心:将项目需要的配置信息保存在配置中心,需要读取时直接从配置中心读取,方便配置管理的微服务工具 我们可以将部分yml文件的内容保存在配置中心 一个微服务项目有很多子 ...
- 动手实践丨手把手教你用STM32做一个智能鱼缸
摘要:本文基于STM32单片机设计了一款基于物联网的智能鱼缸. 本文分享自华为云社区<基于STM32+华为云IOT设计的物联网鱼缸[玩转华为云]>,作者: DS小龙哥 . 1. 前言 为了 ...
- GIS技术在医疗行业的应用:利用切片地图发布技术解决dmetrix数字病理切片在线浏览
最近一直在研究切片地图发布技术,解决各种矢量和栅格数据的切片地图制作和发布问题.这块的技术在土地评估和调查类公司中应用较多,因为他们经常需要使用各地地图,传统的文件管理方式很难适应工作现状,如果将各种 ...
- Hadoop - MapReduce 过程
Hadoop - MapReduce 一.MapReduce设计理念 map--->映射 reduce--->归纳 mapreduce必须构建在hdfs之上的一种大数据离线计算框架 在线: ...
- Page和list的区别 mybatis
先看一段代码 点击查看代码 @Override public Result findUserPage(PageParam pageParam) { Page<SysUser> page = ...
- 吐泡泡_via牛客网
题目 链接:https://ac.nowcoder.com/acm/contest/28537/E 来源:牛客网 时间限制:C/C++ 1秒,其他语言2秒 空间限制:C/C++ 32768K,其他语言 ...
- 在 macOS 上搭建 Flutter 开发环境
下载 Flutter SDK flutter官网下载:https://flutter.io/sdk-archive/#macos 若上述链接无法访问,可通过GitHub下载 https://githu ...
- 别再用 System.currentTimeMillis 统计耗时了,太 Low,试试 Spring Boot 源码在用的 StopWatch吧,够优雅!
大家好,我是二哥呀! 昨天,一位球友问我能不能给他解释一下 @SpringBootApplication 注解是什么意思,还有 Spring Boot 的运行原理,于是我就带着他扒拉了一下这个注解的源 ...
- LyScript 获取上一条与下一条指令
LyScript 插件默认并没有提供上一条与下一条汇编指令的获取功能,当然你可以使用LyScriptTools工具包直接调用内置命令得到,不过这种方式显然在效率上并不理想,我们需要在LyScript插 ...