
MapReduce在Map端的Combiner和在Reduce端的Partitioner
1.Map端的Combiner.
通过单词计数WordCountApp.java的例子,如何在Map端设置Combiner...
只附录部分代码:
 /**

  * 以文本

  * hello    you

  * hello    me

  * 为例子.

  * map方法调用了两次,因为有两行

  * k2 v2 键值对的数量有几个?

  * 有4个.有四个单词.

  *

  * 会产生几个分组?

  * 产生3个分组.

  * 有3个不同的单词.

  *

  */

 public class WordCountApp {

     public static void main(String[] args) throws Exception {

         //程序在这里运行,要有驱动.

         Configuration conf = new Configuration();

         Job job = Job.getInstance(conf,WordCountApp.class.getSimpleName());

         //我们运行此程序通过运行jar包来执行.一定要有这句话.

         job.setJarByClass(WordCountApp.class);

         FileInputFormat.setInputPaths(job,args[0]);

         job.setMapperClass(WordCountMapper.class);//设置Map类

         job.setMapOutputKeyClass(Text.class);//设置Map的key

         job.setMapOutputValueClass(LongWritable.class);//设置Map的value

         job.setCombinerClass(WordCountReducer.class);//数据在Map端先进行 一次合并.

         /*

              这个setCombinerClass设置参数只能是一个继承了Reduce类的类.直接用我们定义的WordCountReducer.

             在单词技术的例子中,Map端产生了四个键值对,两个hello,you和me各一个.

             这样合并之后Map端最终只产生三个键值对.

             这样在Reduce端也只处理三个键值对,而不是没有合并之前的四个.

             这样Map端最终产生的键值对少了,Map端向Reduce端传递键值对占用的带宽就小.提高网络通信的速度.

             Reduce端接受键值对的数量变少,就减少了Reduce端处理键值对所需要的时间.

             以上就是Combiner的好处(在Map端对数据进行一次合并).

             Map端的合并和Reduce端的合并是不能相互取代的.

             在Map端进行的合并是局部合并,当前Map任务在它之中的合并.

             各个Map任务之间还是会 有相同的数据的.这些相同的数据要到Reduce端进行合并.

          */

         job.setReducerClass(WordCountReducer.class);//设置Reduce的类

         job.setOutputKeyClass(Text.class);//设置Reduce的key Reduce这个地方只有输出的参数可以设置. 方法名字也没有Reduce关键字区别于Map

         job.setOutputValueClass(LongWritable.class);//设置Reduce的value.

         FileOutputFormat.setOutputPath(job, new Path(args[1]));

         job.waitForCompletion(true);//表示结束了才退出,不结束不退出

     }
......................................................
2.Reduce端的Partitioner.
以流量统计TrafficCountApp.java的例子示例Reduce端设置Partitioner.
只附录部分代码:
 public class TrafficApp {

     public static void main(String[] args) throws Exception {

         Job job = Job.getInstance(new Configuration(), TrafficApp.class.getSimpleName());

         job.setJarByClass(TrafficApp.class);

         FileInputFormat.setInputPaths(job, args[0]);

         job.setMapperClass(TrafficMapper.class);

         job.setMapOutputKeyClass(Text.class);

         job.setMapOutputValueClass(TrafficWritable.class);

         job.setNumReduceTasks(2);//设定Reduce的数量为2

         job.setPartitionerClass(TrafficPartitioner.class);//设定一个Partitioner的类.

         /*

          *Partitioner是如何实现不同的Map输出分配到不同的Reduce中?

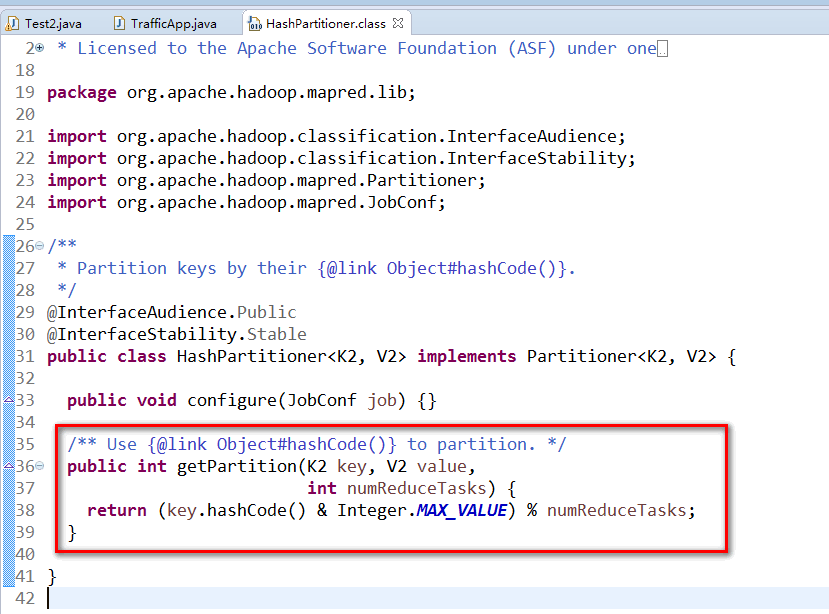
          *在不适用指定的Partitioner时,有 一个默认的Partitioner.

          *就是HashPartitioner.

          *其只有一行代码,其意思就是过来的key,不管是什么,模numberReduceTasks之后 返回值就是reduce任务的编号.

          *numberReduceTasks的默认值是1.  任何一个数模1(取余数)都是0.

          *这个地方0就是取编号为0的Reduce.(Reduce从0开始编号.)

          */

         job.setReducerClass(TrafficReducer.class);

         job.setOutputKeyClass(Text.class);

         job.setOutputValueClass(TrafficWritable.class);

         FileOutputFormat.setOutputPath(job, new Path(args[1]));

         job.waitForCompletion(true);

     }

     public static class TrafficPartitioner extends Partitioner<Text,TrafficWritable>{//k2,v2

         @Override

         public int getPartition(Text key, TrafficWritable value,int numPartitions) {

             long phoneNumber = Long.parseLong(key.toString());

             return (int)(phoneNumber%numPartitions);

         }

     }
.................................................
//============附录MapReduce中Reduce使用默认的HashPartitioner进行分组的源代码==============
MapReduce在Map端的Combiner和在Reduce端的Partitioner的更多相关文章
- Hadoop2.4.1 MapReduce通过Map端shuffle(Combiner)完成数据去重
package com.bank.service; import java.io.IOException; import org.apache.hadoop.conf.Configuration;im ...
- hadoop的压缩解压缩,reduce端join,map端join
hadoop的压缩解压缩 hadoop对于常见的几种压缩算法对于我们的mapreduce都是内置支持,不需要我们关心.经过map之后,数据会产生输出经过shuffle,这个时候的shuffle过程特别 ...
- 第2节 mapreduce深入学习:15、reduce端的join算法的实现
reduce端的join算法: 例子: 商品表数据 product: pidp0001,小米5,1000,2000p0002,锤子T1,1000,3000 订单表数据 order: pid ...
- Haoop MapReduce 的Partition和reduce端的二次排序
先贴一张原理图(摘自hadoop权威指南第三版) 实际中看了半天还是不太理解其中的Partition,和reduce端的二次排序,最终根据实验来结果来验证自己的理解 1eg 数据如下 20140101 ...
- 【转】reduce端缓存数据过多出现FGC,导致reduce生成的数据无法写到hdfs
转自 http://blog.csdn.net/bigdatahappy/article/details/41726389 转这个目的,是因为该贴子中调优思路不错,值得学习 搜索推荐有一个job,1 ...
- 深入理解Spark 2.1 Core (十一):Shuffle Reduce 端的原理与源代码分析
http://blog.csdn.net/u011239443/article/details/56843264 在<深入理解Spark 2.1 Core (九):迭代计算和Shuffle的原理 ...
- Asp.net SignalR 实现服务端消息推送到Web端
之前的文章介绍过Asp.net SignalR, ASP .NET SignalR是一个ASP .NET 下的类库,可以在ASP .NET 的Web项目中实现实时通信. 今天我 ...
- scala学习笔记(8): 列表的map,flatMap,zip和reduce
map,flatMap,zip和reduce函数可以让我们更容易处理列表函数. 1 map函数map将一个函数应用于列表的每一个元素并且将其作为一个新的列表返回.我们可以这样对列表的元素进行平方: s ...
- JavaScript高级编程——Array数组迭代(every()、filter()、foreach()、map()、some(),归并(reduce() 和reduceRight() ))
JavaScript高级编程——Array数组迭代(every().filter().foreach().map().some(),归并(reduce() 和reduceRight() )) < ...
随机推荐
- Win7下使Users数据与程序分离
大家知道,数据是用户最大的财富,但Windows系统默认的模式是将所有软件都安装在C盘,在Windows XP时代,数据文件夹会放在Document And Setting 目录下,在Win7时代,数 ...
- POJ 1679 The Unique MST (最小生成树)
The Unique MST 题目链接: http://acm.hust.edu.cn/vjudge/contest/124434#problem/J Description Given a conn ...
- (转)UML实践----用例图、类图、对象图、顺序图、协作图、状态图、活动图、组件图、配置图
面向对象的问题的处理的关键是建模问题.建模可以把在复杂世界的许多重要的细节给抽象出.许多建模工具封装了UML(也就是Unified Modeling Language™),这篇课程的目的是展示出UML ...
- codeforces 651B Beautiful Paintings
B. Beautiful Paintings time limit per test 1 second memory limit per test 256 megabytes input standa ...
- POJ 3468 A Simple Problem with Integers (线段树成段更新)
题目链接:http://poj.org/problem?id=3468 题意就是给你一组数据,成段累加,成段查询. 很久之前做的,复习了一下成段更新,就是在单点更新基础上多了一个懒惰标记变量.upda ...
- ssi整合报错org.apache.struts2.convention.ConventionsServiceImpl.determineResultPath(ConventionsServiceImpl.java:100)
java.lang.RuntimeException: Invalid action class configuration that references an unknown class name ...
- c# 自己制作一个简单的项目倒计时器
using System; using System.Collections.Generic; using System.ComponentModel; using System.Data; usin ...
- Oracle非重要文件恢复,redo、暂时文件、索引文件、password文件
增量备份的应用在recovery阶段.不再restore阶段 了解数据库设置表: SQL>desc database_properties Name ...
- fedora 20 注销
当系统只有一个用户和只有一个桌面环境时,Fedora 20将不会显示Log Out菜单. 如果你确实需要logout,可以通过执行gnome-session-quit命令来logout. 如果你确实需 ...
- Date Format, 时间戳格式化
// 对Date的扩展,将 Date 转化为指定格式的String // 月(M).日(d).小时(h).分(m).秒(s).季度(q) 可以用 1-2 个占位符, // 年(y)可以用 1-4 个占 ...