
jieba分词学习
具体项目在githut里面:
应用jieba库分词
1)利用jieba分词来统计词频:
对应文本为我们队伍的介绍:jianjie.txt:
项目名称:碎片
项目描述:制作一个网站,拾起日常碎片,记录生活点滴!
项目成员:孔潭活、何德新、吴淑瑶、苏咏梅
成员风采:
孔潭活:2015034643032
何德新:
学号:2015034643017
风格:咸鱼王
擅长技术:设计
编程兴趣:机器学习、人工智能。希望的软工角色:项目经理。
一句话宣言:持而盈之,不如其已。揣而锐之,不可常保。道可道非常道;名可名非常名
吴淑谣:
学号:2015034643018
风格:细水长流
擅长技术:无,对C++比较熟悉
编程兴趣:对数据进行处理和分析
希望的软工角色:代码能力比较薄弱,希望负责技术含量不是很高的模块
一句话宣言:推陈出新,永无止境。
苏咏梅:
学号:2015034643025
风格:越挫越勇
擅长技术:没有比较擅长的,对MySQL与Java感兴趣
希望的软工角色:需求分析员
一句话宣言:要成功,先发疯,头脑简单向前冲
课程目标
一个小而美记录生活碎片的网站
代码:
import jieba
import jieba.analyse
import xlwt #写入Excel表的库
if name == "main":
wbk = xlwt.Workbook(encoding='ascii')
sheet = wbk.add_sheet("wordCount") # Excel单元格名字
word_lst = []
key_list = []
for line in open('jianjie.txt'): # jianjie.txt是需要分词统计的文档
item = line.strip('\n\r').split('\t') # 制表格切分
# print item
tags = jieba.analyse.extract_tags(item[0]) # jieba分词
for t in tags:
word_lst.append(t)
word_dict = {}
with open("wordCount.txt", 'w') as wf2: # 打开文件
for item in word_lst:
if item not in word_dict: # 统计数量
word_dict[item] = 1
else:
word_dict[item] += 1
for item in word_lst:
if word_dict[item]==1:
del word_dict[item]
orderList = list(word_dict.values())
orderList.sort(reverse=True)
# print orderList
for i in range(len(orderList)):
for key in word_dict:
if word_dict[key] == orderList[i]:
wf2.write(key + ' ' + str(word_dict[key]) + '\n') # 写入txt文档
key_list.append(key)
word_dict[key] = 0
for i in range(len(key_list)):
sheet.write(i, 1, label=orderList[i])
sheet.write(i, 0, label=key_list[i])
wbk.save('wordCount.xls') # 保存为 wordCount.xls文件
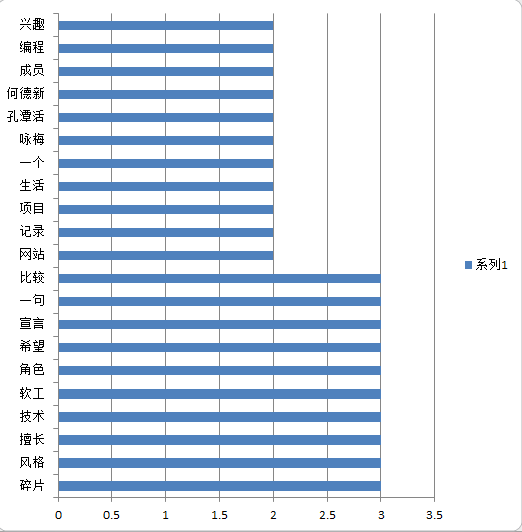
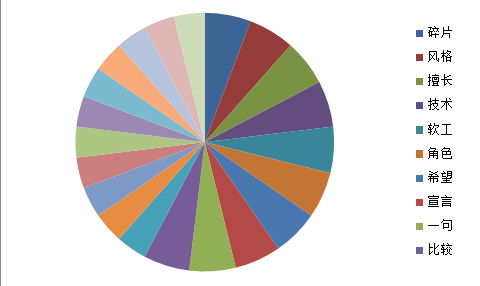
2)统计的词频会输出两个文件一个是txt文件另外一个是xls文件名字都是wordCount
我们利用excel来绘图
jieba分词学习的更多相关文章
- Lucene.net(4.8.0) 学习问题记录五: JIEba分词和Lucene的结合,以及对分词器的思考
前言:目前自己在做使用Lucene.net和PanGu分词实现全文检索的工作,不过自己是把别人做好的项目进行迁移.因为项目整体要迁移到ASP.NET Core 2.0版本,而Lucene使用的版本是3 ...
- jieba分词(2)
结巴分词系统中实现了两种关键词抽取法,一种是TF-IDF关键词抽取算法另一种是TextRank关键词抽取算法,它们都是无监督的算法. 以下是两种算法的使用: #-*- coding:utf-8 -*- ...
- jieba分词原理-DAG(NO HMM)
最近公司在做一个推荐系统,让我给论坛上的帖子找关键字,当时给我说让我用jieba分词,我周末回去看了看,感觉不错,还学习了一下具体的原理 首先,通过正则表达式,将文章内容切分,形成一个句子数组,这个比 ...
- jieba分词流程及部分源码解读(一)
首先我们来看一下jieba分词的流程图: 结巴中文分词简介 1)支持三种分词模式: 精确模式:将句子最精确的分开,适合文本分析 全模式:句子中所有可以成词的词语都扫描出来,速度快,不能解决歧义 搜索引 ...
- 自然语言处理课程(二):Jieba分词的原理及实例操作
上节课,我们学习了自然语言处理课程(一):自然语言处理在网文改编市场的应用,了解了相关的基础理论.接下来,我们将要了解一些具体的.可操作的技术方法. 作为小说爱好者的你,是否有设想过通过一些计算机工具 ...
- jieba分词-强大的Python 中文分词库
1. jieba的江湖地位 NLP(自然语言)领域现在可谓是群雄纷争,各种开源组件层出不穷,其中一支不可忽视的力量便是jieba分词,号称要做最好的 Python 中文分词组件. 很多人学习pytho ...
- python使用matplotlib画图,jieba分词、词云、selenuium、图片、音频、视频、文字识别、人脸识别
一.使用matplotlib画图 关注公众号"轻松学编程"了解更多. 使用matplotlib画柱形图 import matplotlib from matplotlib impo ...
- widows下jieba分词的安装
在切词的时候使用到jieba分词器,安装如下: 切入到结巴包,执行 python setup.py install 安装后,可以直接在代码中引用: import jieba
- 【原】关于使用jieba分词+PyInstaller进行打包时出现的一些问题的解决方法
错误现象: 最近在做一个小项目,在Python中使用了jieba分词,感觉非常简洁方便.在Python端进行调试的时候没有任何问题,使用PyInstaller打包成exe文件后,就会报错: 错误原因分 ...
随机推荐
- webstorm 2017 激活
参考:https://blog.csdn.net/wangyingwing/article/details/79119592
- 2-4 R语言基础 列表
#列表list > l1 <- list("a",2,10L,3+4i,TRUE) #每个元素没有名字> l1[[1]][1] "a" [[2 ...
- SAP BPC方案介绍
refer to http://sapper.blog.sohu.com/166039991.html SAP/BPC简介: 全面预算管理是联系公司战略目标与日常运营的重要纽带,它上到战略层面.下到执 ...
- node.js cheerio API
安装 npm install cheerio load var cheerio = require('cheerio'), $ = cheerio.load('<ul id=“fruits”&g ...
- 20145236《网络对抗》Exp1 逆向及Bof基础
20145236<网络对抗>Exp 1逆向及Bof基础 一.实践目标 运行原本不可访问的代码片段 强行修改程序执行流 以及注入运行任意代码. 二.基础知识及实践准备 理解EIP寄存器及其功 ...
- nginx反向代理和tomcat集群(适用于ubutnu16.04及其centos7)
下面示例,本人亲测有效 为什么要反向代理和集群? 因为并发问题,很多请求如果全部分发给一个tomcat,一个tomcat优化最好的话,据说可达到800负载,但是面对成千上万的请求,单单一个tomcat ...
- 多线程之CAS
在JDK 5之前Java语言是靠synchronized关键字保证同步的,这会导致有锁 锁机制存在以下问题: (1)在多线程竞争下,加锁.释放锁会导致比较多的上下文切换和调度延时,引起性能问题. (2 ...
- scrapy(一)scrapy 安装问题
一.安装scrapy pip install scrapy 二.出现Microsoft Visual C++ 14.0相关问题 注:若出现以下安装错误 building 'twisted.test.r ...
- SQL 提高性能
参考博客:http://www.cnblogs.com/jiekzou/p/5988099.html 非常感谢博主分享. 1.set nocount on 关闭行基数信息,减少网络通信,提高程序性能 ...
- Bat 参数去引号(各种去引号的奇葩方式,三种变量互转),普通变量不能直接去掉外层引号
很多情况下,我们需要脱除一个字符串中可能会存在的引号,然后在加上自己的引 号使其中的特殊字符(命令连接符& .| .&&.||,命令行参数界定符Space .tab . ; . ...