
035 spark与hive的集成
一:介绍
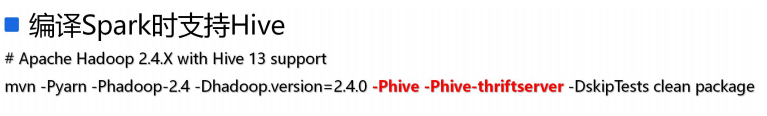
1.在spark编译时支持hive
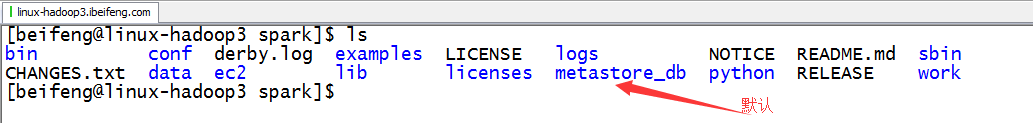
2.默认的db
当Spark在编译的时候给定了hive的支持参数,但是没有配置和hive的集成,此时默认使用hive自带的元数据管理:Derby数据库。
二:具体集成
1.将hive的配合文件hive-site.xml添加到spark应用的classpath中(相当于拷贝)
将hive-site.xml拷贝到${SPARK_HOME}/conf下。
下面使用软连接:

2.第二步集成
根据hive的配置参数hive.metastore.uris的情况,采用不同的集成方式
分别:
1. hive.metastore.uris没有给定配置值,为空(默认情况)
SparkSQL通过hive配置的javax.jdo.option.XXX相关配置值直接连接metastore数据库直接获取hive表元数据
但是,需要将连接数据库的驱动添加到Spark应用的classpath中
2. hive.metastore.uris给定了具体的参数值
SparkSQL通过连接hive提供的metastore服务来获取hive表的元数据
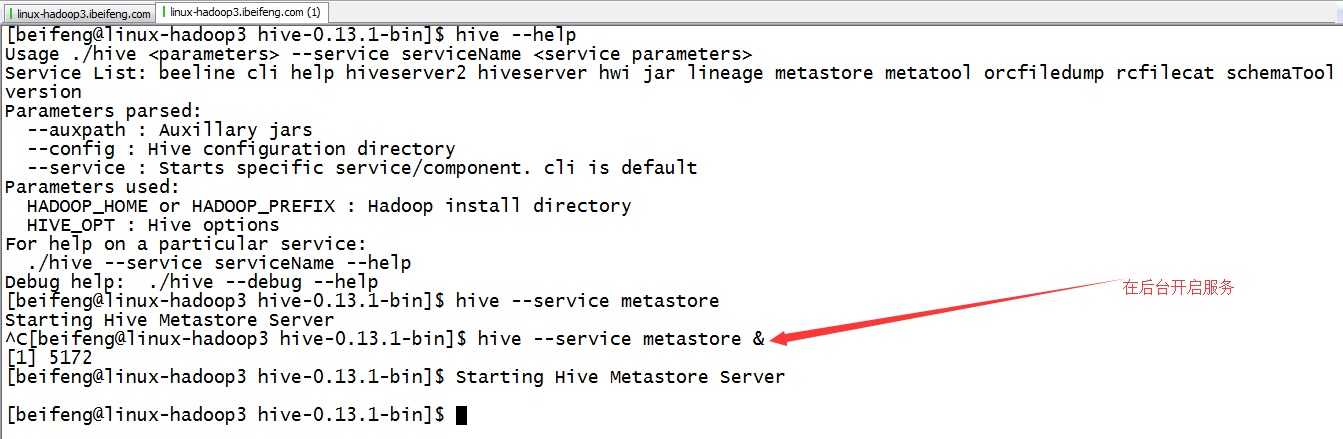
直接启动hive的metastore服务即可完成SparkSQL和Hive的集成
$ hive --service metastore &
3.使用hive-site.xml配置的方式
配置hive.metastore.uris的方式。

4.启动hive service metastore服务
如果没有配置全局hive,就使用bin/hive --service metastore &
三:测试
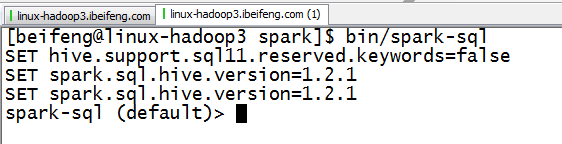
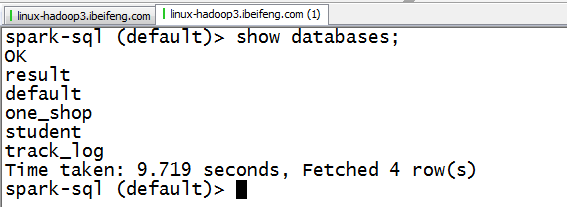
1.spark-sql
2.使用
四:特殊点(其他在hive中可以使用的sql,在spark-sql中都可以使用)
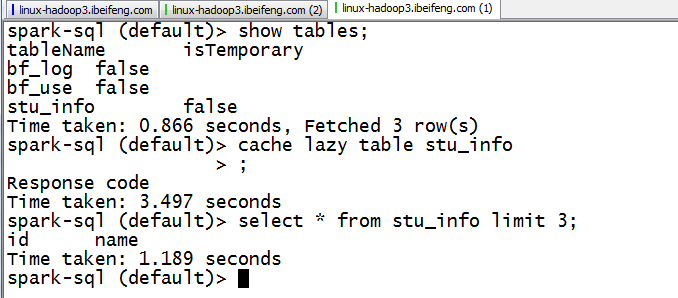
1.cache
cache是立即执行的,然后使用下面的可以懒加载。
uncache是立即执行的。
五:使用spark-shell
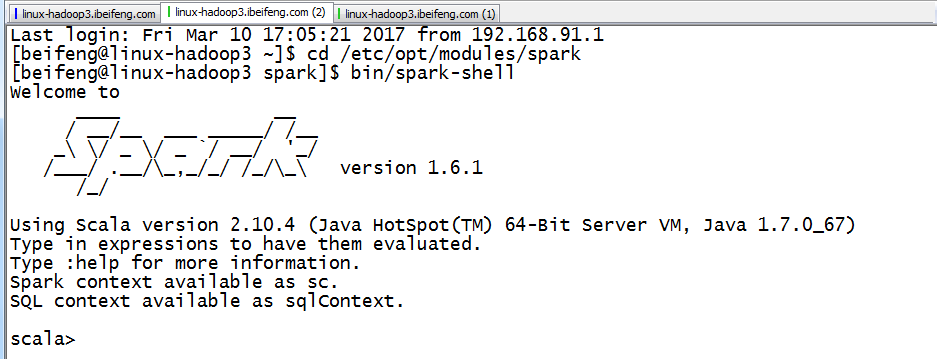
1.启动
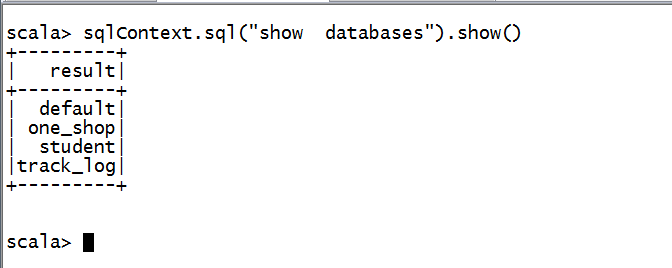
2.使用
可以使用sqlContext . ,然后使用Tab进行补全。
show默认显示20行。
六:补充说明:Spark应用程序第三方jar文件依赖解决方案
1. 将第三方jar文件打包到最终形成的spark应用程序jar文件中
这种使用的场景是,第三方的jar包不是很大的情况。
2. 使用spark-submit提交命令的参数: --jars
这个使用的场景:使用spark-submit命令的机器上存在对应的jar文件,而且jar包不是太多
至于集群中其他机器上的服务需要该jar文件的时候,通过driver提供的一个http接口来获取该jar文件的(http://192.168.187.146:50206/jars/mysql-connector-java-5.1.27-bin.jar Added By User)
方式:
$ bin/spark-shell --jars /opt/cdh-5.3.6/hive/lib/mysql-connector-java-5.1.27-bin.jar:这样就不再需要配置hive.metastore.uris参数配置。
使用“,”分隔多个jar。
3. 使用spark-submit提交命令的参数: --packages
这个场景是:如果找不到jar会自动下载,也可以自己设定源。
作用:
--packages Comma-separated list of maven coordinates of jars to include on the driver and executor classpaths. Will search the local maven repo, then maven central and any additional remote repositories given by --repositories.
The format for the coordinates should be groupId:artifactId:version. 这一个说明是spark-submit后的package参数的说明。
方式:
$ bin/spark-shell --packages mysql:mysql-connector-java:5.1.27 --repositories http://maven.aliyun.com/nexus/content/groups/public/
下载路径:
# 默认下载的包位于当前用户根目录下的.ivy/jars文件夹中,即是home/beifeng/.ivy/jars
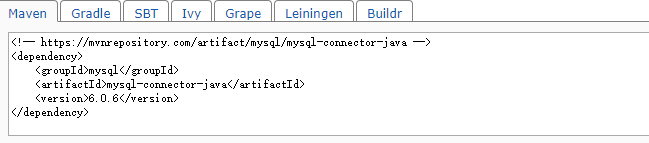
根据上面的maven来写格式。
4.更改Spark的配置信息:SPARK_CLASSPATH, 将第三方的jar文件添加到SPARK_CLASSPATH环境变量中
使用场景:要求Spark应用运行的所有机器上必须存在被添加的第三方jar文件
做法:
-4.1 创建一个保存第三方jar文件的文件夹:
$ mkdir external_jars
-4.2 修改Spark配置信息
$ vim conf/spark-env.sh
SPARK_CLASSPATH=$SPARK_CLASSPATH:/opt/cdh-5.3.6/spark/external_jars/*
-4.3 将依赖的jar文件copy到新建的文件夹中
$ cp /opt/cdh-5.3.6/hive/lib/mysql-connector-java-5.1.27-bin.jar ./external_jars/
-4.4 测试
$ bin/spark-shell
scala> sqlContext.sql("select * from common.emp").show
备注:
如果spark on yarn(cluster),如果应用依赖第三方jar文件,最终解决方案:将第三方的jar文件copy到${HADOOP_HOME}/share/hadoop/common/lib文件夹中(Hadoop集群中所有机器均要求copy)
035 spark与hive的集成的更多相关文章
- spark与hive的集成
一:介绍 1.在spark编译时支持hive 2.默认的db 当Spark在编译的时候给定了hive的支持参数,但是没有配置和hive的集成,此时默认使用hive自带的元数据管理:Derby数据库. ...
- Spark&Hive:如何使用scala开发spark访问hive作业,如何使用yarn resourcemanager。
背景: 接到任务,需要在一个一天数据量在460亿条记录的hive表中,筛选出某些host为特定的值时才解析该条记录的http_content中的经纬度: 解析规则譬如: 需要解析host: api.m ...
- 使用spark对hive表中的多列数据判重
本文处理的场景如下,hive表中的数据,对其中的多列进行判重deduplicate. 1.先解决依赖,spark相关的所有包,pom.xml spark-hive是我们进行hive表spark处理的关 ...
- Spark 读写hive 表
spark 读写hive表主要是通过sparkssSession 读表的时候,很简单,直接像写sql一样sparkSession.sql("select * from xx") 就 ...
- 大数据核心知识点:Hbase、Spark、Hive、MapReduce概念理解,特点及机制
今天,上海尚学堂大数据培训班毕业的一位学生去参加易普软件公司面试,应聘的职位是大数据开发.面试官问了他10个问题,主要集中在Hbase.Spark.Hive和MapReduce上,基础概念.特点.应用 ...
- 使用spark访问hive错误记录
在spark集群中执行./spark-shell时报以下错误: 18/07/23 10:02:39 WARN DataNucleus.Connection: BoneCP specified but ...
- Spark访问Hive表
知识点1:Spark访问HIVE上面的数据 配置注意点:. 1.拷贝mysql-connector-java-5.1.38-bin.jar等相关的jar包到你${spark_home}/lib中(sp ...
- [Spark][Hive][Python][SQL]Spark 读取Hive表的小例子
[Spark][Hive][Python][SQL]Spark 读取Hive表的小例子$ cat customers.txt 1 Ali us 2 Bsb ca 3 Carls mx $ hive h ...
- Spark SQL -- Hive
使用Saprk SQL 操作Hive的数据 前提准备: 1.启动Hdfs,hive的数据存储在hdfs中; 2.启动hive -service metastore,元数据存储在远端,可以远程访问; 3 ...
随机推荐
- Linux通过端口转发来访问内网服务(端口转发访问阿里云Redis数据库等服务)
# 安装rinetd wget http://www.boutell.com/rinetd/http/rinetd.tar.gz&&tar -xvf rinetd.tar.gz& ...
- 新年的展望,2018 hello world~
虽然离$2017$到$2018$的跨年已经过去很久了,但还是想写点东西试图拯救一下最近有些颓势的自己~ $2017$对我来说是意义重大的一年,这一年里,我有欢笑也有泪水,有收获也有挫折,有坚强也有脆弱 ...
- 解题:NOI 2010 超级钢琴
题面 WC时候写的题,补一下 做法比较巧妙:记录每个位置和它当前对应区间的左右端点,做前缀和之后重载一下小于号,用优先队列+ST表维护当前最大值.这样贡献就是区间最大值和端点左边差分一下,可以O(1) ...
- 【codevs1006】等差数列
题目大意:给定一个 N(N <= 100) 个数字组成的集合,从中取出若干数字组成的等差数列最长是多少. 题解:由于这道题数据范围较小,可以直接依据每个数字进行枚举.首先,这道题给出的是一个集合 ...
- asp.net mvc 全局权限过滤器及继成权限方法
全局权限过滤器 //----------------------------------------------------------------------- // <copyright f ...
- word默认字体与大小
对于红色地方单击,“正文框”按右键+修改 修改字体大小 修改中文和西文时的字体 注意宋体和宋体 (中文正文)是不同的
- openstack项目【day23】:openstack组件介绍
本节内容 openstack介绍 openstack项目(服务名是项目名的别名) openstack运行流程 openstack各组件详解 一:openstack介绍 open ...
- vue中assets文件夹与static文件夹的区别
1.如果这些产品图片文件“万年不变”,放在 /static 目录里,(不需要使用require将这些图片作为模块来引用) var products = [{ img: '/static/img/pro ...
- 2018年10月14日ICPC南京站参赛总结
这次比赛消耗掉了我们全部的信心和精力 在热身赛上,总体来说还是比较愉快的,这个时候心态就不对 正赛的时候我们遇到了A题签到题 我一开始是读错了题意了,认为这个题是一个裸的SG函数,而且那么多人秒过 W ...
- ngx_lua_API 指令详解(三)怎样理解 cosocket指令
参考:https://moonbingbing.gitbooks.io/openresty-best-practices/content/ngx_lua/whats_cosocket.html 春哥演 ...