
spark与hive的集成
一:介绍
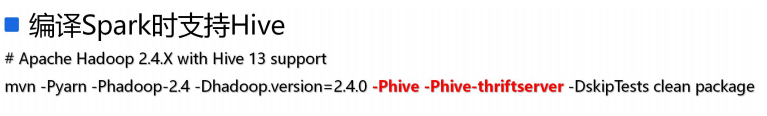
1.在spark编译时支持hive
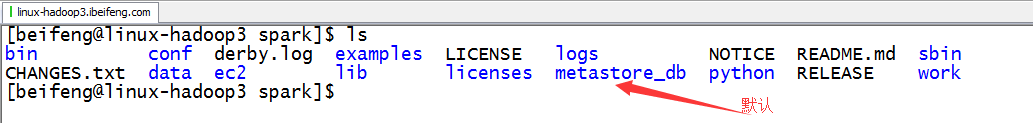
2.默认的db
当Spark在编译的时候给定了hive的支持参数,但是没有配置和hive的集成,此时默认使用hive自带的元数据管理:Derby数据库。
二:具体集成
1.将hive的配合文件hive-site.xml添加到spark应用的classpath中(相当于拷贝)

2.第二步集成
根据hive的配置参数hive.metastore.uris的情况,采用不同的集成方式
分别为(区别):
-1. hive.metastore.uris没有给定配置值,为空(默认情况)
SparkSQL通过hive配置的javax.jdo.option.XXX相关配置值直接连接metastore数据库直接获取hive表元数据
--1.1 需要将连接数据库的驱动添加到Spark应用的classpath中
-2. hive.metastore.uris给定了具体的参数值
SparkSQL通过连接hive提供的metastore服务来获取hive表的元数据
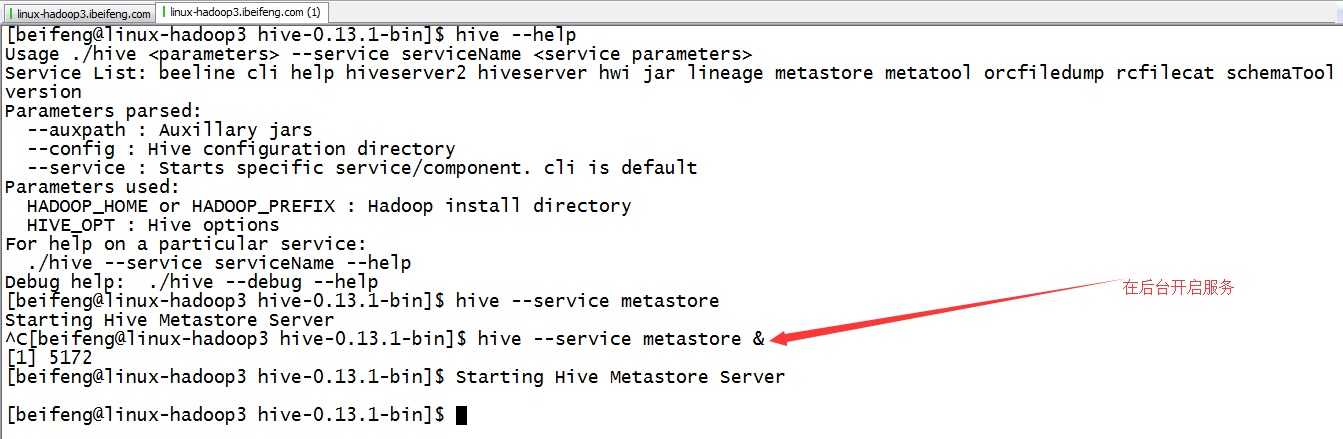
--2.1 直接启动hive的metastore服务即可完成SparkSQL和Hive的集成
$ hive --service metastore &
3.使用hive-site.xml配置的方式

4.启动hive service metastore服务
三:测试
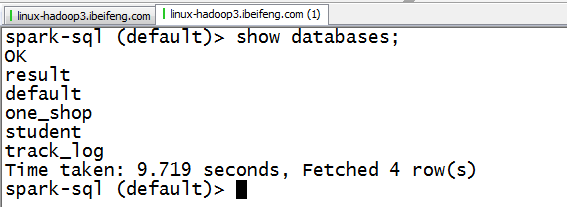
1.spark-sql
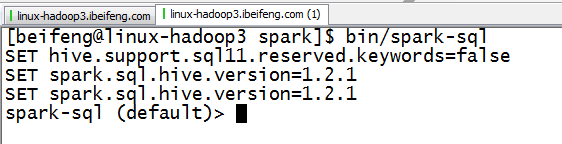
2.使用
四:特殊点(其他在hive中可以使用的sql,在spark-sql中都可以使用)
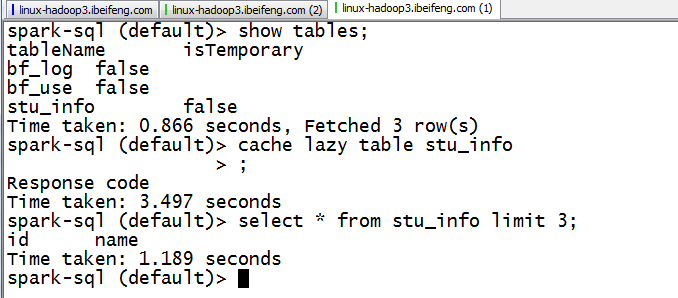
1.cache
五:使用spark-shell
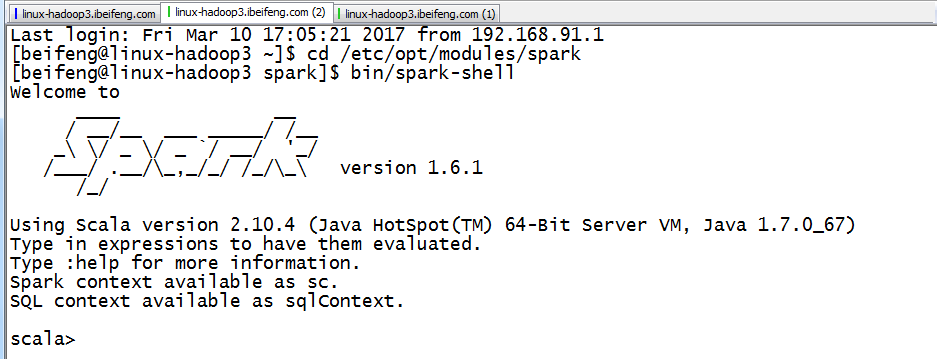
1.启动
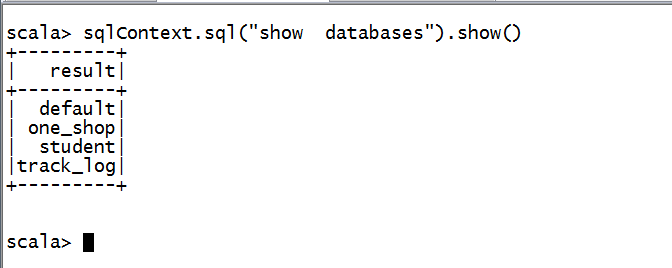
2.使用
六:补充说明:Spark应用程序第三方jar文件依赖解决方案
1. 将第三方jar文件打包到最终形成的spark应用程序jar文件中
这种使用的场景是,第三方的jar包不是很大的情况。
2. 使用spark-submit提交命令的参数: --jars
这个使用的场景:使用spark-submit命令的机器上存在对应的jar文件
至于集群中其他机器上的服务需要该jar文件的时候,通过driver提供的一个http接口来获取该jar文件的(http://192.168.187.146:50206/jars/mysql-connector-java-5.1.27-bin.jar Added By User)
$ bin/spark-shell --jars /opt/cdh-5.3.6/hive/lib/mysql-connector-java-5.1.27-bin.jar
3. 使用spark-submit提交命令的参数: --packages
这个场景是:如果找不到jar会自动下载,也可以自己设定源。
--packages Comma-separated list of maven coordinates of jars to include on the driver and executor classpaths. Will search the local maven repo, then maven central and any additional remote repositories given by --repositories.
The format for the coordinates should be groupId:artifactId:version.
http://mvnrepository.com/artifact/mysql/mysql-connector-java/5.1.27
$ bin/spark-shell --packages mysql:mysql-connector-java:5.1.27 --repositories http://maven.aliyun.com/nexus/content/groups/public/
# 默认下载的包位于当前用户根目录下的.ivy/jars文件夹中
4.更改Spark的配置信息:SPARK_CLASSPATH, 将第三方的jar文件添加到SPARK_CLASSPATH环境变量中
使用场景:要求Spark应用运行的所有机器上必须存在被添加的第三方jar文件
做法:
-4.1 创建一个保存第三方jar文件的文件夹:
$ mkdir external_jars
-4.2 修改Spark配置信息
$ vim conf/spark-env.sh
SPARK_CLASSPATH=$SPARK_CLASSPATH:/opt/cdh-5.3.6/spark/external_jars/*
-4.3 将依赖的jar文件copy到新建的文件夹中
$ cp /opt/cdh-5.3.6/hive/lib/mysql-connector-java-5.1.27-bin.jar ./external_jars/
-4.4 测试
$ bin/spark-shell
scala> sqlContext.sql("select * from common.emp").show
备注:
如果spark on yarn(cluster),如果应用依赖第三方jar文件,最终解决方案:将第三方的jar文件copy到${HADOOP_HOME}/share/hadoop/common/lib文件夹中(Hadoop集群中所有机器均要求copy)
备注:如果spark on yarn(cluster),如果应用依赖第三方jar文件,最终解决方案:
spark与hive的集成的更多相关文章
- 035 spark与hive的集成
一:介绍 1.在spark编译时支持hive 2.默认的db 当Spark在编译的时候给定了hive的支持参数,但是没有配置和hive的集成,此时默认使用hive自带的元数据管理:Derby数据库. ...
- Spark&Hive:如何使用scala开发spark访问hive作业,如何使用yarn resourcemanager。
背景: 接到任务,需要在一个一天数据量在460亿条记录的hive表中,筛选出某些host为特定的值时才解析该条记录的http_content中的经纬度: 解析规则譬如: 需要解析host: api.m ...
- 使用spark对hive表中的多列数据判重
本文处理的场景如下,hive表中的数据,对其中的多列进行判重deduplicate. 1.先解决依赖,spark相关的所有包,pom.xml spark-hive是我们进行hive表spark处理的关 ...
- Spark 读写hive 表
spark 读写hive表主要是通过sparkssSession 读表的时候,很简单,直接像写sql一样sparkSession.sql("select * from xx") 就 ...
- 大数据核心知识点:Hbase、Spark、Hive、MapReduce概念理解,特点及机制
今天,上海尚学堂大数据培训班毕业的一位学生去参加易普软件公司面试,应聘的职位是大数据开发.面试官问了他10个问题,主要集中在Hbase.Spark.Hive和MapReduce上,基础概念.特点.应用 ...
- 使用spark访问hive错误记录
在spark集群中执行./spark-shell时报以下错误: 18/07/23 10:02:39 WARN DataNucleus.Connection: BoneCP specified but ...
- Spark访问Hive表
知识点1:Spark访问HIVE上面的数据 配置注意点:. 1.拷贝mysql-connector-java-5.1.38-bin.jar等相关的jar包到你${spark_home}/lib中(sp ...
- [Spark][Hive][Python][SQL]Spark 读取Hive表的小例子
[Spark][Hive][Python][SQL]Spark 读取Hive表的小例子$ cat customers.txt 1 Ali us 2 Bsb ca 3 Carls mx $ hive h ...
- Spark SQL -- Hive
使用Saprk SQL 操作Hive的数据 前提准备: 1.启动Hdfs,hive的数据存储在hdfs中; 2.启动hive -service metastore,元数据存储在远端,可以远程访问; 3 ...
随机推荐
- [WPF] UserControl vs CustomControl
介绍 WPF中有两种控件:UserControl和CustomControl,但是这两者有什么区别呢?这篇博客中将介绍两者之间的区别,这样可以在项目中合理的使用它们. UserControl 将多个W ...
- 迁移学习-Transfer Learning
迁移学习两种类型: ConvNet as fixed feature extractor:利用在大数据集(如ImageNet)上预训练过的ConvNet(如AlexNet,VGGNet),移除最后几层 ...
- H - transaction transaction transaction
https://vjudge.net/contest/184514#problem/H 题意: 一个商人为了赚钱,在城市之间倒卖商品.有n个城市,每个城市之间有且只有一条无向边连通.给出n个城市的货物 ...
- HTTP协议Keep-Alive模式详解
详见:http://blog.yemou.net/article/query/info/tytfjhfascvhzxcytp22 HTTP协议Keep-Alive模式详解 1.什么是Keep-Aliv ...
- C#构建DataTable(转)
Asp.net DataTable添加列和行的方法 方法一: DataTable tblDatas = new DataTable("Datas"); DataColumn dc ...
- Mysql介绍和实践总结
本文首先介绍mysql的安装和基本使用.进阶操作.讲解mysql的导入导出和自动备份,然后介绍安全模式修改密码和mysql的全文本搜索功能,最后记录了个人使用mysql中遇到的问题集. 开始安装: s ...
- linux使用bbswitch+nvidia-xrun取代bumblebee
nvidia-xrun的比bumblebee使用nvidia optimus的性能更好,关键是xrun支持Vulkan. 本文保存并更新在github:levinit/itnotes/linux/ar ...
- !JS实战之随机像素图
JavaScript实例分享之----画随机像素图.随机像素图(作者自己取得名字)指的是一张图片上每一个像素的颜色都是随机的.此时应该能联想到这幅图多么眼花缭乱,好吧,我们用JS来实现它的原因是JS很 ...
- 201521123108 《Java程序设计》第5周学习总结
1. 本章学习总结 2. 书面作业 Q1. 代码阅读:Child压缩包内源代码 1.1 com.parent包中Child.java文件能否编译通过?哪句会出现错误?试改正该错误.并分析输出结果. 答 ...
- 201521123065《Java程序设计》第1周学习总结
1. 本周学习总结 java是门语言较为简单,并且可以在多种平台运行编译的语言. JDK是java开发工具,可以将源程序编译成字节码. JRE:java运行环境. JVM:虚拟机,是java实现多平台 ...