
jdbc调用sparksql on yarn
spark sql访问hive表
1.将hive-site.xml拷贝到spark目录下conf文件夹
2.(非必需)将mysql的jar包引入到spark的classpath,方式有如下两种:
方式1:需要在$SPARK_HOME/conf/spark-env.sh中的SPARK_CLASSPATH添加jdbc驱动的jar包
export SPARK_CLASSPATH=$SPARK_CLASSPATH:/usr/local/hive-1.2.1/lib/mysql-connector-java-5.1.31-bin.jar
方式2:在spark-sql命令中指定driver-class-path,如
local模式
spark-sql --driver-class-path /usr/local/hive-1.2.1/lib/mysql-connector-java-5.1.31-bin.jar
集群模式:
spark-sql --master yarn --driver-class-path /usr/local/hive-1.2.1/lib/mysql-connector-java-5.1.31-bin.jar
开启HiverServer2
默认模式为yarn-client,HiverServer作为一个yarn的应用运行,如图:

内网连接:

sbin/start-thriftserver.sh --master yarn --driver-class-path /usr/local/hive-1.2.1/lib/mysql-connector-java-5.1.31-bin.jar

外网连接:

sbin/start-thriftserver.sh --hiveconf hive.server2.thrift.port=10000 --hiveconf hive.server2.thrift.bind.host=hadoop-master --master yarn --driver-class-path /usr/local/hive-1.2.1/lib/mysql-connector-java-5.1.31-bin.jar
如果指定yarn-cluster模式会报错:

停止thriftserver
sbin/stop-thriftserver.sh
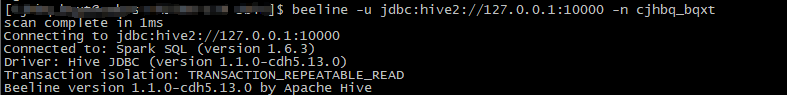
beeline客户端访问thrift server
通过-n指定sql以那个用户执行,下面两个ip是hadoop-master的内外网地址
beeline -u jdbc:hive2://10.9.2.100:10000 -n hive --hiveconf mapreduce.job.queuename=mxbs

beeline -u jdbc:hive2://122.23.368.32:10000 -n hive --hiveconf mapreduce.job.queuename=mxbs
java样例程序
import java.sql.*;

import java.util.HashSet;

import java.util.Set;

public class SimpleDemo1 {

    private final static Set<String> HIVE_CONFIGS = initConfig();

    /**

     * hive conf设置

     *

     * @return

     */

    private static Set<String> initConfig() {

        Set<String> configs = new HashSet<String>();

        configs.add("set mapreduce.job.queuename=queue1");

        configs.add("set hive.cli.print.header=false");

        return configs;

    }

    /**

     * 临时去掉所有错误处理和资源关闭

     * @param args

     * @throws ClassNotFoundException

     * @throws SQLException

     */

    public static void main(String[] args) throws ClassNotFoundException, SQLException {

        String jdbcdriver = "org.apache.hive.jdbc.HiveDriver";

        String jdbcurl = "jdbc:hive2://127.0.0.1:10000";

        String username = "user001";

        String password = "";

        Connection conn = null;

        Statement statement = null;

        Class.forName(jdbcdriver);

        DriverManager.setLoginTimeout(20);

        conn = DriverManager.getConnection(jdbcurl, username, password);

        statement = conn.createStatement();

        for (String config : HIVE_CONFIGS) {

            statement.execute(config);

        }

        String sql = "select * from db1.test limit 10";

        print(statement.executeQuery(sql));

    }

}
maven引用:
<hadoop.version>2.6.0-cdh5.13.0</hadoop.version>

<hive-jdbc.version>1.1.0</hive-jdbc.version>

<dependency>

    <groupId>org.apache.hive</groupId>

    <artifactId>hive-jdbc</artifactId>

    <version>${hive-jdbc.version}</version>

</dependency>

<dependency>

    <groupId>org.apache.hadoop</groupId>

    <artifactId>hadoop-common</artifactId>

    <version>${hadoop.version}</version>

</dependency>
jdbc调用sparksql on yarn的更多相关文章
- jdbc调用sparksql
将hive-site.xml拷贝到spark目录下conf文件夹 local模式 spark-sql --driver-class-path /usr/local/hive-1.2.1/lib/mys ...
- Java数据库连接——JDBC调用存储过程,事务管理和高级应用
一.JDBC常用的API深入详解及存储过程的调用 相关链接:Jdbc调用存储过程 1.存储过程(Stored Procedure)的介绍 我们常用的操作数据库语言SQL语句在执行的时候需要先编译,然后 ...
- 使用 JDBC 调用函数 & 存储过程
/** * 如何使用 JDBC 调用存储在数据库中的函数或存储过程 */ @Test public void testCallableStatment() { Connection connectio ...
- shell脚本调用spark-sql
为了更方便的查询并产生报表, 需要使用shell脚本调用spark-sql spark/bin/spark-sql --master spark://host:7077 -f ${SQL_FILE} ...
- jdbc调用存储过程的方法
----------------------------jdbc调用存储过程的方法---------------------------------------------------private ...
- 使用JDBC调用数据库的存储过程
本篇讲述如何使用JDBC来调用MySQL数据库中的存储过程.建议在学习如何使用JDBC调用存储过程前,请先了解如何在数据库中使用存储过程. 存储过程是指在数据库系统中,一组为了完成特定功能的SQL语句 ...
- JDBC调用存储过程
一. JDBC调用存储过程 (1)使用存储过程SQL编写的程序代码,等一段语句和控制流语句.在创建时被编译成机器代码和存储在数据库中的client转让. 存储过程具有以下优势: 1.所生成的机器代码被 ...
- Java数据库连接--JDBC调用存储过程,事务管理和高级应用
相关链接:Jdbc调用存储过程 一.JDBC常用的API深入详解及存储过程的调用 1.存储过程的介绍 我们常用的操作数据库语言SQL语句在执行的时候要先进行编译,然后执行,而存储过程是在大型数据库系统 ...
- JDBC调用存储过程的例子
下面是我学到了Oracle存储过程,在这里跟大家简单的分享一下利用JDBC调用存储过程的例子: 废话就不啰嗦,现在就直接上机代码. 首先我利用的是Oracle中默认的 scott 数据库里的 emp员 ...
随机推荐
- Linux之VIM常用功能
介绍:vim包含三种模式分别为 命令模式:浏览文件,临时更改vim的工作方式,对字符批量处理(也可进行配置) 插入模式:对文件内容进行编辑 退出模式:退出VIM操作 一.命令模式 1.调整vi ...
- Linux:tr命令详解
tr tr命令可以对来自标准输入的字符进行替换.压缩和删除 语法 tr(选项)(SET1 SET2) 选项 -c或——complerment:取代所有不属于第一字符集的字符: -d或——delete: ...
- (一) ffmpeg filter学习-使用流程
FFMPEG中有一个类库:libavfilter.该类库提供了各种视音频过滤器.之前一直没有怎么使用过这个类库,最近看了一下它的使用说明,发现还是很强大的,有很多现成的filter供使用,完成视频的处 ...
- Objective-C-----协议protocol,代码块block,分类category
概述 ObjC的语法主要基于smalltalk进行设计的,除了提供常规的面向对象特性外,还增加了很多其他特性,本文将重点介绍objective-C中一些常用的语法特性. 当然这些内容虽然和其他高级语言 ...
- js之购物车案例
这里主要提供思路: 一共两个页面通过原生来实现,我们需要对cookie进行封装. 在商品列表页,我们将点击添加的商品放入一个对象中,而后将该对象放入数组中,一个对象可以说就是一个商品.在购物车页面 ...
- Percona 工具 pt-query-digest的使用
pt-query-digest说明 pt-query-digest 用来格式化分析MySQL产生的日志,如:慢查询日志.二进制日志.通用日志,根据不同的条件进行分析并生成报告. pt-query-di ...
- linux自学(九)之开始centos学习,安装数据库MariaDB
上一篇:linux自学(八)之开始centos学习,安装tomcat 数据库我们不安装mysql,我网上看了好多资料发现mysql安装比较麻烦,我们这里安装同一个父亲的产品MariaDB.驱动,端口等 ...
- Java并发--同步容器
为了方便编写出线程安全的程序,Java里面提供了一些线程安全类和并发工具,比如:同步容器.并发容器.阻塞队列.Synchronizer(比如CountDownLatch).今天我们就来讨论下同步容器. ...
- LOJ2359. 「NOIP2016」天天爱跑步【树上差分】
LINK 思路 首先发现如果对于一个节点,假设一个节点需要统计从字数内来的贡献 需要满足\(dep_u - dep_s = w_u\) 这个条件其实可以转化成\(dep_u - w_u = dep_s ...
- 《selenium2 python 自动化测试实战》(19)——webdriver错误截图
webdriver 提供错误截图函数 get_screenshot_as_file(),可以帮助我们跟踪 bug,在脚本无法继续执行时候, get_screenshot_as_file()函数将截取当 ...