
二十六 Python分布式爬虫打造搜索引擎Scrapy精讲—通过downloadmiddleware中间件全局随机更换user-agent浏览器用户代理
downloadmiddleware介绍
中间件是一个框架,可以连接到请求/响应处理中。这是一种很轻的、低层次的系统,可以改变Scrapy的请求和回应。也就是在Requests请求和Response响应之间的中间件,可以全局的修改Requests请求和Response响应
UserAgentMiddleware()方法,默认中间件
源码里downloadmiddleware里的useragent.py下的UserAgentMiddleware()方法,默认中间件
我们可以从源码看到当Requests请求时默认的User-Agent是Scrapy,这个很容易被网站识别而拦截爬虫

我们可以修改默认中间件UserAgentMiddleware()来随机更换Requests请求头信息的User-Agent浏览器用户代理
第一步、在settings.py配置文件,开启中间件注册DOWNLOADER_MIDDLEWARES={ }
将默认的将默认的UserAgentMiddleware设置为None,或者设置成最大就最后执行,这样我们自定义的中间件修改默认的user_agent就会先执行
settings.py配置文件

# Enable or disable downloader middlewares

# See http://scrapy.readthedocs.org/en/latest/topics/downloader-middleware.html

DOWNLOADER_MIDDLEWARES = {              #开启注册中间件

   'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None, #将默认的UserAgentMiddleware设置为None

}
第二步、安装浏览器用户代理模块fake-useragent 0.1.7
fake-useragent 是一个专门用于爬虫伪装浏览器User-Agent请求头的模块。此模块在线维护了各个浏览器的各种版本库,提供我们使用
在线各种浏览器信息:http://fake-useragent.herokuapp.com/browsers/0.1.7 0.1.7版本,fake-useragent会随机到这里调用浏览器代理
首先安装这个模块
pip install fake-useragent
使用说明:
#!/usr/bin/env python

# -*- coding:utf8 -*-

from fake_useragent import UserAgent  #导入浏览器代理模块

ua = UserAgent()                      #实例化浏览器代理类

ua.ie                                 #随机获取IE类型的代理

# Mozilla/5.0 (Windows; U; MSIE 9.0; Windows NT 9.0; en-US);

ua.msie                               #随机获取msie类型的代理,下面的相同

# Mozilla/5.0 (compatible; MSIE 10.0; Macintosh; Intel Mac OS X 10_7_3; Trident/6.0)'

ua['Internet Explorer']

# Mozilla/5.0 (compatible; MSIE 8.0; Windows NT 6.1; Trident/4.0; GTB7.4; InfoPath.2; SV1; .NET CLR 3.3.69573; WOW64; en-US)

ua.opera

# Opera/9.80 (X11; Linux i686; U; ru) Presto/2.8.131 Version/11.11

ua.chrome

# Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.2 (KHTML, like Gecko) Chrome/22.0.1216.0 Safari/537.2'

ua.google

# Mozilla/5.0 (Macintosh; Intel Mac OS X 10_7_4) AppleWebKit/537.13 (KHTML, like Gecko) Chrome/24.0.1290.1 Safari/537.13

ua['google chrome']

# Mozilla/5.0 (X11; CrOS i686 2268.111.0) AppleWebKit/536.11 (KHTML, like Gecko) Chrome/20.0.1132.57 Safari/536.11

ua.firefox

# Mozilla/5.0 (Windows NT 6.2; Win64; x64; rv:16.0.1) Gecko/20121011 Firefox/16.0.1

ua.ff

# Mozilla/5.0 (X11; Ubuntu; Linux i686; rv:15.0) Gecko/20100101 Firefox/15.0.1

ua.safari

# Mozilla/5.0 (iPad; CPU OS 6_0 like Mac OS X) AppleWebKit/536.26 (KHTML, like Gecko) Version/6.0 Mobile/10A5355d Safari/8536.25

# and the best one, random via real world browser usage statistic

ua.random                               #随机获取各种浏览器类型的代理,
更多使用 https://pypi.python.org/pypi/fake-useragent/0.1.7
第三步、自定义中间件来全局随机更换Requests请求头信息的User-Agent浏览器用户代理
在middlewares.py文件里,自定义中间件
# -*- coding: utf-8 -*-

# Define here the models for your spider middleware

#

# See documentation in:

# http://doc.scrapy.org/en/latest/topics/spider-middleware.html

from scrapy import signals

from fake_useragent import UserAgent    #导入浏览器用户代理模块

class RequestsUserAgentmiddware(object):                                    #自定义浏览器代理中间件

    #随机更换Requests请求头信息的User-Agent浏览器用户代理

    def __init__(self,crawler):

        super(RequestsUserAgentmiddware, self).__init__()                   #获取上一级父类基类的,__init__方法里的对象封装值

        self.ua = UserAgent()                                               #实例化浏览器用户代理模块类

        self.ua_type = crawler.settings.get('RANDOM_UA_TYPE','random')      #获取settings.py配置文件里的RANDOM_UA_TYPE配置的浏览器类型,如果没有,默认random,随机获取各种浏览器类型

    @classmethod                                                            #函数上面用上装饰符@classmethod,函数里有一个必写形式参数cls用来接收当前类名称

    def from_crawler(cls, crawler):                                         #重载from_crawler方法

        return cls(crawler)                                                 #将crawler爬虫返回给类

    def process_request(self, request, spider):                             #重载process_request方法

        def get_ua():                                                       #自定义函数,返回浏览器代理对象里指定类型的浏览器信息

            return getattr(self.ua, self.ua_type)

        request.headers.setdefault('User-Agent', get_ua())                  #将浏览器代理信息添加到Requests请求
第四步、将我们自定义的中间件注册到settings.py配置文件,的DOWNLOADER_MIDDLEWARES里
注意一点要把默认的UserAgentMiddleware中间件设置为None,使其我们自定义的中间件生效
# Enable or disable downloader middlewares

# See http://scrapy.readthedocs.org/en/latest/topics/downloader-middleware.html

DOWNLOADER_MIDDLEWARES = {              #开启注册中间件

   'adc.middlewares.RequestsUserAgentmiddware': 543,

   'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None, #将默认的UserAgentMiddleware设置为None

}
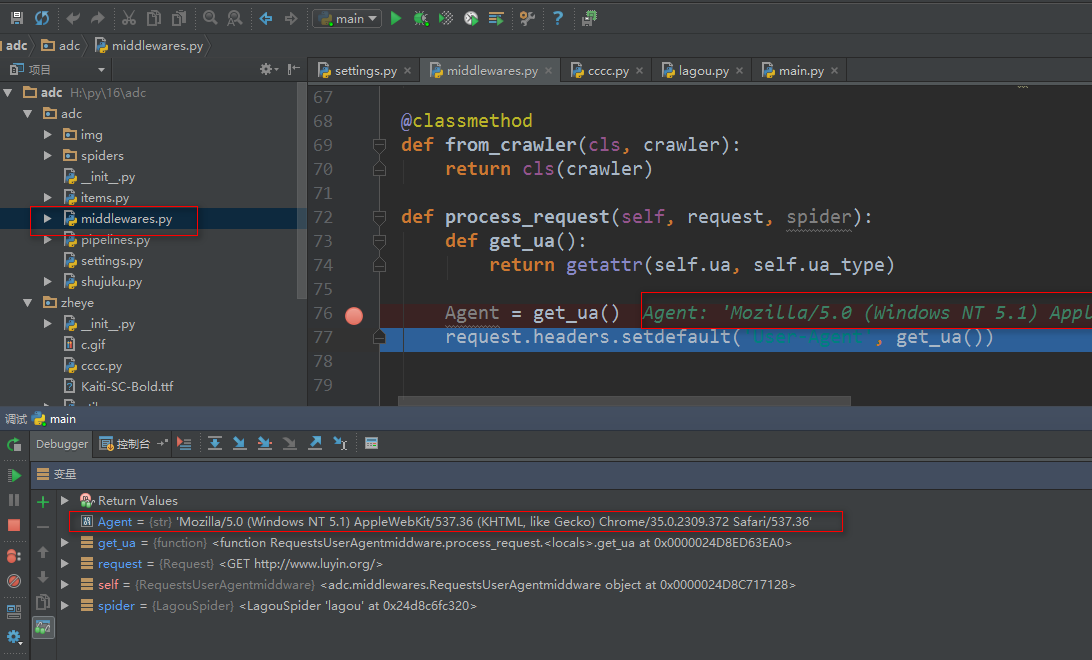
我们可以打断点调试一下,看看是否生效
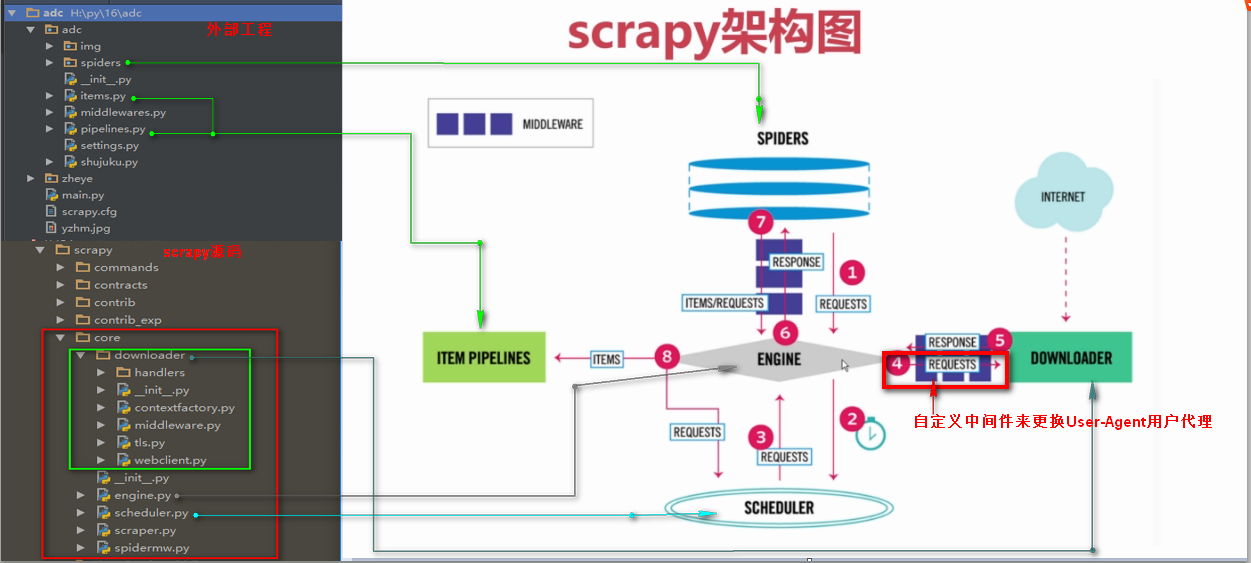
原理说明图
二十六 Python分布式爬虫打造搜索引擎Scrapy精讲—通过downloadmiddleware中间件全局随机更换user-agent浏览器用户代理的更多相关文章
- 第三百四十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过downloadmiddleware中间件全局随机更换user-agent浏览器用户代理
第三百四十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过downloadmiddleware随机更换user-agent浏览器用户代理 downloadmiddleware介绍中间件是 ...
- 第三百四十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过自定义中间件全局随机更换代理IP
第三百四十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—通过自定义中间件全局随机更换代理IP 设置代理ip只需要,自定义一个中间件,重写process_request方法, request ...
- 二十七 Python分布式爬虫打造搜索引擎Scrapy精讲—通过自定义中间件全局随机更换代理IP
设置代理ip只需要,自定义一个中间件,重写process_request方法, request.meta['proxy'] = "http://185.82.203.146:1080&quo ...
- 三十六 Python分布式爬虫打造搜索引擎Scrapy精讲—利用开源的scrapy-redis编写分布式爬虫代码
scrapy-redis是一个可以scrapy结合redis搭建分布式爬虫的开源模块 scrapy-redis的依赖 Python 2.7, 3.4 or 3.5,Python支持版本 Redis & ...
- 二十五 Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍
Requests请求 Requests请求就是我们在爬虫文件写的Requests()方法,也就是提交一个请求地址,Requests请求是我们自定义的 Requests()方法提交一个请求 参数: ur ...
- 四十六 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)scrapy写入数据到elasticsearch中
前面我们讲到的elasticsearch(搜索引擎)操作,如:增.删.改.查等操作都是用的elasticsearch的语言命令,就像sql命令一样,当然elasticsearch官方也提供了一个pyt ...
- 二十九 Python分布式爬虫打造搜索引擎Scrapy精讲—selenium模块是一个python操作浏览器软件的一个模块,可以实现js动态网页请求
selenium模块 selenium模块为第三方模块需要安装,selenium模块是一个操作各种浏览器对应软件的api接口模块 selenium模块是一个操作各种浏览器对应软件的api接口模块,所以 ...
- 二十八 Python分布式爬虫打造搜索引擎Scrapy精讲—cookie禁用、自动限速、自定义spider的settings,对抗反爬机制
cookie禁用 就是在Scrapy的配置文件settings.py里禁用掉cookie禁用,可以防止被通过cookie禁用识别到是爬虫,注意,只适用于不需要登录的网页,cookie禁用后是无法登录的 ...
- 二十四 Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图
1.基本概念 2.反爬虫的目的 3.爬虫和反爬的对抗过程以及策略 scrapy架构源码分析图
随机推荐
- 【转帖】C++经典书籍汇总
TCPL和D&E 1:Bjarne Stroustrup, The C++ Programming Language (Special 3rd Edition) <C++ 程序设计语言( ...
- jenkins SSH登录 Git配置(通过eclipse生成SSH 密钥)
1.通过eclipse生成SSH 密钥 菜单栏的windows-->preferences-->General-->Network Connections-->SSH2--&g ...
- [C语言]小记q = (++j) + (++j) + (++j)的值
根据不同的编译器,生产的代码不一样,导致的结果也会不一样. 代码如下: #include <stdio.h> void main() { ; int q; q =(++j)+(++j)+( ...
- npm使用淘宝镜像
淘宝 npm 地址: http://npm.taobao.org/ 如何使用 有很多方法来配置npm的registry地址,下面根据不同情境列出几种比较常用的方法.以淘宝npm镜像举例: 1.临时使用 ...
- BFC 详说 Block Formatting Contexts (块级格式化上下文)
定位方案是控制元素的布局,在 CSS 2.1 中,有三种定位方案——普通流 (Normal Flow) .浮动 (Floats) 和绝对定位 (Absolute Positioning) ,下面分别对 ...
- javascript 设置元素滚动大小
3. 滚动大小 最后要介绍的是滚动大小(scroll dimension),指的是包含滚动内容的元素的大小. 有些元素(例如 元素),即使没有执行任何代码也能自动地添加滚动条:但另外一些元素,则需要通 ...
- Linux CentOS6环境下MySQL5.1升级至MySQL5.5版本过程
转载地址:http://www.laozuo.org/6145.html 老左今天有在帮朋友的博客搬迁到另外一台VPS主机环境,其环境采用的是LLSMP架构的,原先的服务器采用的是LNMP网站环境,其 ...
- xxxx interview
1. 什么数据库,做了什么优化? 回答mysql innodb与myisam区别,根据业务选择引擎.事务,行级锁,全文检索,二级索引. 存储:myisam数据和索引分开存储.innodb数据和索引存储 ...
- 20145312 实验二《 Java面向对象程序设计》
20145312 实验二< Java面向对象程序设计> 实验内容 初步掌握单元测试和TDD 理解并掌握面向对象三要素:封装.继承.多态 初步掌握UML建模 熟悉S.O.L.I.D原则 了解 ...
- nmap与Nessus扫描特定靶机分析
打开装载Metasploitable2虚拟机的靶机,并获取靶机ip: 使用nmap+ip初步扫描靶机 PORT为端口,STATE为端口开放状态,SERVICE为端口的提供的服务.靶机的MAC地址为: ...