
二十五 Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍
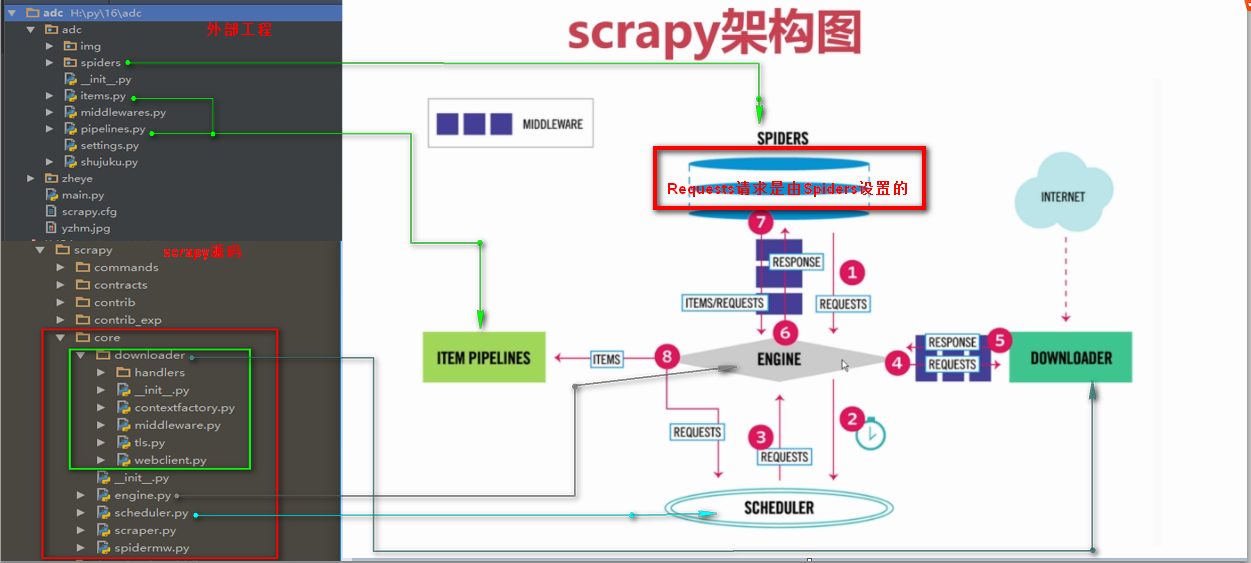
Requests请求
Requests请求就是我们在爬虫文件写的Requests()方法,也就是提交一个请求地址,Requests请求是我们自定义的
Requests()方法提交一个请求
参数:
url= 字符串类型url地址
callback= 回调函数名称
method= 字符串类型请求方式,如果GET,POST
headers= 字典类型的,浏览器用户代理
cookies= 设置cookies
meta= 字典类型键值对,向回调函数直接传一个指定值
encoding= 设置网页编码
priority= 默认为0,如果设置的越高,越优先调度
dont_filter= 默认为False,如果设置为真,会过滤掉当前url

# -*- coding: utf-8 -*-

import scrapy

from scrapy.http import Request,FormRequest

import re

class PachSpider(scrapy.Spider):                            #定义爬虫类,必须继承scrapy.Spider

    name = 'pach'                                           #设置爬虫名称

    allowed_domains = ['www.luyin.org/']                    #爬取域名

    # start_urls = ['']                                     #爬取网址,只适于不需要登录的请求,因为没法设置cookie等信息

    header = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64; rv:54.0) Gecko/20100101 Firefox/54.0'}  #设置浏览器用户代理

    def start_requests(self):    #起始url函数,会替换start_urls

        """第一次请求一下登录页面,设置开启cookie使其得到cookie,设置回调函数"""

        return [Request(

            url='http://www.luyin.org/',

            headers=self.header,

            meta={'cookiejar':1},       #开启Cookies记录,将Cookies传给回调函数

            callback=self.parse

        )]

    def parse(self, response):

        title = response.xpath('/html/head/title/text()').extract()

        print(title)
Response响应
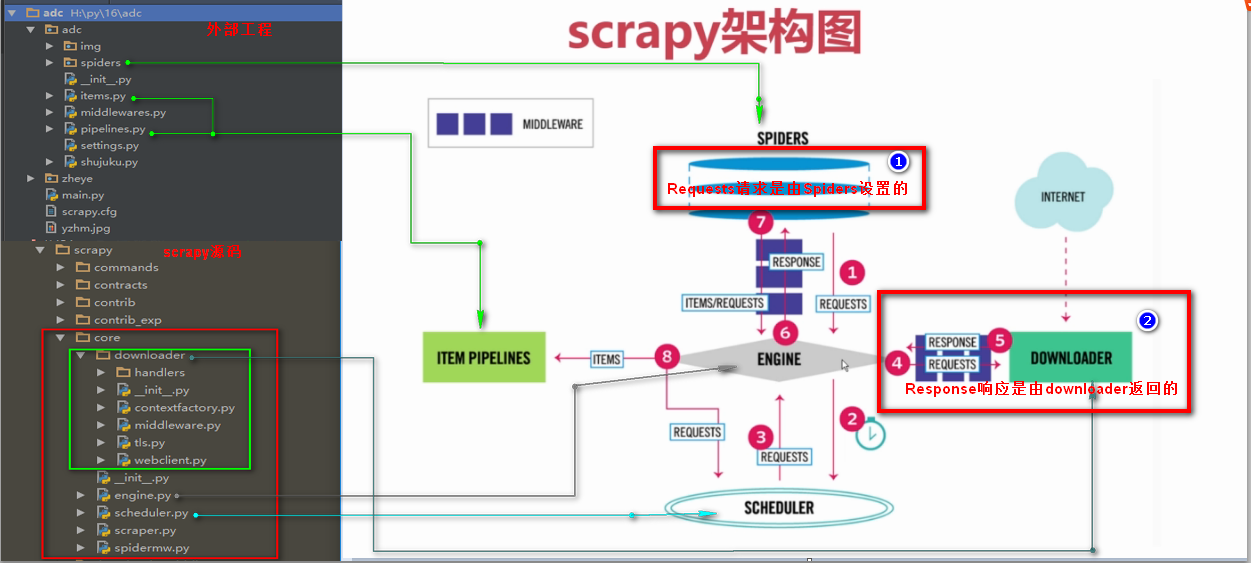
Response响应是由downloader返回的响应

Response响应参数
headers 返回响应头
status 返回状态吗
body 返回页面内容,字节类型
url 返回抓取url
# -*- coding: utf-8 -*-

import scrapy

from scrapy.http import Request,FormRequest

import re

class PachSpider(scrapy.Spider):                            #定义爬虫类,必须继承scrapy.Spider

    name = 'pach'                                           #设置爬虫名称

    allowed_domains = ['www.luyin.org/']                    #爬取域名

    # start_urls = ['']                                     #爬取网址,只适于不需要登录的请求,因为没法设置cookie等信息

    header = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64; rv:54.0) Gecko/20100101 Firefox/54.0'}  #设置浏览器用户代理

    def start_requests(self):    #起始url函数,会替换start_urls

        """第一次请求一下登录页面,设置开启cookie使其得到cookie,设置回调函数"""

        return [Request(

            url='http://www.luyin.org/',

            headers=self.header,

            meta={'cookiejar':1},       #开启Cookies记录,将Cookies传给回调函数

            callback=self.parse

        )]

    def parse(self, response):

        title = response.xpath('/html/head/title/text()').extract()

        print(title)

        print(response.headers)

        print(response.status)

        # print(response.body)

        print(response.url)
二十五 Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍的更多相关文章
- 第三百四十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍
第三百四十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—Requests请求和Response响应介绍 Requests请求 Requests请求就是我们在爬虫文件写的Requests() ...
- 二十六 Python分布式爬虫打造搜索引擎Scrapy精讲—通过downloadmiddleware中间件全局随机更换user-agent浏览器用户代理
downloadmiddleware介绍中间件是一个框架,可以连接到请求/响应处理中.这是一种很轻的.低层次的系统,可以改变Scrapy的请求和回应.也就是在Requests请求和Response响应 ...
- 三十五 Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy分布式爬虫要点
1.分布式爬虫原理 2.分布式爬虫优点 3.分布式爬虫需要解决的问题
- 二十九 Python分布式爬虫打造搜索引擎Scrapy精讲—selenium模块是一个python操作浏览器软件的一个模块,可以实现js动态网页请求
selenium模块 selenium模块为第三方模块需要安装,selenium模块是一个操作各种浏览器对应软件的api接口模块 selenium模块是一个操作各种浏览器对应软件的api接口模块,所以 ...
- 二十八 Python分布式爬虫打造搜索引擎Scrapy精讲—cookie禁用、自动限速、自定义spider的settings,对抗反爬机制
cookie禁用 就是在Scrapy的配置文件settings.py里禁用掉cookie禁用,可以防止被通过cookie禁用识别到是爬虫,注意,只适用于不需要登录的网页,cookie禁用后是无法登录的 ...
- 二十四 Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图
1.基本概念 2.反爬虫的目的 3.爬虫和反爬的对抗过程以及策略 scrapy架构源码分析图
- 四十五 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的bool组合查询
bool查询说明 filter:[],字段的过滤,不参与打分must:[],如果有多个查询,都必须满足[并且]should:[],如果有多个查询,满足一个或者多个都匹配[或者]must_not:[], ...
- 三十六 Python分布式爬虫打造搜索引擎Scrapy精讲—利用开源的scrapy-redis编写分布式爬虫代码
scrapy-redis是一个可以scrapy结合redis搭建分布式爬虫的开源模块 scrapy-redis的依赖 Python 2.7, 3.4 or 3.5,Python支持版本 Redis & ...
- 四十四 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
1.elasticsearch(搜索引擎)的查询 elasticsearch是功能非常强大的搜索引擎,使用它的目的就是为了快速的查询到需要的数据 查询分类: 基本查询:使用elasticsearch内 ...
随机推荐
- testng日志 ITestListener
上一节我们写一个日志类 extends TestListenerAdapter ----------TestListenerAdapter 是 ITestListener 实现的一个类 这一节,我 ...
- co.js异步回调原理理解
co.js是基于es6的generator实现的,相当于generator函数的一个自动执行器 generator的简单介绍 function* fn(){ before() yield firstY ...
- 最新zencart支付宝插件(支持1.5)
最新zencart支付宝插件(支持1.5) 最新zencart支付宝插件(支持1.5) 支付宝接口的兼容性真不错,时至今日还能用,想利用zencart来做国内时长还真是方便多了,朋友们可以试试. ...
- OS X 10.9 Mavericks下如何安装Command Line Tools(命令行工具)
OS X 10.9 Mavericks下如何安装Command Line Tools(命令行工具) 今天OS X 10.9 Mavericks正式发布,免费更新,立即去更新看看效果. 不过升级后安装命 ...
- windows 常用cmd命令
为了减少使用鼠标的频次,熟记一些常用应用的快捷键与系统本身常用的命令是必须的,以下记录一些常用的windows系统命令. 查看网络端口占用情况 :netstat -ano | findstr 8080 ...
- maven install jdk版本自动降为1.7
开发过程中遇到了一个奇怪的现象. IDEA中所有的设置都改成了1.8,但是在执行maven install时却自动降为1.7,报错提示: [ERROR] Failed to execute goal ...
- tomcat 连接器优化
在$CATALINA_HOME/conf/server.xml配置文件中的Connetctor节点,和连接数相关的参数配置和优化. maxThreads Tomcat使用线程来处理接收的每个请求.这个 ...
- 谷歌技术"三宝"之MapReduce(转)
原文地址:http://blog.csdn.net/opennaive/article/details/7514146 江湖传说永流传:谷歌技术有"三宝",GFS.MapReduc ...
- 【Thinking in Java, 4e】初始化与清理
[用构造器确保初始化] [方法重载] 涉及基本类型的重载 1.如果传入的数据类型小于方法中声明的形式参数类型:实际数据类型会被提升. 2.如果传入的数据类型大于方法中声明的形式参数类型:编译器报错,应 ...
- 【Thinking in Java, 4e】控制流程执行
p46~p75: [迭代] 1.Java不允许将数字作为布尔值用. 1.有点意思的小程序WhileTest. public class WhileTest { static boolean condi ...