
使用flume将数据sink到kafka
flume采集过程:
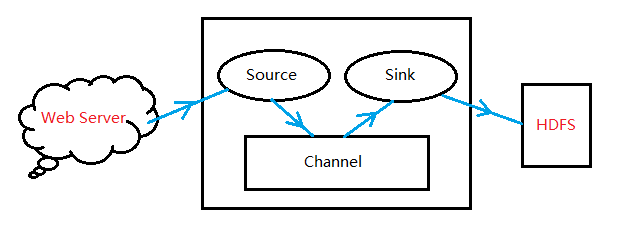
#说明:案例是flume监听目录/home/hadoop/flume_kafka采集到kafka;
启动集群
启动kafka,
启动agent,
flume-ng agent -c . -f /home/hadoop/flume-1.7.0/conf/myconf/flume-kafka.conf -n a1 -Dflume.root.logger=INFO,console
开启消费者
kafka-console-consumer.sh --zookeeper hdp-qm-01:2181 --from-beginning --topic mytopic
生产数据到kafka
数据目录:
vi /home/hadoop/flume_hbase/word.txt
12345623434
配置文件
vi flume-kafka.conf
#Name the components on this agent
a1.sources = r1
a1.sinks = k1
a1.channels = c1
#Describe/configure the source
a1.sources.r1.type = spooldir
a1.sources.r1.spoolDir=/home/hadoop/flume_kafka
# Describe the sink
a1.sinks.k1.type = org.apache.flume.sink.kafka.KafkaSink
a1.sinks.k1.kafka.topic = mytopic
a1.sinks.k1.kafka.bootstrap.servers = hdp-qm-01:9092
a1.sinks.k1.kafka.flumeBatchSize = 20
a1.sinks.k1.kafka.producer.acks = 1
a1.sinks.k1.kafka.producer.linger.ms = 1
a1.sinks.ki.kafka.producer.compression.type = snappy
# Use a channel which buffers events in memory
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
# Bind the source and sink to the channel
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
使用flume将数据sink到kafka的更多相关文章
- 如何用Flink把数据sink到kafka多个(成百上千)topic中
需求与场景 上游某业务数据量特别大,进入到kafka一个topic中(当然了这个topic的partition数必然多,有人肯定疑问为什么非要把如此庞大的数据写入到1个topic里,历史留下的问题,现 ...
- 如何用Flink把数据sink到kafka多个不同(成百上千)topic中
需求与场景 上游某业务数据量特别大,进入到kafka一个topic中(当然了这个topic的partition数必然多,有人肯定疑问为什么非要把如此庞大的数据写入到1个topic里,历史留下的问题,现 ...
- flume将数据发送到kafka、hdfs、hive、http、netcat等模式的使用总结
1.source为http模式,sink为logger模式,将数据在控制台打印出来. conf配置文件如下: # Name the components on this agent a1.source ...
- flume接收http请求,并将数据写到kafka
flume接收http请求,并将数据写到kafka,spark消费kafka的数据.是数据采集的经典框架. 直接上flume的配置: source : http channel : file sink ...
- 大数据技术之Kafka
Kafka概述 1.1 消息队列 (1)点对点模式(一对一,消费者主动拉取数据,消息收到后消息清除) 点对点模型通常是一个基于拉取或者轮询的消息传送模型,这种模型从队列中请求信息,而不是将消息 ...
- flume将数据写入各个组件
一.flume集成hdfs,将数据写入到hdfs a1.sources = r1 a1.sinks = k1 a1.channels = c ...
- 大数据平台搭建-kafka集群的搭建
本系列文章主要阐述大数据计算平台相关框架的搭建,包括如下内容: 基础环境安装 zookeeper集群的搭建 kafka集群的搭建 hadoop/hbase集群的搭建 spark集群的搭建 flink集 ...
- [Spring cloud 一步步实现广告系统] 16. 增量索引实现以及投送数据到MQ(kafka)
实现增量数据索引 上一节中,我们为实现增量索引的加载做了充足的准备,使用到mysql-binlog-connector-java 开源组件来实现MySQL 的binlog监听,关于binlog的相关知 ...
- HBase数据迁移到Kafka实战
1.概述 在实际的应用场景中,数据存储在HBase集群中,但是由于一些特殊的原因,需要将数据从HBase迁移到Kafka.正常情况下,一般都是源数据到Kafka,再有消费者处理数据,将数据写入HBas ...
- 将CSV的数据发送到kafka(java版)
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
随机推荐
- goland dlv在远程linux里运行代码开发,并debug调适
一.配置好ssh自动同步代码 参考下面连接: https://www.cnblogs.com/haima/p/13257524.html 二.配置devbug监听运行 GO Remote 填写配置 l ...
- Spring Cloud 部署时如何使用 Kubernetes 作为注册中心和配置中心
一.Spring Cloud 支持的常见注册中心和配置中心. Spring Cloud 自带的注册中心Eureka以及config配置中心 Nacos,支持注册中心和配置中心等,可以参考:https: ...
- installshield 安装jdk并配置环境变量
今天来通过installshield安装jdk以及配置环境变量,本质上是调用第三方安装程序. 首先将jdk的安装文件添加到我们的安装程序中 然后编写我们的脚本 选择BEHAVIOR AND LOGIC ...
- installshield 64位系统操作注册表遇到的问题
最近在研究IS脚本设置jdk环境变量问题,在使用RegDBKeyExist判断注册表中项的时候一直找不到,翻找文档后发现64位的操作系统需要设置 REGDB_OPTIONS. "SOFTWA ...
- WebGL:使用着色器进行几何造型
前言 本文将介绍如何使用着色器来进行几何造型,说到几何图形大家一定都不陌生,比如说三角形.圆形,接触过WebGL基础使用的小伙伴一定都知道怎么去在画布上绘制一个三角形,只要传入三个顶点坐标,并选择绘图 ...
- C语言:约瑟夫问题——使用循环链表解决
传说有30个乘客同乘一条船,因为严重超载,加上风浪水作,危险万分.船长告诉乘客,只有将全船一半的乘客投入海 中,其余人才能幸免于难.他们约定了一个规则:30个人围成一圈,由第一个人数起,依次报数,数到 ...
- apisix~升级原始插件的方法
扩展apisix原始插件 当apisix提供的插件不能满足我们要求时,我们可能需要将它的plugin进行个性化扩展,例如一个jwt认证插件jwt-auth,它本身具有验证jwt有效性功能,支持rs25 ...
- pageoffice6 实现提取数据区域为子文件(Word拆分)
在实际的开发过程中,有时会遇到希望提取Word文档中部分内容保存为子文件的需求,PageOffice支持提取Word文档数据区域中的内容为一个Word文件流,在服务器端创建PageOffice的Wor ...
- PaliGemma 正式发布 — Google 最新发布的前沿开放视觉语言模型
PaliGemma 是 Google 推出的新一代视觉语言模型家族,能够接收图像与文本输入并生成文本输出. Google 团队已推出三种类型的模型:预训练(PT)模型.混合模型和微调(FT)模型,这些 ...
- C# WPF 自定义Main方法总结
在使用自定义的Main函数启动应用时,应该需要做这几步: 1.去掉App.xaml的Application的starup属性. 2.右键App.xaml,属性 把生成操作改为Page. 3.如果有引入 ...