
用python抓取求职网站信息
本次抓取的是智联招聘网站搜索“数据分析师”之后的信息。
python版本: python3.5。
我用的主要package是 Beautifulsoup + Requests+csv
另外,我将招聘内容的简单描述也抓取下来了。
文件输出到csv文件后,发现用excel打开时有些乱码,但用文件软件打开(如notepad++)是没有问题的。
为了能用Excel打开时正确显示,我用pandas转换了以下,并添加上列名。转化完后,就可以正确显示了。关于用pandas转化,可以参考我的博客:
由于招聘内容的描述较多,最后将csv文件另存为excel文件,并调整下格式,以便于查看。
最后效果如下: 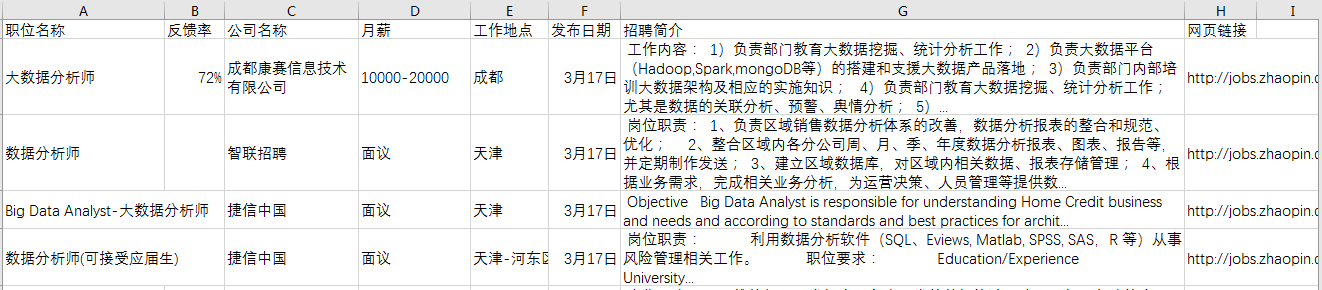
实现代码如下:信息爬取的代码如下:
 # Code based on Python 3.x

 # _*_ coding: utf-8 _*_

 # __Author: "LEMON"

 from bs4 import BeautifulSoup

 import requests

 import csv

 def download(url):

     headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64; rv:51.0) Gecko/20100101 Firefox/51.0'}

     req = requests.get(url, headers=headers)

     return req.text

 def get_content(html):

     soup = BeautifulSoup(html, 'lxml')

     body = soup.body

     data_main = body.find('div', {'class': 'newlist_list_content'})

     tables = data_main.find_all('table')

     zw_list = []

     for i,table in enumerate(tables):

         if i == 0:

             continue

         temp = []

         tds = table.find('tr').find_all('td')

         zwmc = tds[0].find('a').get_text()

         zw_link = tds[0].find('a').get('href')

         fkl = tds[1].find('span').get_text()

         gsmc = tds[2].find('a').get_text()

         zwyx = tds[3].get_text()

         gzdd = tds[4].get_text()

         gbsj = tds[5].find('span').get_text()

         tr_brief = table.find('tr', {'class': 'newlist_tr_detail'})

         brief = tr_brief.find('li', {'class': 'newlist_deatil_last'}).get_text()

         temp.append(zwmc)

         temp.append(fkl)

         temp.append(gsmc)

         temp.append(zwyx)

         temp.append(gzdd)

         temp.append(gbsj)

         temp.append(brief)

         temp.append(zw_link)

         zw_list.append(temp)

     return zw_list

 def write_data(data, name):

     filename = name

     with open(filename, 'a', newline='', encoding='utf-8') as f:

         f_csv = csv.writer(f)

         f_csv.writerows(data)

 if __name__ == '__main__':

     basic_url = 'http://sou.zhaopin.com/jobs/searchresult.ashx?jl=%E5%85%A8%E5%9B%BD&kw=%E6%95%B0%E6%8D%AE%E5%88%86%E6%9E%90%E5%B8%88&sm=0&p='

     number_list = list(range(90)) # total number of page is 90

     for number in number_list:

         num = number + 1

         url = basic_url + str(num)

         filename = 'zhilian_DA.csv'

         html = download(url)

         # print(html)

         data = get_content(html)

         # print(data)

         print('start saving page:', num)

         write_data(data, filename)
用pandas转化的代码如下:
 # Code based on Python 3.x

 # _*_ coding: utf-8 _*_

 # __Author: "LEMON"

 import pandas as pd

 df = pd.read_csv('zhilian_DA.csv', header=None)

 df.columns = ['职位名称', '反馈率', '公司名称', '月薪', '工作地点',

            '发布日期', '招聘简介', '网页链接']

 # 将调整后的dataframe文件输出到新的csv文件

 df.to_csv('zhilian_DA_update.csv', index=False)
用python抓取求职网站信息的更多相关文章
- 使用python抓取美团商家信息
抓取美团商家信息 import requests from bs4 import BeautifulSoup import json url = 'http://bj.meituan.com/' ur ...
- Python抓取成都房价信息
Python里scrapy爬虫 scrapy爬虫,正好最近成都房价涨的厉害,于是想着去网上抓抓成都最近的房价情况,顺便了解一下,毕竟咱是成都人,得看看这成都的房子我以后买的起不~ 话不多说,进入正题: ...
- 无比强大!Python抓取cssmoban网站的模版并下载
Python实现抓取http://www.cssmoban.com/cssthemes网站的模版并下载 实现代码 # -*- coding: utf-8 -*- import urlparse imp ...
- python爬取电影网站信息
一.爬取前提1)本地安装了mysql数据库 5.6版本2)安装了Python 2.7 二.爬取内容 电影名称.电影简介.电影图片.电影下载链接 三.爬取逻辑1)进入电影网列表页, 针对列表的html内 ...
- python抓取贝壳房源信息
分析了贝壳的房源信息数据,发现地址链接的参数传递是有规律的 https://tj.ke.com/chengjiao/a3l4/ a3 实际表示的 l4 表示的是 然后 将复合条件拼成一个字符串,带过去 ...
- 抓取某网站信息时遇到的问题及解决 The character set provided in ContentType is invalid. Cannot read content as string using an invalid character set
var response = httpClient.SendAsync(requestMessage).Result; content = response.Content.ReadAsStringA ...
- Python爬虫实战---抓取图书馆借阅信息
Python爬虫实战---抓取图书馆借阅信息 原创作品,引用请表明出处:Python爬虫实战---抓取图书馆借阅信息 前段时间在图书馆借了很多书,借得多了就容易忘记每本书的应还日期,老是担心自己会违约 ...
- Python 抓取网页并提取信息(程序详解)
最近因项目需要用到python处理网页,因此学习相关知识.下面程序使用python抓取网页并提取信息,具体内容如下: #---------------------------------------- ...
- 用python抓取智联招聘信息并存入excel
用python抓取智联招聘信息并存入excel tags:python 智联招聘导出excel 引言:前一阵子是人们俗称的金三银四,跳槽的小朋友很多,我觉得每个人都应该给自己做一下规划,根据自己的进步 ...
随机推荐
- 深圳尚学堂:Java中Class对象
Java中生成Class对象和生成instance都有多种方式.所以只有弄清其中的原理,才可以深入理解.首先要生成Class对象,然后再生成Instance.那Class对象的生成方式有哪些呢,以及其 ...
- 语句 if else
语句 语句是指程序命令,都是按照顺序执行的.语句在程序中的执行顺序称为“控制流”或“执行流”. 根据程序对运行时所收到的输入的响应,在程序每次运行时控制流可能有所不同. 语句间的标点符号必须是英文标点 ...
- 通过判断cookie过期方式向Memcached中添加,取出数据(Java)
应用场景:在数据驱动的web开发中,经常要重复从数据库中取出相同的数据,这种重复极大的增加了数据库负载.缓存是解决这个问题的好办法.但是ASP.NET中的虽然已经可以实现对页面局部进行缓存,但还是不够 ...
- jQuery + CSS3实现环形进度条
实现原理 原理非常的简单,在这个方案中,最主要使用了CSS3的transform中的rotate和CSS3的clip两个属性.用他们来实现半圆和旋转效果. 半环的实现 先来看其结构. HTML < ...
- Disruptor深入解读
将系统性能优化到极致,永远是程序爱好者所努力的一个方向.在java并发领域,也有很多的实践与创新,小到乐观锁.CAS,大到netty线程模型.纤程Quasar.kilim等.Disruptor是一个轻 ...
- java_监控工具jvisualvm
转:使用 VisualVM 进行性能分析及调优 启动:jvisualvm 首先到JDK安装目录/bin目录下,双击jvisualvm.exe文件启动 需要注意的是:当OS所在分区是FAT格式时,Vis ...
- Eclipse运行时无法加载主类的解决方法
测试代码: package javastudy; class Person { public static void main(String[] args) { PersonCeshi pp=new ...
- PHP文本处理之中文汉字字符串转换为数组
在PHP中我们可以通过str_split 将字符串转换为数组,但是却对中文无效,下面记录一下个人将中文字符串转换为数组的方法. 用到的PHP函数 mb_strlen - 获取字符串的长度 mb_sub ...
- Vuex核心知识(2.0)
Vuex 是一个专门为 Vue.js 应该程序开发的状态管理模式,它类似于 Redux 应用于 React 项目中,他们都是一种 Flux 架构.相比 Redux,Vuex 更简洁,学习成本更低.希望 ...
- spring boot框架eclipse快速搭建
1.maven安装配置好,使用eclipse创建maven项目(选择maven-archetype-quickstart) 2.然后进入http://docs.spring.io/spring-boo ...