
Java实现中文词频统计
昨日有个中文词频统计的需求, 百度一番后, 发现一大堆标题党文章, 讲的与内容严重不符, 这里就简单记录下自己实现的流程吧!
与英文单词的词频统计不同, 中文的难点在于如何分词, 不过好在有许多优秀的现成库供调用,这里就使用了 ansj_seg 插件.
首先添加依赖:
下载jar
- 访问 http://maven.nlpcn.org/org/ansj/ 最好下载最新版 ansj_seg/
- 同时下载nlp-lang.jar 需要和ansj_seg 配套..配套关系可以看jar包中的maven依赖,一般最新的ansj配最新的nlp-lang不会有错。
- 导入到eclipse ,开始你的程序吧
maven
        <dependency>

            <groupId>org.ansj</groupId>

            <artifactId>ansj_seg</artifactId>

            <version>5.1.1</version>

        </dependency>

基本用法为:
 String str = "欢迎使用ansj_seg,(ansj中文分词)在这里如果你遇到什么问题都可以联系我.我一定尽我所能.帮助大家.ansj_seg更快,更准,更自由!" ;

 System.out.println(ToAnalysis.parse(str));

 欢迎/v,使用/v,ansj/en,_,seg/en,,,(,ansj/en,中文/nz,分词/n,),在/p,这里/r,如果/c,你/r,遇到/v,什么/r,问题/n,都/d,可以/v,联系/v,我/r,./m,我/r,一定/d,尽我所能/l,./m,帮助/v,大家/r,./m,ansj/en,_,seg/en,更快/d,,,更/d,准/a,,,更/d,自由/a,!
下面就贴上代码:
  public static void wordFrequency() throws IOException {

        Map<String, Integer> map = new HashMap<>();

        String article = getString();

        String result = ToAnalysis.parse(article).toStringWithOutNature();

        String[] words = result.split(",");

        for(String word: words){

            String str = word.trim();

            // 过滤空白字符

            if (str.equals(""))

                continue;

            // 过滤一些高频率的符号

            else if(str.matches("[)|(|.|,|。|+|-|“|”|:|?|\\s]"))

                continue;

            // 此处过滤长度为1的str

            else if (str.length() < 2)

                continue;

            if (!map.containsKey(word)){

                map.put(word, 1);

            } else {

                int n = map.get(word);

                map.put(word, ++n);

            }

        }

        Iterator<Map.Entry<String, Integer>> iterator = map.entrySet().iterator();

        while (iterator.hasNext()){

            Map.Entry<String, Integer> entry = iterator.next();

            System.out.println(entry.getKey() + ": " + entry.getValue());

        }


        List<Map.Entry<String, Integer>> list = new ArrayList<>();

        Map.Entry<String, Integer> entry;


        while ((entry = getMax(map)) != null){

            list.add(entry);

        }

        System.out.println(Arrays.toString(list.toArray()));

    }

    /**

     * 找出map中value最大的entry, 返回此entry, 并在map删除此entry

     * @param map

     * @return

     */

    public static Map.Entry<String, Integer> getMax(Map<String, Integer> map){

        if (map.size() == 0){

            return null;

        }

        Map.Entry<String, Integer> maxEntry = null;

        boolean flag = false;

        Iterator<Map.Entry<String, Integer>> iterator = map.entrySet().iterator();

        while (iterator.hasNext()){

            Map.Entry<String, Integer> entry = iterator.next();

            if (!flag){

                maxEntry = entry;

                flag = true;

            }

            if (entry.getValue() > maxEntry.getValue()){

                maxEntry = entry;

            }

        }

        map.remove(maxEntry.getKey());

        return maxEntry;

    }

    /**

     * 从文件中读取待分割的文章素材.
   * 文件内容来自简书热门文章: https://www.jianshu.com/p/5b37403f6ba6

     * @return

     * @throws IOException

     */

    public static String getString() throws IOException {

        FileInputStream inputStream = new FileInputStream(new File("/home/as_/IdeaProjects/SpringMaven/article-txt"));

        BufferedReader reader = new BufferedReader(new InputStreamReader(inputStream));

        StringBuilder strBuilder = new StringBuilder();

        String line;

        while((line = reader.readLine()) != null){

            strBuilder.append(line);

        }

        reader.close();

        inputStream.close();

        return strBuilder.toString();

    }
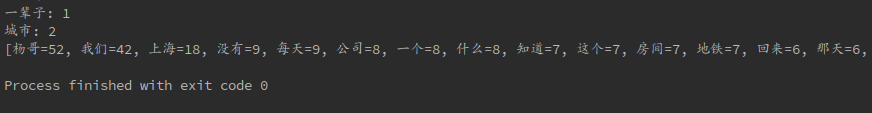
最后依旧附上图片:
Java实现中文词频统计的更多相关文章
- 如何用java完成一个中文词频统计程序
要想完成一个中文词频统计功能,首先必须使用一个中文分词器,这里使用的是中科院的.下载地址是http://ictclas.nlpir.org/downloads,由于本人电脑系统是win32位的,因此下 ...
- 初学Hadoop之中文词频统计
1.安装eclipse 准备 eclipse-dsl-luna-SR2-linux-gtk-x86_64.tar.gz 安装 1.解压文件. 2.创建图标. ln -s /opt/eclipse/ec ...
- Python中文词频统计
以下是关于小说的中文词频统计 这里有三个文件,分别为novel.txt.punctuation.txt.meaningless.txt. 这三个是小说文本.特殊符号和无意义词 Python代码统计词频 ...
- jieba (中文词频统计) 、collections (字频统计)、WordCloud (词云)
py库: jieba (中文词频统计) .collections (字频统计).WordCloud (词云) 先来个最简单的: # 查找列表中出现次数最多的值 ls = [1, 2, 3, 4, 5, ...
- py库: jieba (中文词频统计) 、collections (字频统计)、WordCloud (词云)
先来个最简单的: # 查找列表中出现次数最多的值 ls = [1, 2, 3, 4, 5, 6, 1, 2, 1, 2, 1, 1] ls = ["呵呵", "呵呵&qu ...
- Java实现的词频统计——Web迁移
本次将原本控制台工程迁移到了web工程上,依旧保留原本控制台的版本. 需求: 1.把程序迁移到web平台,通过用户上传TXT的方式接收文件: 2.在页面上给出链接 (如果有封皮.作者.字数.页数等信息 ...
- Java实现的词频统计——功能改进
本次改进是在原有功能需求及代码基础上额外做的修改,保证了原有的基础需求之外添加了新需求的功能. 功能: 1. 小文件输入——从控制台由用户输入到文件中,再对文件进行统计: 2.支持命令行输入英文作品的 ...
- Java实现的词频统计
要求: 1.读取文件: 2.记录出现的词汇及出现频率: 3.按照频率降序排列: 4.输出结果. 概要: 1.读取的文件路径是默认的,为了方便调试,将要统计的文章.段落复制到文本中即可:2.只支持英文: ...
- Java实现的词频统计——单元测试
前言:本次测试过程中发现了几个未知字符,这里将其转化为十六进制码对其加以区分. 1)保存统计结果的Result文件中显示如图: 2)将其复制到eclipse环境下的切分方法StringTokenize ...
随机推荐
- DjVu转PDG的方法与步骤
作者:马健邮箱:stronghorse_mj@hotmail.com发布:2008.08.03更新:2008.08.24 补充说明:此文成文较早,当时PDG浏览器只支持纯正PDG,不支持名为PDG,实 ...
- Unobrusive Ajax使用
mark一下:[ASP.NET MVC 小牛之路]14 - Unobtrusive Ajax篇文章,果断记下来,网址: http://www.cnblogs.com/willick/p/3418517 ...
- Linux curl 常用命令
命令:curl在Linux中curl是一个利用URL规则在命令行下工作的文件传输工具,可以说是一款很强大的http命令行工具.它支持文件的上传和下载,是综合传输工具,但按传统,习惯称url为下载工具. ...
- 一种Web服务的go语言实现
0.引言 go语言已成为当今web后台开发的首选语言,关键在于其简洁性和高效并发特性.go中提供了丰富通用的http开发接口,但一般需要对其进一步封装才能更好的用于实际项目中.因此,本文基于开源库(g ...
- socket网络服务实战
一.epoll模型的构建 由于网络服务高并发的需求,一般socket网络模型都采用epoll模型,有关epoll模型的原理在相关论坛中有许多讲述,在此不做重复讲解,主要讲一讲epoll模型的封装实现. ...
- 与HDFS交互-By shell命令
Shell命令的开头有三种: hadoop fs hadoop dfs hdfs dfs 关于具体命令之前写过 可查看:https://www.cnblogs.com/floakss/p/970344 ...
- flask 坑
no python application found, check your startup logs for errors 日志里面报类似于“Mon Mar 23 10:26:49 2015 – ...
- es6-01
ECMAScript是一种由Ecma国际(前身为欧洲计算机制造商协会,英文名称是European Computer ManufacturersAssociation)通过ECMA-262标准化的脚本程 ...
- 小聊outline和border
border与outline: border属性: border-width.border-style.border-color 其中border-style可以为none或hidden outlin ...
- php 中 ?? 和 empty 的 区别
left??right 操作符...当 left 为空时 返回 right ..注意 和 empty 相比 ,空字符,0,'0' 都会返回它本身,而不是 右边的..也就是 当且仅当 没有设置变量或者 ...