
初学Hadoop之中文词频统计
1、安装eclipse
准备
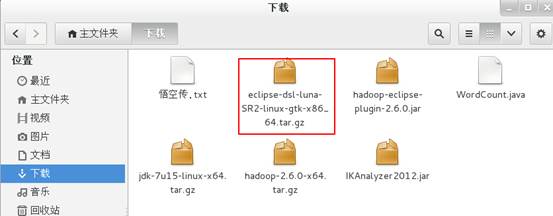
eclipse-dsl-luna-SR2-linux-gtk-x86_64.tar.gz
安装
1、解压文件。
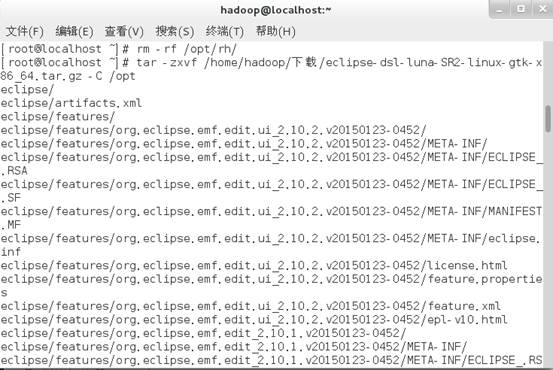
2、创建图标。
ln -s /opt/eclipse/eclipse /usr/bin/eclipse #使符号链接目录
vim /usr/share/applications/eclipse.desktop #创建一个 Gnome 启动
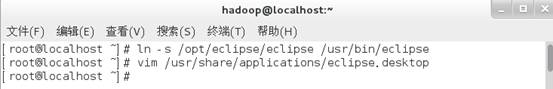
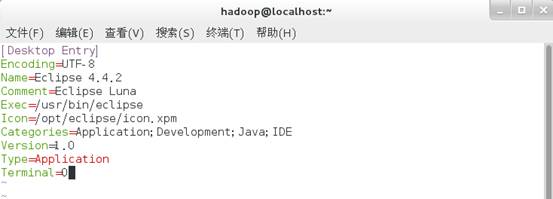
添加如下代码:
[Desktop Entry]

Encoding=UTF-8

Name=Eclipse 4.4.2

Comment=Eclipse Luna

Exec=/usr/bin/eclipse

Icon=/opt/eclipse/icon.xpm

Categories=Application;Development;Java;IDE

Version=1.0

Type=Application

Terminal=0
完成以后则会出现下图中的图标。

至此,eclipse安装完成。
2、安装hadoop插件
1、下载插件http://pan.baidu.com/s/1ydUEy 。
2、将插件放到/opt/eclipse/plugins文件夹下。
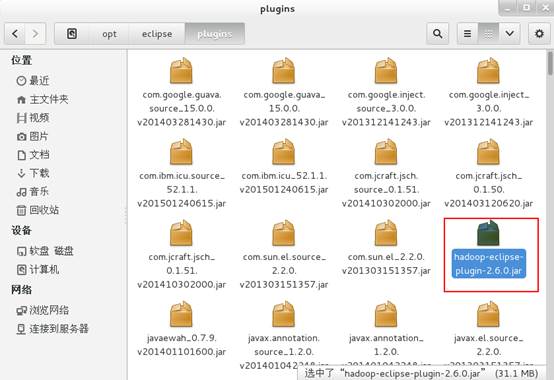
3、在eclipse->Windows->preferences设置Hadoop路径。
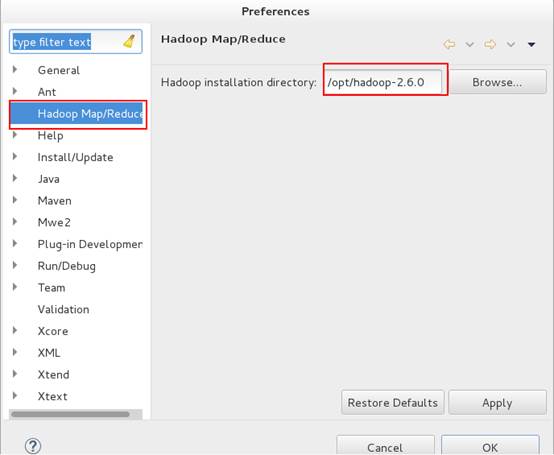
至此,插件安装完成。
3、ChineseWordCount源码
package com.example.test;

import java.io.IOException;

import java.io.InputStream;

import java.io.InputStreamReader;

import java.io.Reader;

import java.io.ByteArrayInputStream;

import org.wltea.analyzer.core.IKSegmenter;

import org.wltea.analyzer.core.Lexeme;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.GenericOptionsParser;

public class ChineseWordCount {

    public static class TokenizerMapper extends

            Mapper<Object, Text, Text, IntWritable> {

        private final static IntWritable one = new IntWritable(1);

        private Text word = new Text();

        public void map(Object key, Text value, Context context)

                throws IOException, InterruptedException {

            byte[] bt = value.getBytes();

            InputStream ip = new ByteArrayInputStream(bt);

            Reader read = new InputStreamReader(ip);

            IKSegmenter iks = new IKSegmenter(read, true);

            Lexeme t;

            while ((t = iks.next()) != null) {

                word.set(t.getLexemeText());

                context.write(word, one);

            }

        }

    }

    public static class IntSumReducer extends

            Reducer<Text, IntWritable, Text, IntWritable> {

        private IntWritable result = new IntWritable();

        public void reduce(Text key, Iterable<IntWritable> values,

                Context context) throws IOException, InterruptedException {

            int sum = 0;

            for (IntWritable val : values) {

                sum += val.get();

            }

            result.set(sum);

            context.write(key, result);

        }

    }

    public static void main(String[] args) throws Exception {

        Configuration conf = new Configuration();

        String[] otherArgs = new GenericOptionsParser(conf, args)

                .getRemainingArgs();

        if (otherArgs.length != 2) {

            System.err.println("Usage: wordcount <in> <out>");

            System.exit(2);

        }

        Job job = new Job(conf, "word count");

        job.setJarByClass(ChineseWordCount.class);

        job.setMapperClass(TokenizerMapper.class);

        job.setCombinerClass(IntSumReducer.class);

        job.setReducerClass(IntSumReducer.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        FileInputFormat.addInputPath(job, new Path(otherArgs[0]));

        FileOutputFormat.setOutputPath(job, new Path(otherArgs[1]));

        System.exit(job.waitForCompletion(true) ? 0 : 1);

    }

}
4、创建Hadoop工程
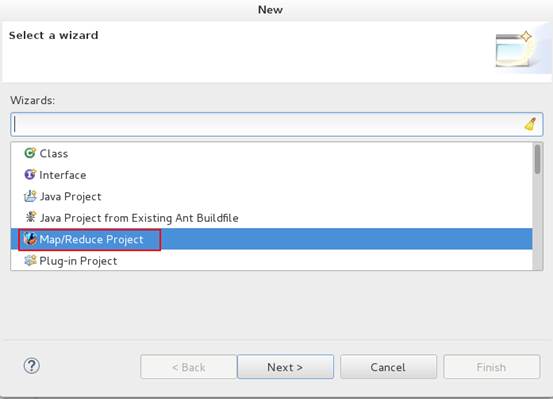
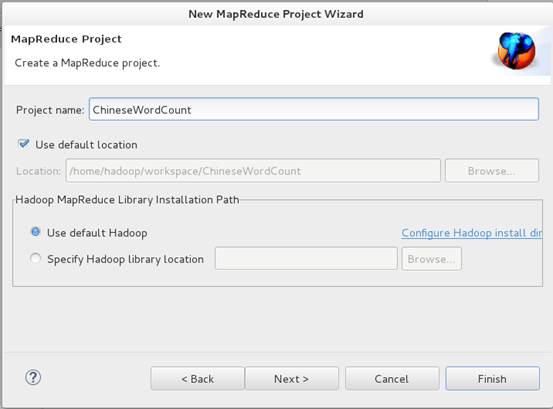
1、创建一个Map/Reduce Project,名称为ChineseWordCount。
2、创建包com.example.test,创建ChineseWordCount类文件。
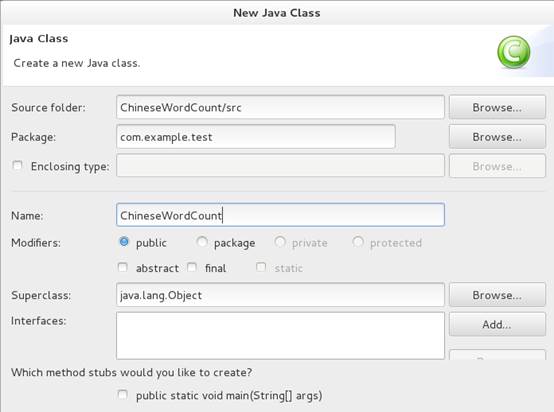
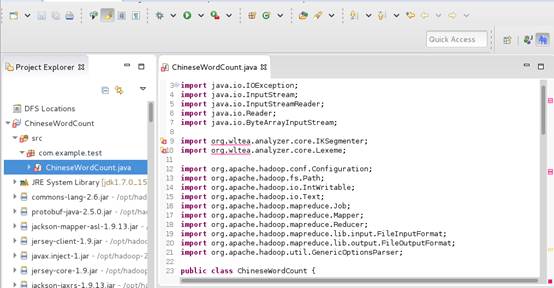
3、导入IkAnalyzer包。
下载地址:http://code.google.com/p/ik-analyzer/
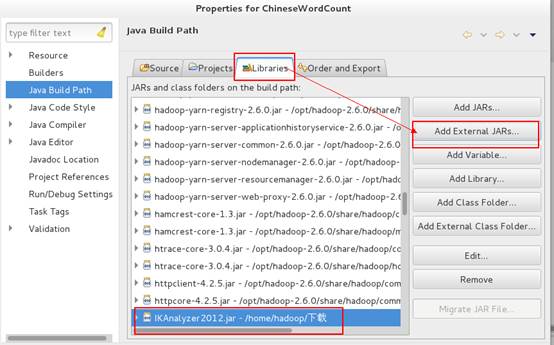
至此,Hadoop工程新建完成。
5、运行工程
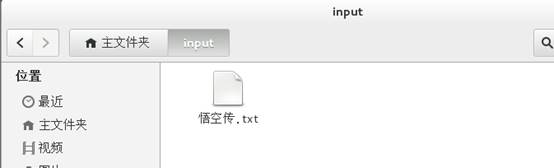
1、在/home/hadoop/目录下新建一个input文件夹,将中文文本"悟空传.txt"复制到里面。

2、在eclipse中设置运行参数。
操作时遇到一个问题,当运行参数设置成/opt/hadoop-2.6.0/input/*.* /opt/hadoop-2.6.0/output时,无法运行成功,我想会不会是访问权限的问题,这个下次再解决。
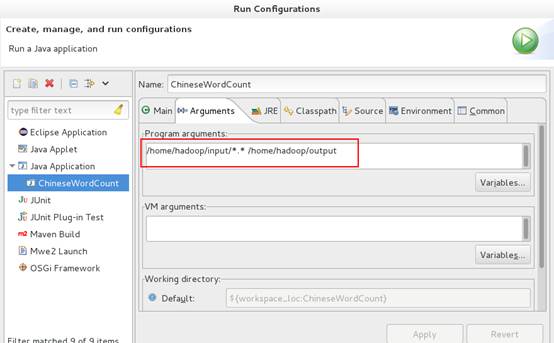
3、点击运行。
6、查看结果
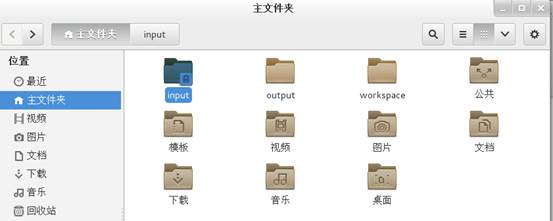

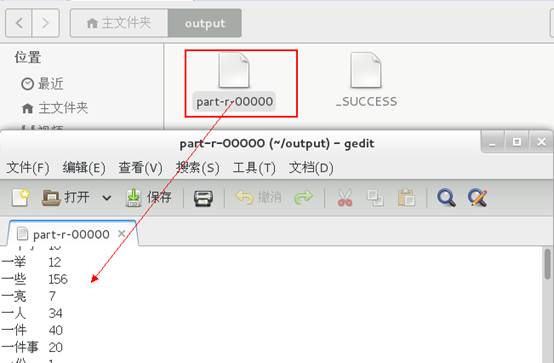
至此,中文词频统计运行成功。
7、总结
这次的中文词频统计只是一个简单的实验,还需要继续完善统计功能,比如词频数量的排序,去除单字统计等等。这方面我接触的还不深,希望有经验的朋友能给我一些学习建议和意见,谢谢。
初学Hadoop之中文词频统计的更多相关文章
- 初学Hadoop之WordCount词频统计
1.WordCount源码 将源码文件WordCount.java放到Hadoop2.6.0文件夹中. import java.io.IOException; import java.util.Str ...
- Python中文词频统计
以下是关于小说的中文词频统计 这里有三个文件,分别为novel.txt.punctuation.txt.meaningless.txt. 这三个是小说文本.特殊符号和无意义词 Python代码统计词频 ...
- 如何用java完成一个中文词频统计程序
要想完成一个中文词频统计功能,首先必须使用一个中文分词器,这里使用的是中科院的.下载地址是http://ictclas.nlpir.org/downloads,由于本人电脑系统是win32位的,因此下 ...
- Java实现中文词频统计
昨日有个中文词频统计的需求, 百度一番后, 发现一大堆标题党文章, 讲的与内容严重不符, 这里就简单记录下自己实现的流程吧! 与英文单词的词频统计不同, 中文的难点在于如何分词, 不过好在有许多优秀的 ...
- jieba (中文词频统计) 、collections (字频统计)、WordCloud (词云)
py库: jieba (中文词频统计) .collections (字频统计).WordCloud (词云) 先来个最简单的: # 查找列表中出现次数最多的值 ls = [1, 2, 3, 4, 5, ...
- py库: jieba (中文词频统计) 、collections (字频统计)、WordCloud (词云)
先来个最简单的: # 查找列表中出现次数最多的值 ls = [1, 2, 3, 4, 5, 6, 1, 2, 1, 2, 1, 1] ls = ["呵呵", "呵呵&qu ...
- Python实现简单中文词频统计示例
简单统计一个小说中哪些个汉字出现的频率最高: import codecs import matplotlib.pyplot as plt from pylab import mpl mpl.rcPar ...
- Programming | 中/ 英文词频统计(MATLAB实现)
一.英文词频统计 英文词频统计很简单,只需借助split断句,再统计即可. 完整MATLAB代码: function wordcount %思路:中文词频统计涉及到对"词语"的判断 ...
- Hadoop上的中文分词与词频统计实践 (有待学习 http://www.cnblogs.com/jiejue/archive/2012/12/16/2820788.html)
解决问题的方案 Hadoop上的中文分词与词频统计实践 首先来推荐相关材料:http://xiaoxia.org/2011/12/18/map-reduce-program-of-rmm-word-c ...
随机推荐
- 移动端头部适配 meta基础知识
meta基础知识 H5页面窗口自动调整到设备宽度,并禁止用户缩放页面 <meta name="viewport" content="width=device-wid ...
- 【转】C#中静态方法和非静态方法的区别
源地址:https://www.cnblogs.com/amoshu/p/7477757.html 备注:静态方法不需要类的实例化就能调用,因为它是一直保存在内存中,不像非静态方法一样要放在实例化类时 ...
- [Swift]八大排序算法(一):冒泡排序
排序分为内部排序和外部排序. 内部排序:是指待排序列完全存放在内存中所进行的排序过程,适合不太大的元素序列. 外部排序:指的是大文件的排序,即待排序的记录存储在外存储器上,待排序的文件无法一次装入内存 ...
- 微服务架构下分布式事务解决方案——阿里云GTS
https://blog.csdn.net/jiangyu_gts/article/details/79470240 1 微服务的发展 微服务倡导将复杂的单体应用拆分为若干个功能简单.松耦合的服务,这 ...
- 基于openstack搭建百万级并发负载均衡器的解决方案
最近,喜欢研究一些国外技术大咖们的文章,而这篇文章是基于openstack负载均衡器的解决方案,做的一些总结~希望能够给小伙伴带来一些灵感或者帮助. openstack现有的负载均衡解决方案,无论是l ...
- poll?transport=longpoll&connection...烦人的请求
2016-06-19 11:50 76人阅读 评论(0) 收藏 举报 分类: C#那点事 版权声明:本文为博主原创文章,未经博主允许不得转载. 1.问题描述: 最近使用miniui做了一个后台管理系 ...
- R语言排序函数汇总
总结: 1.sort是直接对向量排序,返回原数值: 2.order先对数值排序,然后返回排序后各数值的索引: 3.rank返回原数据各项排名,有并列的情况: 4.arrange是dplyr包中的,可对 ...
- POJ1064 Cable master 【二分找最大值】
题目:题目太长了! https://vjudge.net/problem/POJ-1064 题意分析:给了你N根长度为小数形式的棍子,再给出了你需要分的棍子的数量K,但要求你这K根棍子的长度必须是一样 ...
- 获取Java class或者jar文件的本地路径
对于常规java class打成jar文件后,要获取它的本地路径,可以用如下方法. final File f = new File(TestClass.class.getProtectionDomai ...
- Java8如何用
2014年发布的Java8,现在应该是业界使用最普遍的Java版本,可很多Java开发人员并没有充分发挥这4年前发布的版本的优点, 本文就是带着“学以致用”的目的去了解Java8,挖掘编码中可提高效率 ...