
常见数据挖掘算法的Map-Reduce策略(2)
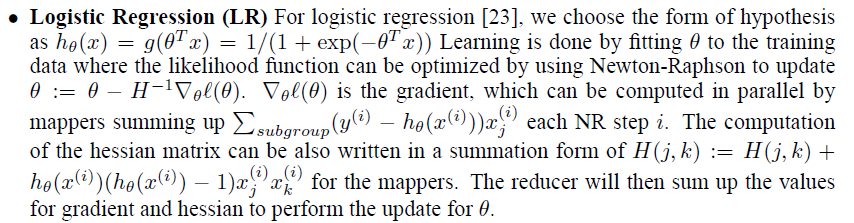
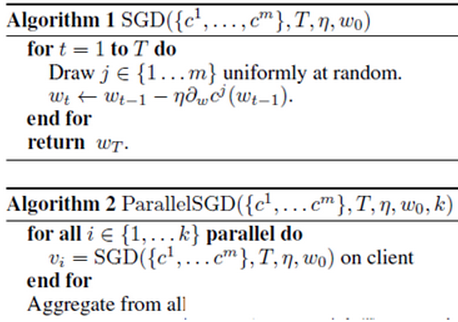
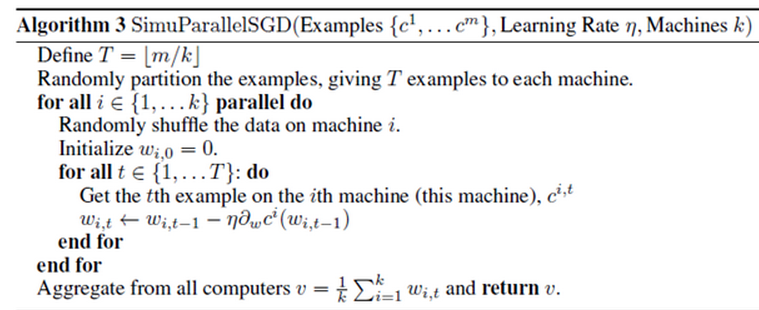
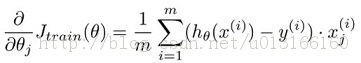 ,每一次迭代的个过程可以转换成一个map-reduce过程,按行或者按列拆分数据,分配到N各节点上,每个节点再通过计算,最后,输出到reduce,进行合并更新W权重系数,完成一次迭代过程。下图文献1中也提到LR的并行,不过用的优化方法是
 class MRsvm(MRJob):

     DEFAULT_INPUT_PROTOCOL = 'json_value'

     #一些参数的设置

     def __init__(self, *args, **kwargs):

         super(MRsvm, self).__init__(*args, **kwargs)

         self.data = pickle.load(open('data_path'))

         self.w = 0

         self.eta = 0.69 #学习率

         self.dataList = [] #用于收集样本的列表

         self.k = self.options.batchsize

         self.numMappers = 1

         self.t = 1 # 迭代次数

     def map(self, mapperId, inVals):

         #<key,value> 对应着 <机器mapperID,W值或者样本特征跟标签>

         if False: yield

         #判断value是属于W还是样本ID

         if inVals[0]=='w':

             self.w = inVals[1]

         elif inVals[0]=='x':

             self.dataList.append(inVals[1])

         elif inVals[0]=='t': self.t = inVals[1]

     def map_fin(self):

         labels = self.data[:,-1]; X=self.data[:,0:-1]#解析样本数据

         if self.w == 0: self.w = [0.001]*shape(X)[1] #初始化W

         for index in self.dataList:

             p = mat(self.w)*X[index,:].T #分类该样本

             if labels[index]*p < 1.0:

                 yield (1, ['u', index])#这是错分样本id,记录该样本的id

         yield (1, ['w', self.w]) #map输出该worker的w

         yield (1, ['t', self.t])

     def reduce(self, _, packedVals):

         for valArr in packedVals: #解析数据,错分样本ID,W,迭代次数

             if valArr[0]=='u': self.dataList.append(valArr[1])

             elif valArr[0]=='w': self.w = valArr[1]

             elif valArr[0]=='t': self.t = valArr[1]

         labels = self.data[:,-1]; X=self.data[:,0:-1]

         wMat = mat(self.w); wDelta = mat(zeros(len(self.w)))

         for index in self.dataList:

             wDelta += float(labels[index])*X[index,:] #更新W

         eta = 1.0/(2.0*self.t) #更新学习速率

         #累加对W的更新

         wMat = (1.0 - 1.0/self.t)*wMat + (eta/self.k)*wDelta

         for mapperNum in range(1,self.numMappers+1):

             yield (mapperNum, ['w', wMat.tolist()[0] ])

             if self.t < self.options.iterations:

                 yield (mapperNum, ['t', self.t+1])

                 for j in range(self.k/self.numMappers):

                     yield (mapperNum, ['x', random.randint(shape(self.data)[0]) ])

     def steps(self):

         return ([self.mr(mapper=self.map, reducer=self.reduce,

                          mapper_final=self.map_fin)]*self.options.iterations)
2,《Map-Reduce for Machine Learning on Multicore NG的一篇nips文章》
4,http://www.csdn.net/article/2014-02-13/2818400-2014-02-13
常见数据挖掘算法的Map-Reduce策略(2)的更多相关文章
- 常见数据挖掘算法的Map-Reduce策略(1)
大数据这个名词是被炒得越来越火了,各种大数据技术层出不穷,做数据挖掘的也跟着火了一把,呵呵,现今机器学习算法常见的并行实现方式:MPI,Map-Reduce计算框架,GPU方面,grap ...
- MapReduce 支持的部分数据挖掘算法
MapReduce 支持的部分数据挖掘算法 MapReduce 能够解决的问题有一个共同特点:任务可以被分解为多个子问题,且这些子问题相对独立,彼此之间不会有牵制,待并行处理完这些子问题后,任务便被解 ...
- 分布式基础学习(2)分布式计算系统(Map/Reduce)
二. 分布式计算(Map/Reduce) 分 布式式计算,同样是一个宽泛的概念,在这里,它狭义的指代,按Google Map/Reduce框架所设计的分布式框架.在Hadoop中,分布式文件 系统,很 ...
- 分布式基础学习【二】 —— 分布式计算系统(Map/Reduce)
二. 分布式计算(Map/Reduce) 分布式式计算,同样是一个宽泛的概念,在这里,它狭义的指代,按Google Map/Reduce框架所设计的分布式框架.在Hadoop中,分布式文件系统,很大程 ...
- 图解kubernetes scheduler基于map/reduce无锁设计的优选计算
优选阶段通过分离计算对象来实现多个node和多种算法的并行计算,并且通过基于二级索引来设计最终的存储结果,从而达到整个计算过程中的无锁设计,同时为了保证分配的随机性,针对同等优先级的采用了随机的方式来 ...
- 图解kubernetes scheduler基于map/reduce模式实现优选阶段
优选阶段通过分map/reduce模式来实现多个node和多种算法的并行计算,并且通过基于二级索引来设计最终的存储结果,从而达到整个计算过程中的无锁设计,同时为了保证分配的随机性,针对同等优先级的采用 ...
- 【十大经典数据挖掘算法】C4.5
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 决策树模型与学习 决策树(de ...
- 【十大经典数据挖掘算法】Apriori
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 关联分析 关联分析是一类非常有 ...
- 【十大经典数据挖掘算法】CART
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 前言 分类与回归树(Class ...
随机推荐
- JMS 在 SpringBoot 中的使用
当前环境 Mac OS 10.11.x docker 1.12.1 JDK 1.8 SpringBoot 1.5 前言 基于之前一篇“一个故事告诉你什么是消息队列”,了解了消息队列的使用场景以及相关的 ...
- Oracle基础 触发器
一.触发器 触发器是当特定事件出现时自动执行的代码块.比如,每次对员工表进行增删改的操作时,向日志表中添加一条记录.触发器和存储过程是由区别的:触发器是根据某些条件自动执行的,存储过程是手动条用的. ...
- hdu4888 多校B 最大流以及最大流唯一推断+输出方案
题意.给一个矩阵,告诉你每行和.每列和.而且限制所填数不大于k,问矩阵是否唯一. 经典建图不说了.第一次遇到推断最大流唯一性的.学习了:用dfs来推断残网中是否还存在环,若存在,则表明绕这个环走一圈, ...
- 【Java】Java_20 Scanner获取键盘输入
使用Scanner类可以很方便的获取用户的键盘输入,Scanner是一个基于正则表达式子的文本扫描器,他可以从文件.输入流.字符串中解析出基本类型值和字符串值. 例子示意: package com.o ...
- KingdeeK3-修改单据邮件发送的自定义字段
只需要执行类似下面语句即可: update ICTemplateentry set FVisForBillType = 63,flookupcls=6 where fid ='P01' and fhe ...
- 前端性能优化--为什么DOM操作慢? 浅谈DOM的操作以及性能优化问题-重绘重排 为什么要减少DOM操作 为什么要减少操作DOM
前端性能优化--为什么DOM操作慢? 作为一个前端,不能不考虑性能问题.对于大多数前端来说,性能优化的方法可能包括以下这些: 减少HTTP请求(合并css.js,雪碧图/base64图片) 压缩( ...
- Hibernate二次学习一----------Hibernate简单搭建
因为博客园自带的markdown不太好用,因此所有markdown笔记都使用cmd_markdown发布 Hibernate二次学习一----------Hibernate简单搭建: https:// ...
- leetcode第一刷_Binary Tree Zigzag Level Order Traversal
以出现的频率来看.树的层序遍历一定是考察的重点,除非工作人员想找题水数量. zigzag,还是有几道题的,层序的这个非常easy,假设是奇数层.reverse下面就可以.无他.我写的时候预计还不知道这 ...
- dede 文章列表页如何倒序排列
{dede:arclist row='6' typeid='18' orderway='asc'} <li>;<a href="[field:arcurl/]"& ...
- “-Xmx1024m -Xms1024m -Xmn512m -Xss256k”——Java运行参数
[JAVA学习]“-Xmx1024m -Xms1024m -Xmn512m -Xss256k”——Java运行参数 转载 2016年06月13日 19:33:38 2792 年轻代 年老代概念 htt ...