
【十大经典数据挖掘算法】CART
【十大经典数据挖掘算法】系列
1. 前言
分类与回归树(Classification and Regression Trees, CART)是由四人帮Leo Breiman, Jerome Friedman, Richard Olshen与Charles Stone于1984年提出,既可用于分类也可用于回归。本文将主要介绍用于分类的CART。CART被称为数据挖掘领域内里程碑式的算法。
不同于C4.5,CART本质是对特征空间进行二元划分(即CART生成的决策树是一棵二叉树),并能够对标量属性(nominal attribute)与连续属性(continuous attribute)进行分裂。
2. CART生成
前一篇提到过决策树生成涉及到两个问题:如何选择最优特征属性进行分裂,以及停止分裂的条件是什么。
特征选择
CART对特征属性进行二元分裂。特别地,当特征属性为标量或连续时,可选择如下方式分裂:
An instance goes left if CONDITION, and goes right otherwise
即样本记录满足CONDITION则分裂给左子树,否则则分裂给右子树。
标量属性
进行分裂的CONDITION可置为不等于属性的某值;比如,标量属性Car Type取值空间为{Sports, Family, Luxury},二元分裂与多路分裂如下:
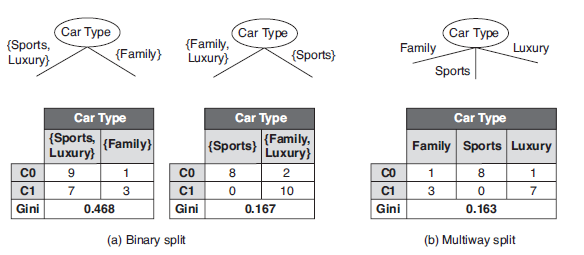
连续属性
CONDITION可置为不大于\(\varepsilon\);比如,连续属性Annual Income,\(\varepsilon\)取属性相邻值的平均值,其二元分裂结果如下:
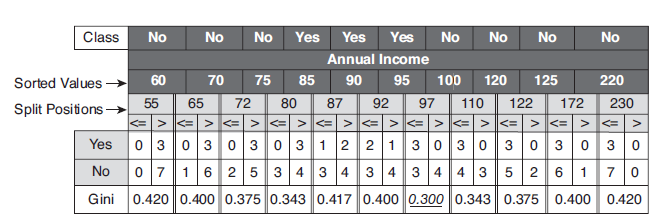
接下来,需要解决的问题:应该选择哪种特征属性及定义CONDITION,才能分类效果比较好。CART采用Gini指数来度量分裂时的不纯度,之所以采用Gini指数,是因为较于熵而言其计算速度更快一些。对决策树的节点\(t\),Gini指数计算公式如下:
\begin{equation}
Gini(t)=1-\sum\limits_{k}[p(c_k|t)]^2
\end{equation}
Gini指数即为\(1\)与类别\(c_k\)的概率平方之和的差值,反映了样本集合的不确定性程度。Gini指数越大,样本集合的不确定性程度越高。分类学习过程的本质是样本不确定性程度的减少(即熵减过程),故应选择最小Gini指数的特征分裂。父节点对应的样本集合为\(D\),CART选择特征\(A\)分裂为两个子节点,对应集合为\(D_L\)与\(D_R\);分裂后的Gini指数定义如下:
\begin{equation}
G(D,A)={\left|{D_L} \right| \over \left|{D} \right|}Gini(D_L)+{\left|{D_R} \right| \over \left|{D} \right|}Gini(D_R)
\end{equation}
其中,\(\left| \cdot \right|\)表示样本集合的记录数量。
CART算法
CART算法流程与C4.5算法相类似:
- 若满足停止分裂条件(样本个数小于预定阈值,或Gini指数小于预定阈值(样本基本属于同一类,或没有特征可供分裂),则停止分裂;
- 否则,选择最小Gini指数进行分裂;
- 递归执行1-2步骤,直至停止分裂。
3. CART剪枝
CART剪枝与C4.5的剪枝策略相似,均以极小化整体损失函数实现。同理,定义决策树\(T\)的损失函数为:
\begin{equation}
L_\alpha (T)=C(T)+\alpha \left| T \right|
\end{equation}
其中,\(C(T)\)表示决策树的训练误差,\(\alpha\)为调节参数,\(\left| T \right|\)为模型的复杂度。
CART算法采用递归的方法进行剪枝,具体办法:
- 将\(\alpha\)递增\(0={\alpha}_0<{\alpha}_1<{\alpha}_2<\cdots<{\alpha}_n\),计算得到对应于区间\([\alpha_{i},{\alpha}_{i+1})\)的最优子树为\(T_i\);
- 从最优子树序列\(\lbrace T_1,T_2,\cdots,T_n \rbrace\)选出最优的(即损失函数最小的)。
如何计算最优子树为\(T_i\)呢?首先,定义以\(t\)为单节点的损失函数为
\[
L_\alpha (t)=C(t)+\alpha
\]
以\(t\)为根节点的子树\(T_t\)的损失函数为
\[
L_\alpha (T_t)=C(T_t)+\alpha \left| T_t \right|
\]
令\(L_\alpha (t)=L_\alpha (T_t)\),则得到
\[
\alpha = {C(t)-C(T_t) \over \left| T_t \right|-1}
\]
此时,单节点\(t\)与子树\(T_t\)有相同的损失函数,而单节点\(t\)的模型复杂度更小,故更为可取;同时也说明对节点\(t\)的剪枝为有效剪枝。由此,定义对节点\(t\)的剪枝后整体损失函数减少程度为
\[
g(t) = {C(t)-C(T_t) \over \left| T_t \right|-1}
\]
剪枝流程如下:
- 对输入决策树\(T_0\),自上而下计算内部节点的\(g(t)\);选择最小的\(g(t)\)作为\({\alpha}_1\),并进行剪枝得到树\(T_1\),其为区间\([{\alpha}_1,{\alpha}_2)\)对应的最优子树。
- 对树\(T_1\),再次自上而下计算内部节点的\(g(t)\);……\(\alpha _2\)……\(T_2\)……
- 如此递归地得到最优子树序列,采用交叉验证选取最优子树。
关于CART剪枝算法的具体描述请参看[1],其中关于剪枝算法的描述有误:
(6)如果T不是由根节点单独构成的树,则回到步骤(4)
应改为回到步骤(3),要不然所有\(\alpha\)均一样了。
-----------------------------------------------Update ------------------------------------------------------
李航老师已经在勘误表给出修改了。
4. 参考资料
[1] 李航,《统计学习方法》.
[2] Pang-Ning Tan, Michael Steinbach, Vipin Kumar, Introduction to Data Mining.
[3] Dan Steinberg, The Top Ten Algorithms in Data Mining.
【十大经典数据挖掘算法】CART的更多相关文章
- 【十大经典数据挖掘算法】PageRank
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 我特地把PageRank作为[十大经 ...
- 【十大经典数据挖掘算法】EM
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 极大似然 极大似然(Maxim ...
- 【十大经典数据挖掘算法】AdaBoost
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 集成学习 集成学习(ensem ...
- 【十大经典数据挖掘算法】SVM
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART SVM(Support Vector ...
- 【十大经典数据挖掘算法】Naïve Bayes
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 朴素贝叶斯(Naïve Bayes) ...
- 【十大经典数据挖掘算法】C4.5
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 决策树模型与学习 决策树(de ...
- 【十大经典数据挖掘算法】k-means
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 引言 k-means与kNN虽 ...
- 【十大经典数据挖掘算法】Apriori
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 关联分析 关联分析是一类非常有 ...
- 【十大经典数据挖掘算法】kNN
[十大经典数据挖掘算法]系列 C4.5 K-Means SVM Apriori EM PageRank AdaBoost kNN Naïve Bayes CART 1. 引言 顶级数据挖掘会议ICDM ...
随机推荐
- Ubuntu安装Gnome3
参考:How To Install GNOME In Ubuntu 14.04 . Ubuntu11.10安装GNOME3,卸载UNITY和UNITY2D操作 和How to install Gnom ...
- jQuery 2.0.3 源码分析 Deferred(最细的实现剖析,带图)
Deferred的概念请看第一篇 http://www.cnblogs.com/aaronjs/p/3348569.html ******************构建Deferred对象时候的流程图* ...
- 细说 Data URI
Data URL 早在 1995 年就被提出,那个时候有很多个版本的 Data URL Schema 定义陆续出现在 VRML 之中,随后不久,其中的一个版本被提上了议案——将它做个一个嵌入式的资源放 ...
- 可以这样去理解group by和聚合函数
写在前面的话:用了好久group by,今天早上一觉醒来,突然感觉group by好陌生,总有个筋别不过来,为什么不能够select * from Table group by id,为什么一定不能是 ...
- 干货!表达式树解析"框架"(1)
最新设计请移步 轻量级表达式树解析框架Faller http://www.cnblogs.com/blqw/p/Faller.html 关于我和表达式树 其实我也没有深入了解表达式树一些内在实现的原理 ...
- ASP.NET MVC 从零开始 - 自动化部署(其二)
这篇文章是从我的 github 博客 http://lxconan.github.io 导入的. 这是这个系列的第五篇了,前四篇请参见: ASP.NET MVC 从零开始 – Create and R ...
- Ubuntu 安装OpenERP
网上的都TM不靠谱.... 1.用root登录,修改/etc/apt/sources.list 文件 sudo /etc/apt/sources.list u root 注意一定要加U root否则没 ...
- 2013 duilib入门简明教程 -- 自绘标题栏(5)
如果大家有做过标题栏的自绘,肯定会感慨各种不容易,并且现有的一些资料虽然完美的实现了功能,但是代码比较乱,需要自行整理.如果用duilib,就是小case啦. duilib其实并没有区 ...
- CentOS 下 MySQL DateBasic 抢救
CentOS 下 MySQL DateBasic 抢救 强 Kill 数据库进程. 分析问题:确定报错内容 报错信息:The server quit without updating PID file ...
- 移动web app开发必备 - Deferred 源码分析
姊妹篇 移动web app开发必备 - 异步队列 Deferred 在分析Deferred之前我觉得还是有必要把老套的设计模式给搬出来,便于理解源码! 观察者模式 观察者模式( 又叫发布者-订阅者模 ...