
【Hadoop基础教程】3、Hadoop之伪分布式环境搭建(转)
伪分布式模式即单节点集群模式,所有的守护进程都运行在同一台机器上。这种模式下增加了代码调试功能,可以查看内存、HDFS文件系统的输入/输出,以及与其他守护进程交互。以hadoop用户远程登录K-Master服务器,在单机模式安装的基础上,我们增加对core-site.xml、hdfs-site.xml、mapred-site.xml核心文件的配置步骤。
开发环境
硬件环境:Centos 6.5 服务器4台(一台为Master节点,三台为Slave节点)
软件环境:Java 1.7.0_45、hadoop-1.2.1
1、 配置Hadoop
1)配置core-site.xml
修改Hadoop核心配置文件/usr/hadoop/conf/core-site.xml,通过fs.default.name指定 NameNode 的 IP 地址和端口号,通过hadoop.tmp.dir指定hadoop数据存储的临时文件夹。
[hadoop@K-Master hadoop] vi conf/core-site.xml

<configuration>

    <property>

        <name>fs.default.name</name>

        <value>hdfs://K-Master:9000</value>

    </property>

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/usr/hadoop/tmp</value>

    </property>

</configuration>
特别注意:如没有配置hadoop.tmp.dir参数,此时系统默认的临时目录为:/tmp/hadoo-hadoop。而这个目录在每次重启后都会被删除,必须重新执行format才行,否则会出错。
2)配置hdfs-site.xml
修改HDFS核心配置文件/usr/hadoop/conf/hdfs-site.xml,通过dfs.replication指定HDFS的备份因子为1,通过dfs.name.dir指定namenode节点的文件存储目录,通过dfs.data.dir指定datanode节点的文件存储目录。
[hadoop@K-Master hadoop] vi conf/hdfs-site.xml

<configuration>

    <property>

        <name>dfs.replication</name>

        <value></value>

    </property>

    <property>

        <name>dfs.name.dir</name>

        <value>/usr/hadoop/hdfs/name</value>

    </property>

    <property>

        <name>dfs.data.dir</name>

        <value>/usr/hadoop/hdfs/data</value>

    </property>

</configuration>
3)配置mapred-site.xml
修改MapReduce核心配置文件/usr/hadoop/conf/mapred-site.xml,通过mapred.job.tracker属性指定JobTracker的地址和端口。
[hadoop@K-Master hadoop] vi conf/mapred-site.xml

<configuration>

    <property>

        <name>mapred.job.tracker</name>

        <value>http://K-Master:9001</value>

    </property>

</configuration>
这里原作者应该是落了个配置项:hadoop-env.sh,不然会出现localhost: Error: JAVA_HOME is not set.
在/hadoop-1.2.1/conf/文件夹里有个hadoop-env.sh的文件,它的作用是配置与hadoop运行环境相关的变量
找到:
# The java implementation to use. Required.
# export JAVA_HOME=/usr/lib/jvm/java-6-sun
将#号去掉,变为:
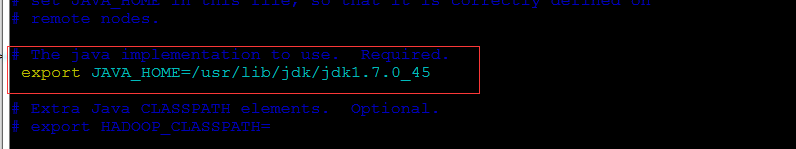
改成你本机的jdk路径,执行完退出
:wq
2、 格式化HDFS文件系统
格式化HDFS文件系统需要在namenode节点上通过hadoop用户执行,而且只需要执行一次,下次启动时不需要再格式化,直接启动HDFS文件管理系统和MapReduce服务即可。
[hadoop@K-Master ~]$ hadoop namenode -format

// :: INFO namenode.NameNode: STARTUP_MSG:

/************************************************************

STARTUP_MSG: Starting NameNode

STARTUP_MSG:   host = K-Master/192.168.100.147

STARTUP_MSG:   args = [-format]

STARTUP_MSG:   version = 1.2.1

STARTUP_MSG:   build = https://svn.apache.org/repos/asf/hadoop/common/branches/branch-1.2 -r 1503152; compiled by 'mattf' on Mon Jul 22 15:23:09 PDT 2013

STARTUP_MSG:   java = 1.7.0_65

********************a****************************************/

// :: INFO util.GSet: Computing capacity for map BlocksMap

// :: INFO util.GSet: VM type   = -bit

// :: INFO util.GSet: 2.0% max memory =

// :: INFO util.GSet: capacity  = ^ =  entries

// :: INFO util.GSet: recommended=, actual=

// :: INFO namenode.FSNamesystem: fsOwner=hadoop

// :: INFO namenode.FSNamesystem: supergroup=supergroup

// :: INFO namenode.FSNamesystem: isPermissionEnabled=true

// :: INFO namenode.FSNamesystem: dfs.block.invalidate.limit=

// :: INFO namenode.FSNamesystem: isAccessTokenEnabled=false accessKeyUpdateInterval= min(s), accessTokenLifetime= min(s)

// :: INFO namenode.FSEditLog: dfs.namenode.edits.toleration.length =

// :: INFO namenode.NameNode: Caching file names occuring more than  times

// :: INFO common.Storage: Image file /usr/hadoop/hdfs/name/current/fsimage of size  bytes saved in  seconds.

// :: INFO namenode.FSEditLog: closing edit log: position=, editlog=/usr/hadoop/hdfs/name/current/edits

// :: INFO namenode.FSEditLog: close success: truncate to , editlog=/usr/hadoop/hdfs/name/current/edits

// :: INFO common.Storage: Storage directory /usr/hadoop/hdfs/name has been successfully formatted.

// :: INFO namenode.NameNode: SHUTDOWN_MSG:

/************************************************************

SHUTDOWN_MSG: Shutting down NameNode at K-Master/192.168.100.147

************************************************************/
3、 启动HDFS文件管理系统
1)通过start-dfs.sh命令启动HDFS文件管理系统,启动后通过如下日志信息可以看到在K-Master服务器上分别启动了namenode、datanode和secondarynamenode。
[hadoop@K-Master ~]$ start-dfs.sh

starting namenode, logging to /usr/hadoop/libexec/../logs/hadoop-hadoop-namenode-K-Master.out

K-Master: starting datanode, logging to /usr/hadoop/libexec/../logs/hadoop-hadoop-datanode- K-Master.out

K-Master: starting secondarynamenode, logging to /usr/hadoop/libexec/../logs/hadoop-hadoop-secondarynamenode-K-Master.out
2)在K-Master节点上查看启动进程
若打印如下日志信息,表明K-Master服务器上启动了NameNode、SecondaryNameNode2、DataNode服务进程,即K-Master服务器上HDFS文件管理系统启动成功。
[hadoop@K-Master ~]$ jps

 Jps

 NameNode

 SecondaryNameNode

 DataNode
4、 启动MapReduce
1)通过start-mapred.sh命令启动MapReduce分布式计算服务,启动后通过以下日志信息可以看到在K-Master服务器上启动了jobtracker、tasktracker进程。
[hadoop@K-Master ~]$ start-mapred.sh

starting jobtracker, logging to /usr/hadoop/libexec/../logs/hadoop-hadoop-jobtracker-K-Master.out

K-Master: starting tasktracker, logging to /usr/hadoop/libexec/../logs/hadoop-hadoop-tasktracker- K-Master.out
2)K-Master节点上查看启动进程
若打印如下日志信息,表明K-Master服务器上新启动了JobTracker、TaskTracker服务进程,即K-Master服务器上MapReduce启动成功。
[hadoop@K-Master ~]$ jps

 NameNode

 Jps

 JobTracker

 SecondaryNameNode

 TaskTracker

 DataNode
完成上述4步,表明我们成功的完成了Hadoop伪分布式环境的部署,伪分布式模式也叫单节点集群模式,所有的守护进程都运行在同一台机器上,上述实验也证明了这一点,NameNode、SecondaryNameNode、DataNode、JobTracker、TaskTracker所有的守护进程全部运行在K-Master节点之上。
【Hadoop基础教程】3、Hadoop之伪分布式环境搭建(转)的更多相关文章
- 大数据:Hadoop(JDK安装、HDFS伪分布式环境搭建、HDFS 的shell操作)
所有的内容都来源与 Hadoop 官方文档 一.Hadoop 伪分布式安装步骤 1)JDK安装 解压:tar -zxvf jdk-7u79-linux-x64.tar.gz -C ~/app 添加到系 ...
- 【Hadoop离线基础总结】CDH版本Hadoop 伪分布式环境搭建
CDH版本Hadoop 伪分布式环境搭建 服务规划 步骤 第一步:上传压缩包并解压 cd /export/softwares/ tar -zxvf hadoop-2.6.0-cdh5.14.0.tar ...
- Ubuntu 14.04 (32位)上搭建Hadoop 2.5.1单机和伪分布式环境
引言 一直用的Ubuntu 32位系统(准备下次用Fedora,Ubuntu越来越不适合学习了),今天准备学习一下Hadoop,结果下载Apache官网上发布的最新的封装好的2.5.1版,配置完了根本 ...
- Hadoop学习笔记1:伪分布式环境搭建
在搭建Hadoop环境之前,请先阅读如下博文,把搭建Hadoop环境之前的准备工作做好,博文如下: 1.CentOS 6.7下安装JDK , 地址: http://blog.csdn.net/yule ...
- 【Hadoop】伪分布式环境搭建、验证
Hadoop伪分布式环境搭建: 自动部署脚本: #!/bin/bash set -eux export APP_PATH=/opt/applications export APP_NAME=Ares ...
- CentOS7下Hadoop伪分布式环境搭建
CentOS7下Hadoop伪分布式环境搭建 前期准备 1.配置hostname(可选,了解) 在CentOS中,有三种定义的主机名:静态的(static),瞬态的(transient),和灵活的(p ...
- Spark2.4.0伪分布式环境搭建
一.搭建环境的前提条件 环境:ubuntu-16.04 hadoop-2.6.0 jdk1.8.0_161. spark-2.4.0-bin-hadoop2.6.这里的环境不一定需要和我一样,基本版 ...
- Hadoop2.5.0伪分布式环境搭建
本章主要介绍下在Linux系统下的Hadoop2.5.0伪分布式环境搭建步骤.首先要搭建Hadoop伪分布式环境,需要完成一些前置依赖工作,包括创建用户.安装JDK.关闭防火墙等. 一.创建hadoo ...
- hive-2.2.0 伪分布式环境搭建
一,实验环境: 1, ubuntu server 16.04 2, jdk,1.8 3, hadoop 2.7.4 伪分布式环境或者集群模式 4, apache-hive-2.2.0-bin.tar. ...
- HDFS 伪分布式环境搭建
HDFS 伪分布式环境搭建 作者:Grey 原文地址: 博客园:HDFS 伪分布式环境搭建 CSDN:HDFS 伪分布式环境搭建 相关软件版本 Hadoop 2.6.5 CentOS 7 Oracle ...
随机推荐
- 在Visual Studio 2013 上开发Node.js程序
[题外话] 最近准备用Node.js做些东西,于是找找看能否有Visual Studio上的插件以方便开发.结果还真找到了一个,来自微软的Node.js Tools for Visual Studio ...
- cl编译C文件的环境变量修改
添 加环境 变量INCLUDEC:\Program Files (x86)\Windows Kits\10\Include\10.0.10240.0\ucrt;C:\Program Files (x8 ...
- (26)C#WebService
一.创建webservice 二.发布webservice 1.正式发布 (1)配置IIS 自己在局域网用的话,只需1,2,3 三步 1:网站的名称,将来IIS里有多个网站时可以方便区分 2:文件的本 ...
- Bean的实例化--构造器
1,编写Bean对象 package com.songyan.ico; public class Bean1 { } 2,配置xml <?xml version="1.0" ...
- Jackson的高级应用(转)
Jackson 是当前用的比较广泛的,用来序列化和反序列化 JSON 的 Java 的开源框架.Jackson 社 区相对比较活跃,更新速度也比较快, 从 Github 中的统计来看,Jackson ...
- 一种用XAML写Data Converter的方式
在WPF程序中,数据绑定是非常常用的手段.伴随着数据绑定,我们通常还需要编写一些Converter.而编写Converter是一件非常枯燥的事情,并且大量的converter不容易组织和维护. 今天在 ...
- MongoDB 聚合Group(一)
原文:http://blog.csdn.net/congcong68/article/details/45012717 一.简介 db.collection.group()使用JavaScript,它 ...
- GPU hang
最近做新项目 初期一直遇到个gpu hang的问题 就是command 提交过去gpu 就一直在那里 直到time out 也没什么别的错误提示 gpu debugger还抓不了 解决方案是 缩小之后 ...
- 什么是滤波器,滤波器是干嘛用的,IIR和FIR滤波器又是什么?(回答请简洁,别浪费大家时间)
信号频率筛选器,用于阻挡不需要的信号: 低通滤波用来阻挡某一频率之上的所有信号: 高通滤波用来阻挡某一频率之下的所有信号: 另外还有带通滤波器,带阻滤波器..... 个人理解,就像是个过滤沙子的筛子一 ...
- java.lang.NoSuchFieldError:INSTANCE
Java.lang.NoSuchFieldError: INSTANCE异常,可能是包重复了. 我遇到的情况是maven里引入了一个JAR,而我又在lib里面引入了这个jar,并且版本还不相同,就出了 ...