
Kettle系列:使用Kudu API插入数据到Kudu中
本文详细介绍了在Kettle中使用 Kudu API将数据写入Kudu中, 从本文可以学习到:
1. 如何编写一个简单的 Kettle 的 Used defined Java class.
2. 如何读取Kettle 每个记录的字段. 需要注意的是 getInteger() 返回的是Long 对象; 而获取 Timestamp 字段的方法是getDate().
3. 如何调用Kudu API.
本Kettle示例非常简单, Data Grid 组件定义一些sample data(包含多种数据类型), Java class将这些sample data写入kudu.
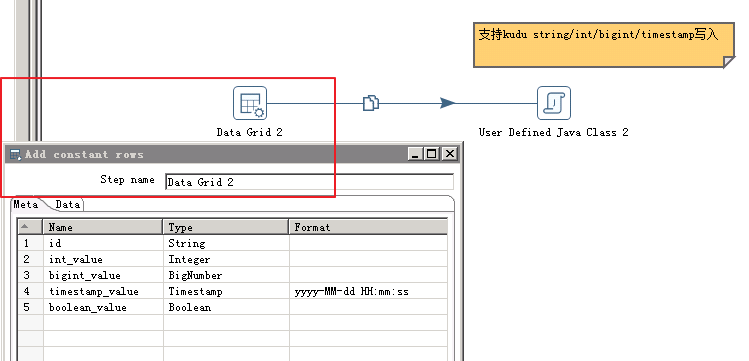
Kudu表schema:
CREATE TABLE kudu_testdb.perf_test_t1

(

    id string ENCODING PLAIN_ENCODING COMPRESSION SNAPPY,

    int_value int,

    bigint_value bigint,

    timestamp_value timestamp,

    bool_value int,

    PRIMARY KEY (histdate,id)

)

PARTITION BY HASH (histdate,id) PARTITIONS 2

STORED AS KUDU

TBLPROPERTIES (

  'kudu.table_name' = 'testdb.perf_test_t1',

  'kudu.master_addresses' = '10.205.6.1:7051,10.205.6.2:7051,10.205.7.3:7051'

);
重点看Java class 代码:
import java.sql.Timestamp;

import java.util.UUID;

import static java.lang.Math.toIntExact;

import org.apache.kudu.client.Insert;

import org.apache.kudu.client.KuduClient;

import org.apache.kudu.client.KuduException;

import org.apache.kudu.client.KuduSession;

import org.apache.kudu.client.KuduTable;

import org.apache.kudu.client.PartialRow;

import org.apache.kudu.client.SessionConfiguration;

private final static String KUDU_TABLE="testdb.perf_test_t1";

private final static String KUDU_SERVERS="10.205.6.1:7051,10.205.6.2:7051,10.205.7.3:7051";

private final static int OPERATION_BATCH = 50;

KuduClient client=null;

KuduSession session=null;

KuduTable table=null;

Integer recordCount=null;

SessionConfiguration.FlushMode mode;

private Object[] previousRow;

private Object[] currentRow;

public boolean processRow(StepMetaInterface smi, StepDataInterface sdi) throws KettleException {

  if (first) {

    first = false;

  }

  currentRow = getRow();

  if (currentRow == null) {

    setOutputDone();

    return false;

  }

    try {

        session.setFlushMode(mode);

        session.setMutationBufferSpace(OPERATION_BATCH);

        int uncommit = 0;

        while(currentRow != null) {

            Insert insert = table.newInsert();

            PartialRow kuduRow = insert.getRow();

            int intTmp;

            Long longTmp;

            String stringTmp;

            java.util.Date dateTmp;

            Boolean booleanTmp;

            // kettle string -> kudu string

            //kuduRow.addString("id",UUID.randomUUID().toString());

            stringTmp =  get(Fields.In, "id").getString(currentRow);

            if (stringTmp!=null)

            {

               kuduRow.addString("id",stringTmp);

            }

            // kettle int -> kudu int

            //import static java.lang.Math.toIntExact;

            longTmp=get(Fields.In, "int_value").getInteger(currentRow);

            if (longTmp!=null)

            {

               intTmp =toIntExact(get(Fields.In, "int_value").getInteger(currentRow));

               kuduRow.addInt("int_value",  intTmp);

            }

            // kettle bigint -> kudu bigint

            longTmp=get(Fields.In, "bigint_value").getInteger(currentRow);

            if (longTmp!=null)

            {

                 kuduRow.addLong("bigint_value", longTmp);

             }

            // kettle date/timestamp  -> kudu timestamp

            dateTmp= get(Fields.In, "timestamp_value").getDate(currentRow);

            if (dateTmp!=null)

            {

               longTmp=dateTmp.getTime()+8*3600*1000; //转到东8区时间

               kuduRow.addLong("timestamp_value", longTmp*1000);

            }

            // kettle boolean  -> kudu int

            booleanTmp= get(Fields.In, "boolean_value").getBoolean(currentRow);

            if (booleanTmp!=null)

            {

               intTmp=0;

               if (booleanTmp)

                {intTmp=1;}

               kuduRow.addInt("boolean_value", intTmp);

            }

            // 对于手工提交, 需要buffer在未满的时候flush,这里采用了buffer一半时即提交

             uncommit = uncommit + 1;

                if (uncommit > OPERATION_BATCH / 2) {

                    session.flush();

                     uncommit = 0;

                }

            session.apply(insert);

            previousRow=currentRow;

            currentRow=getRow();

        }

        // 对于手工提交, 保证完成最后的提交

        if (uncommit > 0) {

            session.flush();

        }

       } catch (Exception e) {

        e.printStackTrace();

        throw e;

     }

  // Send the row on to the next step.

  //putRow(data.outputRowMeta, currentRow);

  return false;

}

public boolean init(StepMetaInterface stepMetaInterface, StepDataInterface stepDataInterface) {

  try {

         client = new KuduClient.KuduClientBuilder(KUDU_SERVERS).build();

         session = client.newSession();

         table =client.openTable(KUDU_TABLE);

         mode = SessionConfiguration.FlushMode.MANUAL_FLUSH;

       } catch (Exception e) {

        e.printStackTrace();

        throw e;

     }

  return parent.initImpl(stepMetaInterface, stepDataInterface);

}

public void dispose(StepMetaInterface smi, StepDataInterface sdi) {

    try {

            if (!session.isClosed()) {

                session.close();

            }

       } catch (Exception e) {

        e.printStackTrace();

        throw e;

     }

  parent.disposeImpl(smi, sdi);

}
Kettle系列:使用Kudu API插入数据到Kudu中的更多相关文章
- 【转载】C#批量插入数据到Sqlserver中的三种方式
引用:https://m.jb51.net/show/99543 这篇文章主要为大家详细介绍了C#批量插入数据到Sqlserver中的三种方式,具有一定的参考价值,感兴趣的小伙伴们可以参考一下 本篇, ...
- C#批量插入数据到Sqlserver中的四种方式
我的新书ASP.NET MVC企业级实战预计明年2月份出版,感谢大家关注! 本篇,我将来讲解一下在Sqlserver中批量插入数据. 先创建一个用来测试的数据库和表,为了让插入数据更快,表中主键采用的 ...
- sql 批量插入数据到Sqlserver中 效率较高的方法
使用SqlBulk #region 方式二 static void InsertTwo() { Console.WriteLine("使用Bulk插入的实现方式"); Stopwa ...
- 关于从JSP页面插入数据到数据库中乱码问题的解决
问题描述:最近我在写一个j2ee的留言板系统模块,遇到了一个非常让我头大的问题,当我从JSP页面输入数据后,通过hibernate中的业务逻辑类HQL语句把这个数据插入到本地的mysql数据库中,可是 ...
- C#批量插入数据到Sqlserver中的三种方式
本篇,我将来讲解一下在Sqlserver中批量插入数据. 先创建一个用来测试的数据库和表,为了让插入数据更快,表中主键采用的是GUID,表中没有创建任何索引.GUID必然是比自增长要快的,因为你生 成 ...
- C#_批量插入数据到Sqlserver中的四种方式
先创建一个用来测试的数据库和表,为了让插入数据更快,表中主键采用的是GUID,表中没有创建任何索引.GUID必然是比自增长要快的,因为你生成一个GUID算法所花的时间肯定比你从数据表中重新查询上一条记 ...
- java批量插入数据进数据库中
方式1: for循环,每一次进行一次插入数据. 方式2: jdbc的preparedStatement的batch操作 PreparedStatement.addBatch(); ...... Pre ...
- C# 之 批量插入数据到 SQLServer 中
创建一个用来测试的数据库和表,为了让插入数据更快,表中主键采用的是GUID,表中没有创建任何索引.GUID必然是比自增长要快.而如果存在索引的情况下,每次插入记录都会进行索引重建,这是非常耗性能的.如 ...
- C#批量插入数据到Sqlserver中的四种方式 - 转
先创建一个用来测试的数据库和表,为了让插入数据更快,表中主键采用的是GUID,表中没有创建任何索引.GUID必然是比自增长要快的,因为你生成一个GUID算法所花的时间肯定比你从数据表中重新查询上一条记 ...
随机推荐
- 【BZOJ1831】[AHOI2008]逆序对(动态规划)
[BZOJ1831][AHOI2008]逆序对(动态规划) 题面 BZOJ 洛谷 题解 显然填入的数拎出来是不降的. 那么就可以直接大力\(dp\). 设\(f[i][j]\)表示当前填到了\(i\) ...
- yyb省选前的一些计划
突然意识到有一些题目的计划,才可以减少大量查水表或者找题目的时间. 所以我决定这样子处理. 按照这个链接慢慢做. 当然不可能只做省选题了. 需要适时候夹杂一些其他的题目. 比如\(agc/arc/cf ...
- 「HNOI2016」最小公倍数 解题报告
「HNOI2016」最小公倍数 考虑暴力,对每个询问,处理出\(\le a,\le b\)的与询问点在一起的联通块,然后判断是否是一个联通块,且联通块\(a,b\)最大值是否满足要求. 然后很显然需要 ...
- Centos7之Gcc安装
1下载Gcc包进行安装https://gcc.gnu.org 下载下来的是一个包文件,但是要进行一系列的编译安装,听麻烦的. 不如直接使用这个yum来从网络上进行安装. 2 yumyum instal ...
- A1115. Counting Nodes in a BST
A Binary Search Tree (BST) is recursively defined as a binary tree which has the following propertie ...
- MySQL排序函数field()详解
在日常开发过程中,排序是经常用到的,有时候有这样的需求. 比如,需要在查询结果中根据某个字段的具体值来排序.如下面例子 上面是一张个人信息 表,假如我们想按照'seiki','iris','xut'来 ...
- django框架中的全文检索Haystack
1.什么是Haystack Haystack是django的开源全文搜索框架(全文检索不同于特定字段的模糊查询,使用全文检索的效率更高 ),该框架支持Solr,Elasticsearch,Whoosh ...
- 2018最完整ITTO分节整理指导(PMP项目管理入门必备)
2018年项目管理基础教材<PMBOK>指南进行了改版,之前的一些PMP资料没有太大帮助,反而会让大家记忆混淆,用最新的会好一些,今天小编就把搜集到的2018年项目管理最详细的ITTO的P ...
- 斯坦福大学公开课机器学习:machine learning system design | trading off precision and recall(F score公式的提出:学习算法中如何平衡(取舍)查准率和召回率的数值)
一般来说,召回率和查准率的关系如下:1.如果需要很高的置信度的话,查准率会很高,相应的召回率很低:2.如果需要避免假阴性的话,召回率会很高,查准率会很低.下图右边显示的是召回率和查准率在一个学习算法中 ...
- java的集合
Collection: 1.list ArrayList.Vector.LinkedList ArrayList是实现了基于动态数组的数据结构,LinkedList基于链表的数据结构. Vector是 ...