
LCA的几种做法
P3379 LCA
$ 1:$蜗牛爬式
void dfs(int u,int fa) {
    f[u]=fa;//预处理father
    for(int i=head[u]; i; i=e[i].nxt) if(e[i].v!=fa) {
            int &w=e[i].w,&v=e[i].v;
            dis[v]=dis[u]+w;
            h[v]=h[u]+1;//预处理深度
            dfs(v,u);
        }
}
int LCA(int x,int y) {
    while(h[x]<h[y])y=f[y];
    while(h[x]>h[y])x=f[x];//移动至同一深度
    while(x!=y) x=f[x],y=f[y];
    return x;
}
复杂度:\(O( log(n) )\) ~ \(O(n)\)
当然,这东西非常好卡,一卡就凉\(->\) \(O(n)\)
事实上,这种暴力算法,数据达到5e5时绝对会T(不卡你也会)...
\(2:\) 倍增大法
复杂度 预处理:\(O(nlog(n))\) 查询:\(O(log(n))\),有常数
算法核心:
\(1.\) 预处理\(fa[i][k]\):i上的第\(2^k\)个祖先(如果没有,记为\(-1\))
--- 预处理方法 \(O(n log(log(n)))\)
--- 递推式 \(fa[i][k]=fa[fa[i][k-1][k-1]\)
--- 外层接k的循环,内层接i的循环
void dfs(int u,int f) {
    fa[u][0]=f;
    for(reg int i=head[u]; i; i=nxt[i]) if(to[i]!=f) {
            reg int &v=to[i],&w=x[i];
            h[v]=h[u]+1;
            dis[v]=dis[u]+w;
            dfs(v,u);
        }
}
void LCA_init() {
    dfs(1,-1);
    for(reg int j=0; j+1<L; j++)
        for(reg int i=1; i<=n; i++) {
            if(fa[i][j]<0)fa[i][j+1]=-1;
            else fa[i][j+1]=fa[f[i][j]][j];
        }
}
\(2.\)通过一种类似于二进制枚举的方法找爸爸,其原理与蜗牛爬式类似
--- \(step1:\)将x,y移动到同一深度
--- \(step2:\)枚举x,y的上层祖先,防止过度移动,倒着循环
int LCA(int x,int y) {
    if(h[x]>h[y])swap(x,y);
    int del=h[y]-h[x];
    for(int i=0; (1<<i)<=del; i++)
        if(del&(1<<i))
            y=f[y][i];
    if(x==y)return x;//这句话很关键,很容易忘,不加会过度
    for(int i=ceil(log(h[x])); i>=0; i--)
        if(fa[x][i]!=fa[y][i])
            x=fa[x][i],y=fa[y][i];
    return fa[x][0];
}
优化\(1:\)预处理 $log[N] $数组
for(int i=2;i<=n;i++)
    Log[i]=Log[i-1]+((1<<Log[i-1]+1)==i);
优化\(2:\) \(dfs\)同时预处理 \(f[i][k]\) 数组
----因为深搜时根的数组会先被处理,不会调用到未处理的区域
void dfs(int u,int f) {
    fa[u][0]=f;
    for(int j=1;j<L;j++)
        if(fa[u][j-1]<0)fa[u][j]=-1;
        else fa[u][j]=fa[fa[u][j-1]][j-1];
    for(reg int i=head[u]; i; i=nxt[i]) if(to[i]!=f) {
            reg int &v=to[i],&w=x[i];
            h[v]=h[u]+1;
            dis[v]=dis[u]+w;
            dfs(v,u);
        }
}
整体代码\(Show\)
#include<cstdio>
#include<cstring>
#include <algorithm>
#include<cmath>
using namespace std;
#define reg register
const int N=5e5+10,LN=23;
int n,m,L,st;
int f[N][LN],h[N];
int to[N<<1],head[N<<1],nxt[N<<1],cnt,Log[N];
#define add(u,v) nxt[++cnt]=head[u],head[u]=cnt,to[head[u]]=v
int rd() {
    int s=0;
    char x=getchar();
    while(x<'0'||x>'9')x=getchar();
    while(x>='0'&&x<='9')s=(s<<1)+(s<<3)+(x^'0'),x=getchar();
    return s;
}

void dfs(int u,int fa) {
    f[u][0]=fa;
    for(int j=1;j<L;j++)
        if(f[u][j-1]<0)f[u][j]=-1;
        else f[u][j]=f[f[u][j-1]][j-1];
    for(int i=head[u]; i; i=nxt[i]) if(to[i]!=fa) {
            reg int &v=to[i];
            h[v]=h[u]+1;
            dfs(v,u);
        }
}
void LCA_init() {
    dfs(st,-1);
    for(int i=2;i<=n;i++)
        Log[i]=Log[i-1]+((1<<Log[i-1]+1)==i);
}
int LCA(int x,int y) {
    if(h[x]>h[y])swap(x,y);
    int del=h[y]-h[x];
    for(int i=0; (1<<i)<=del; i++)
        if(del&(1<<i))
            y=f[y][i];
    if(x==y)return x;
    for(int i=Log[h[x]]+1; i>=0; i--)
        if(f[x][i]!=f[y][i])
            x=f[x][i],y=f[y][i];
    return f[x][0];
}
int main() {
    n=rd(),m=rd(),st=rd();
    L=ceil(log(n));
    for(int i=1,u,v,w; i<n; i++)
        u=rd(),v=rd(),add(u,v),add(v,u);
    LCA_init();
    for(int i=1,a,b; i<=m; i++)
        a=rd(),b=rd(),printf("%d\n",LCA(a,b));
}
\(3.\)重链剖分
查询原理:与蜗牛爬类似
实际上,我们可以注意到蜗牛爬式大部分时间的浪费在一个个找上
而我们通过重链剖分使这个过程加快
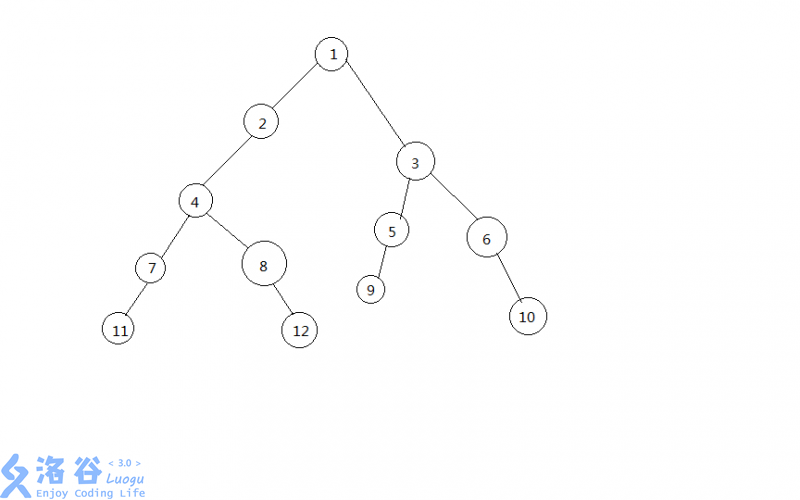
对于查询\(LCA(11,9)\),蜗牛爬式给出的过程是
11,9
7,9
4,5
2,3
1,1
1
一个个爬上去
事实上 \(11-7-4\)的过程可以化为\(11-4\)
同样的 \(4-2-1\) 化为\(4-1\) 等等
这条链越长,其中无用的部分越多,所以把一条条链分出来非常有必要
所以有了重链剖分,这是它的过程
11,9
4,9
4,3
4,1
1
过程简化了不少,当链越长,效果越好
算法核心:
维护\(size[N],son[N],top[N],fa[N],depth[N]\)数组
\(size[N]:\)这个子树的结点数量
\(son[N]:\)这个结点下最重的儿子
\(top[N]:\)这条链的顶端
\(fa[N]:\)这个结点的父亲
\(depth[N]:\)这个节点的深度
这个过程可以在两次深搜内解决
void dfs1(int u,int f) {
    fa[u]=f;
    son[u]=0,size[u]=1;
    for(int i=head[u]; i; i=e[i].nxt) if(e[i].v!=f) {
            int &v=e[i].v;
            depth[v]=depth[u]+1;
            dfs1(v,u);
            if(size[son[u]]<size[v])son[u]=v;
            size[u]+=size[v];
        }
}
这里处理了\(fa[N],son[N],size[N],depth[N]\)数组
也就是说,只剩\(top[N]\)了
void dfs2(int u,int t) {
    top[u]=t;
    if(son[u])dfs2(son[u],t);//把这一条链连到底,top都设成t
    else return;//如果是叶节点就不用找了
    for(int i=head[u]; i; i=e[i].nxt) {
        int &v=e[i].v;
        if(v==f[u]||v==son[u])continue;
        dfs2(v,v);//对于其他的轻链,分开处理,以它自己为top
    }
}
查询部分:
int LCA(int x,int y) {
    while(top[x]!=top[y]) {
        if(depth[top[x]]>depth[top[y]])x=fa[top[x]];
        else y=fa[top[y]];
    }
    return depth[x]<depth[y]?x:y;
}
其实与蜗牛爬式类似,跳过了这条链上的移动过程
\(code\)整体\(Show\)
#include<cstdio>
#include<cstring>
#include<vector>
using namespace std;
#define add(__u,__v) e[++cnt].nxt=head[__u],e[head[__u]=cnt].v=__v
#define reg register
inline void rd(reg int &s){
    s=0;
    reg char x=getchar();
    while(x<'0'||x>'9')x=getchar();
    while(x>='0'&&x<='9')s=(s<<1)+(s<<3)+(x^'0'),x=getchar();
}
inline void wt(reg int x){
    reg char buf[10]={0,0},l=0;
    do buf[++l]=x%10;
    while(x/=10);
    if(!l)l=1;
    for(;l;l--)putchar(buf[l]+'0');
}
const int N=1e5+10;
int n,m,st;
int fa[N],head[N<<1],cnt;
struct node {
    int v,nxt;
} e[N<<1];
int depth[N],top[N],son[N],size[N];
void dfs1(int u,int f) {
    fa[u]=f;
    son[u]=0,size[u]=1;
    for(int i=head[u]; i; i=e[i].nxt) if(e[i].v!=f) {
            int &v=e[i].v;
            depth[v]=depth[u]+1;
            dfs1(v,u);
            if(size[son[u]]<size[v])son[u]=v;
            size[u]+=size[v];
        }
}

void dfs2(int u,int t) {
    top[u]=t;
    if(son[u])dfs2(son[u],t);
    else return;
    for(int i=head[u]; i; i=e[i].nxt) {
        int &v=e[i].v;
        if(v==fa[u]||v==son[u])continue;
        dfs2(v,v);
    }
}

int LCA(int x,int y) {
    while(top[x]!=top[y]) {
        if(depth[top[x]]>depth[top[y]])x=fa[top[x]];
        else y=fa[top[y]];
    }
    return depth[x]<depth[y]?x:y;
}

int main() {
    scanf("%d%d%d",&n,&m,&st);
    for(int i=1,u,v; i<n; i++)rd(u),rd(v),add(u,v),add(v,u);
    dfs1(st,0),dfs2(st,st);
    for(int i=1,a,b; i<=m; i++) rd(a),rd(b),wt(LCA(a,b)),putchar('\n');
}
LCA的几种做法的更多相关文章
- Android布局居中的几种做法
Android的布局文件中,如果想让一个组件(布局或View)居中显示在另一个布局(组件)中,可以由这么几种做法: android:layout_gravity android:gravity and ...
- jqGrid中实现radiobutton的两种做法
http://blog.sina.com.cn/s/blog_4f925fc30102e27j.html jqGrid中实现radiobutton的两种做法 ------------------- ...
- SqlServer保留几位小数的两种做法
SqlServer保留几位小数的两种做法 数据库里的 float momey 类型,都会精确到多位小数.但有时候 我们不需要那么精确,例如,只精确到两位有效数字. 解决: 1. 使用 Round( ...
- [置顶]
echarts x轴文字显示不全(xAxis文字倾斜比较全面的3种做法值得推荐)
echarts x轴标签文字过多导致显示不全 如图: 解决办法1:xAxis.axisLabel 属性 axisLabel的类型是object ,主要作用是:坐标轴刻度标签的相关设置.(当然yAxis ...
- LVS+keepalived 的DR模式的两种做法
LVS DR模式搭建 准备工作 三台机器: dr:192.168.13.15 rs1:192.168.13.16 rs2: 192.168.13.17 vip:192.168.13.100 修改DR上 ...
- 代码:PC 链接列表面板border的一种做法(每行之间有分割线)
PC 链接列表面板,border的一种做法 做页面经常遇到一种问题,上面是标题,下面是单行链接列表.为了保证后台套页面方便,所有列表项必须完全一样.但我们无法解决第一行或最后一行多出来的分割线. 使用 ...
- .NET类型转型的四种做法(转)
.NET类型转型的四种做法: ◆ 强制转型:(int)变量名称 ◆ int.Parse(字符串变量名称) ◆ Convert.To类型(变量名称) ◆ TryParse 强制转型 (casting) ...
- Mediocre String Problem (2018南京M,回文+LCP 3×3=9种做法 %%%千年好题 感谢"Grunt"大佬的细心讲解)
layout: post title: Mediocre String Problem (2018南京M,回文+LCP 3×3=9种做法 %%%千年好题 感谢"Grunt"大佬的细 ...
- js函数只执行一次,函数重写,变量控制与闭包三种做法
一.情景需求 调用后台接口需要附带token信息,那么在每个请求的头部添加token的做法就不太优雅了:一个网站请求100次,那就得写添加100次token,假设某天接口有所变动,改起来就十分麻烦了. ...
随机推荐
- 第三章 Maven构建 Java Spring Boot Web项目
3.1 认识Srping Boot Spring Boot是一个框架,是一种全新的编程规范,它的产生简化了对框架的使用,简化了Spring众多的框架中大量的繁琐的配置文件,所以说Spring Bo ...
- Mysql之视图和事务(五)
一:视图 1.问题 对于复杂的查询,往往是有多个数据表进行关联查询而得到,如果数据库因为需求等原因发生了改变,为了保证查询出来的数据与之前相同,则需要在多个地方进行修改,维护起来非常麻烦 解决办法:定 ...
- MySQL基础-2
目录 配置文件的使用 表的分类--数据库引擎 简单的表的增删改查(CRUD) 创建表的完整写法 Mysql中的数据类型 数字类型 字符串类型 枚举和集合 时间和日期 配置文件的使用 大家发现每次进入m ...
- requestAnimationFrame ---- 请求动画帧。
window.requestAnimationFrame() 告诉浏览器——你希望执行一个动画,并且要求浏览器在下次重绘之前调用指定的回调函数更新动画.该方法需要传入一个回调函数作为参数,该回调函数会 ...
- 19、localStorage.getItem得到的是[object Object] 的解决方案
实现本地存储,避免刷新页面数据丢失: localStorage.setItem 只能存储字符串, 所以在储存的时候先将对象转换为字符串 localStorage.setItem("local ...
- Kafka Streams开发入门(4)
背景 上一篇演示了filter操作算子的用法.今天展示一下如何根据不同的条件谓词(Predicate)将一个消息流实时地进行分流,划分成多个新的消息流,即所谓的流split.有的时候我们想要对消息流中 ...
- ajax加载验证码这样不断刷新的文件无法刷新问题
看了很多网站,在前端不设置缓存,这样会把需要缓存的数据漏掉 觉得欺骗浏览器的方式很不错,方式如下 为了在所有浏览器上都能实现点击验证码的刷新功能,我们可以在上述代码中添加随机参数,对浏览器进行欺骗. ...
- 使用icepdf将pdf文件转换成照片(以及隐藏的一个bug)
首先引入依赖: <dependency> <groupId>org.apache.pdfbox</groupId> <artifactId>pdfbox ...
- graylog-日志收集
1.linux主机日志收集 使用syslog协议将系统日志发送到graylog上进行收集,可以指定端口 touch /etc/rsyslog.d/graylog.conf *.* @192.168.9 ...
- destoon6.0 手机版添加下载模块
common.inc.php 里面加入 下载板块的down 名称 在include 文件里 加入 down.inc.php 文件 在 mobile模版里 加入 down.htm 模版文件 在 电脑版 ...