
深入理解groupByKey、reduceByKey区别——本质就是一个local machine的reduce操作
下面来看看groupByKey和reduceByKey的区别:
    val conf = new SparkConf().setAppName("GroupAndReduce").setMaster("local")

    val sc = new SparkContext(conf)

    val words = Array("one", "two", "two", "three", "three", "three")

    val wordsRDD = sc.parallelize(words).map(word => (word, 1))

    val wordsCountWithReduce = wordsRDD.

      reduceByKey(_ + _).

      collect().

      foreach(println)

    val wordsCountWithGroup = wordsRDD.

      groupByKey().

      map(w => (w._1, w._2.sum)).

      collect().

      foreach(println)
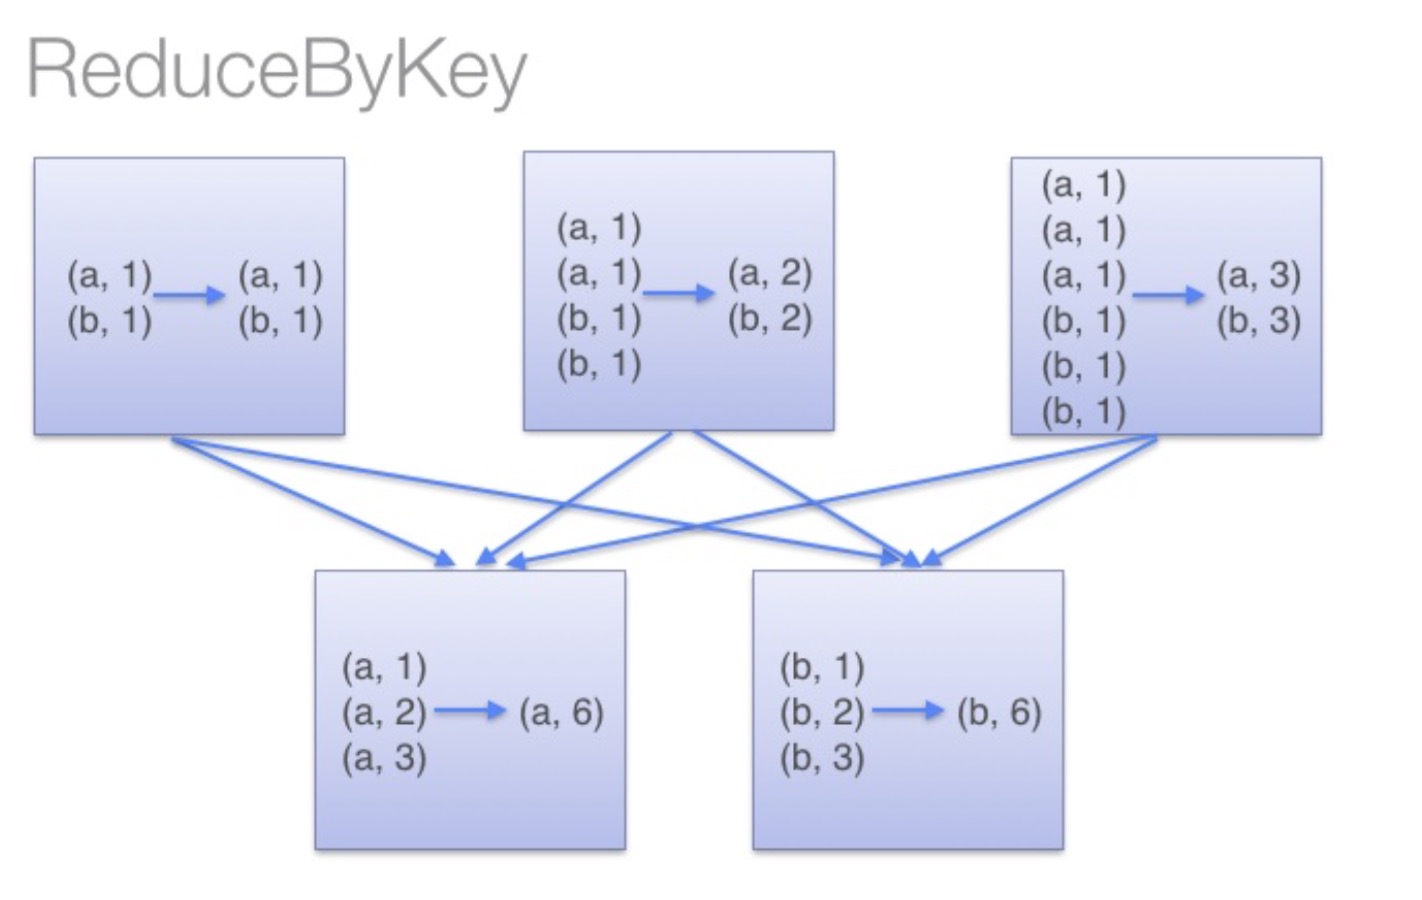
虽然两个函数都能得出正确的结果, 但reduceByKey函数更适合使用在大数据集上。 这是因为Spark知道它可以在每个分区移动数据之前将输出数据与一个共用的key结合。
借助下图可以理解在reduceByKey里发生了什么。 在数据对被搬移前,同一机器上同样的key是怎样被组合的( reduceByKey中的 lamdba 函数)。然后 lamdba 函数在每个分区上被再次调用来将所有值 reduce成最终结果。整个过程如下:
另一方面,当调用 groupByKey时,所有的键值对(key-value pair) 都会被移动,在网络上传输这些数据非常没必要,因此避免使用 GroupByKey。
为了确定将数据对移到哪个主机,Spark会对数据对的key调用一个分区算法。 当移动的数据量大于单台执行机器内存总量时Spark会把数据保存到磁盘上。 不过在保存时每次会处理一个key的数据,所以当单个 key 的键值对超过内存容量会存在内存溢出的异常。 这将会在之后发行的 Spark 版本中更加优雅地处理,这样的工作还可以继续完善。 尽管如此,仍应避免将数据保存到磁盘上,这会严重影响性能。
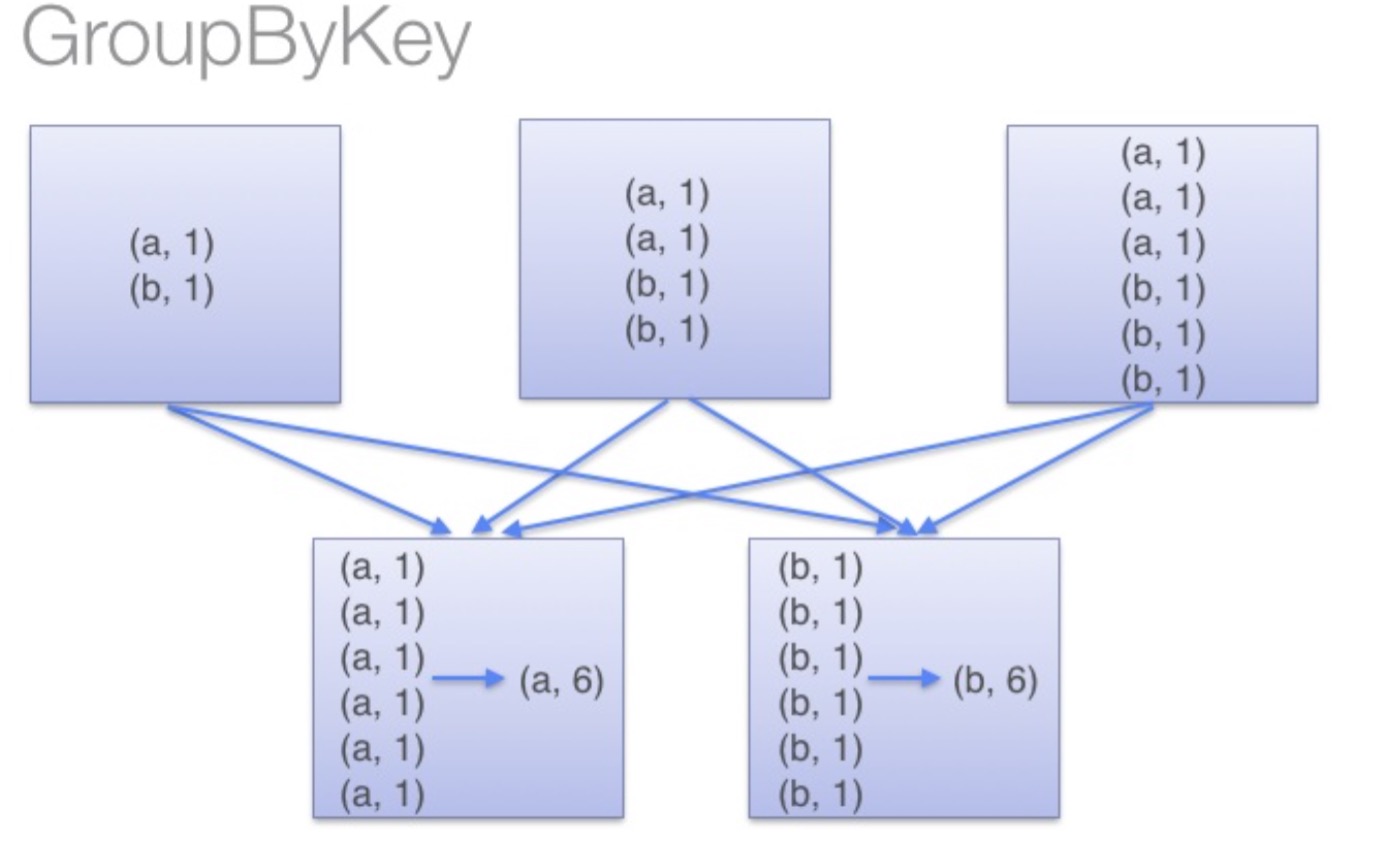
你可以想象一个非常大的数据集,在使用 reduceByKey 和 groupByKey 时他们的差别会被放大更多倍。
摘自:http://www.jianshu.com/p/0c6705724cff
深入理解groupByKey、reduceByKey区别——本质就是一个local machine的reduce操作的更多相关文章
- 转载-reduceByKey和groupByKey的区别
原文链接-https://www.cnblogs.com/0xcafedaddy/p/7625358.html 先来看一下在PairRDDFunctions.scala文件中reduceByKey和g ...
- [Spark RDD_add_1] groupByKey & reduceBykey 的区别
[groupByKey & reduceBykey 的区别] 在都能实现相同功能的情况下优先使用 reduceBykey Combine 是为了减少网络负载 1. groupByKey 是没有 ...
- reduceByKey和groupByKey的区别
先来看一下在PairRDDFunctions.scala文件中reduceByKey和groupByKey的源码 /** * Merge the values for each key using a ...
- Spark 学习笔记之 distinct/groupByKey/reduceByKey
distinct/groupByKey/reduceByKey: distinct: import org.apache.spark.SparkContext import org.apache.sp ...
- (九)groupByKey,reduceByKey,sortByKey算子-Java&Python版Spark
groupByKey,reduceByKey,sortByKey算子 视频教程: 1.优酷 2. YouTube 1.groupByKey groupByKey是对每个key进行合并操作,但只生成一个 ...
- Web框架本质及第一个Django实例 Web框架
Web框架本质及第一个Django实例 Web框架本质 我们可以这样理解:所有的Web应用本质上就是一个socket服务端,而用户的浏览器就是一个socket客户端. 这样我们就可以自己实现Web ...
- php实现反转链表(链表题一定记得画图)(指向链表节点的指针本质就是一个记录地址的变量)($p->next表示的是取p节点的next域里面的数值,next只是p的一个属性)
php实现反转链表(链表题一定记得画图)(指向链表节点的指针本质就是一个记录地址的变量)($p->next表示的是取p节点的next域里面的数值,next只是p的一个属性) 一.总结 链表反转两 ...
- 关于API和SDK的个人理解及两者区别
关于API和SDK的个人理解及两者区别 最近接到公司的一项任务,调用第三方库的一些东西.因此记录一下在使用第三方的功能模块时常常提及到的两个名词--API和SDK. 1.SDK是什么?SDK:概念:软 ...
- String的本质是一个char*,只是以类的形式提供,使用起来比较方便
String的本质是一个char*,只是以类的形式提供,使用起来比较方便 Class String {private: char* m_data;}摘自<后台开发 核心技术与应用实践__徐晓鑫& ...
随机推荐
- iOS - CocoaPods操作详解
在我们进行iOS应用开发的时候,肯定会用到很多的第三方类库,最常用AFNetworking,SDWebImage等等,当我们用到这个类库的时候,就要一个一个的去下载这个类库,如果这个类库中又用到了其他 ...
- 在命令提示符窗口下(cmd)使用指令操作并编译java代码,运行java编译代码
使用cmd操作java代码,编译.java文件,运行.class文件. 操作步骤: 1:创建一个文件夹: 例如:在e盘根目录(\)下面创建一个名为Hello的文件夹: 使用md指令:如图 在e盘中会生 ...
- JavaOO知识点小结一
Java语言的特点是什么?简单 面向对象 跨平台 多线程 健壮性安全性 垃圾回收机制如何编译和执行java文件?产生帮助文档用什么命令?编译: javac 文件名执行: java 类名产生帮助文档 j ...
- Caffe: Vs13添加CUDA支持
1. 右键工程 点击:Building Dependency 右击:Build Customizations 点击选项:CUDA 7.5 2.添加C++依赖: cudart.lib kernel32 ...
- web前端技术与原生技术的竞争, 及未来的发展
用户界面领域: web技术与原生技术之争 除了浏览器中运行之外, html5的技术也在app领域和移动端的安卓, iOS, 以及桌面端的window, linux以及OS X展开了竞争. 同样属于用户 ...
- PHP实现几秒前、几分钟前、几小时前、几天前
/** * @Description: 将时间转换为几秒前.几分钟前.几小时前.几天前 * @Author: Yang * @param $the_time 需要转换的时间 * @return str ...
- Apex语言(九)类的方法
1.方法 方法是对象的行为.如下表: 看书,编程,打球就是方法. 2.创建方法 [格式] 访问修饰符 返回值类型 方法名(形式参数列表){ 方法体; } 访问修饰符:可以为类方法指定访问级别. 例如, ...
- 解析MYsql写的表达式
今天遇到个问题,Sql中直接写的是复杂表达式,如何解析呢? round(((0.00579049505+0.00006600324*JING_JIE^2*SHU_GAO-0.00000046921*J ...
- php多进程防止出现僵尸进程
对于用PHP进行多进程并发编程,不可避免要遇到僵尸进程的问题. 僵尸进程是指的父进程已经退出,而该进程dead之后没有进程接受,就成为僵尸进程(zombie)进程.任何进程在退出前(使用exit退出) ...
- freemarker使用map替换字符串中的值demo2
package demo01; import java.io.IOException;import java.io.OutputStreamWriter;import java.io.StringWr ...