
Python3读取深度学习CIFAR-10数据集出现的若干问题解决
今天在看网上的视频学习深度学习的时候,用到了CIFAR-10数据集。当我兴高采烈的运行代码时,却发现了一些错误:
# -*- coding: utf-8 -*-

import pickle as p

import numpy as np

import os

def load_CIFAR_batch(filename):

    """ 载入cifar数据集的一个batch """

    with open(filename, 'r') as f:

        datadict = p.load(f)

        X = datadict['data']

        Y = datadict['labels']

        X = X.reshape(10000, 3, 32, 32).transpose(0, 2, 3, 1).astype("float")

        Y = np.array(Y)

        return X, Y

def load_CIFAR10(ROOT):

    """ 载入cifar全部数据 """

    xs = []

    ys = []

    for b in range(1, 6):

        f = os.path.join(ROOT, 'data_batch_%d' % (b,))

        X, Y = load_CIFAR_batch(f)

        xs.append(X)

        ys.append(Y)

    Xtr = np.concatenate(xs)

    Ytr = np.concatenate(ys)

    del X, Y

    Xte, Yte = load_CIFAR_batch(os.path.join(ROOT, 'test_batch'))

    return Xtr, Ytr, Xte, Yte
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
- 31
- 32
错误代码如下:
'gbk' codec can't decode byte 0x80 in position 0: illegal multibyte sequence- 1
于是乎开始各种搜索问题,问大佬,网上的答案都是类似:
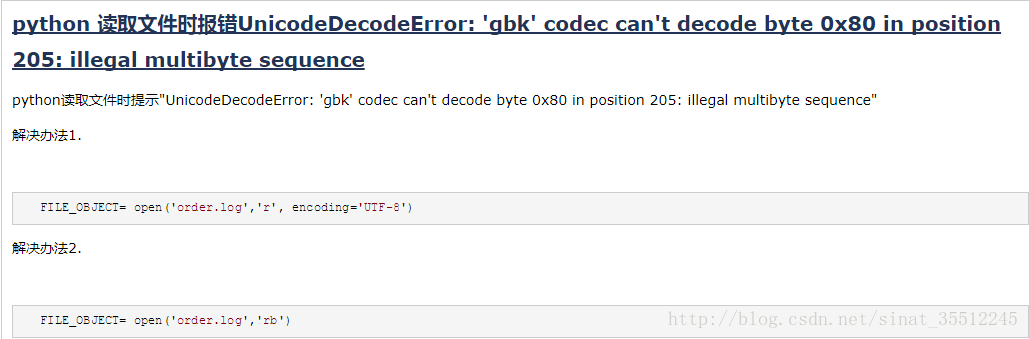
然而并没有解决问题!还是错误的!(我大概搜索了一下午吧,都是上面的答案)
哇,就当我很绝望的时候,我终于发现了一个新奇的答案,抱着试一试的态度,尝试了一下:
def load_CIFAR_batch(filename):

    """ 载入cifar数据集的一个batch """

    with open(filename, 'rb') as f:

        datadict = p.load(f, encoding='latin1')

        X = datadict['data']

        Y = datadict['labels']

        X = X.reshape(10000, 3, 32, 32).transpose(0, 2, 3, 1).astype("float")

        Y = np.array(Y)

return X, Y- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
竟然成功了,这里没有报错了!欣喜之余,我就很好奇,encoding=’latin1’到底是啥玩意呢,以前没有见过啊?于是,我搜索了一下,了解到:
Latin1是ISO-8859-1的别名,有些环境下写作Latin-1。ISO-8859-1编码是单字节编码,向下兼容ASCII,其编码范围是0x00-0xFF,0x00-0x7F之间完全和ASCII一致,0x80-0x9F之间是控制字符,0xA0-0xFF之间是文字符号。
因为ISO-8859-1编码范围使用了单字节内的所有空间,在支持ISO-8859-1的系统中传输和存储其他任何编码的字节流都不会被抛弃。换言之,把其他任何编码的字节流当作ISO-8859-1编码看待都没有问题。这是个很重要的特性,MySQL数据库默认编码是Latin1就是利用了这个特性。ASCII编码是一个7位的容器,ISO-8859-1编码是一个8位的容器。
还没等我高兴起来,运行后,又发现了一个问题:
memory error- 1
什么鬼?内存错误!哇,原来是数据大小的问题。
X = X.reshape(10000, 3, 32, 32).transpose(0,2,3,1).astype("float")- 1
这告诉我们每批数据都是10000 * 3 * 32 * 32,相当于超过3000万个浮点数。 float数据类型实际上与float64相同,意味着每个数字大小占8个字节。这意味着每个批次占用至少240 MB。你加载6这些(5训练+ 1测试)在总产量接近1.4 GB的数据。
 for b in range(1, 2):

        f = os.path.join(ROOT, 'data_batch_%d' % (b,))

        X, Y = load_CIFAR_batch(f)

        xs.append(X)

ys.append(Y)- 1
- 2
- 3
- 4
- 5
所以如有可能,如上代码所示只能一次运行一批。
到此为止,错误基本搞定,下面贴出正确代码:
# -*- coding: utf-8 -*-

import pickle as p

import numpy as np

import os

def load_CIFAR_batch(filename):

    """ 载入cifar数据集的一个batch """

    with open(filename, 'rb') as f:

        datadict = p.load(f, encoding='latin1')

        X = datadict['data']

        Y = datadict['labels']

        X = X.reshape(10000, 3, 32, 32).transpose(0, 2, 3, 1).astype("float")

        Y = np.array(Y)

        return X, Y

def load_CIFAR10(ROOT):

    """ 载入cifar全部数据 """

    xs = []

    ys = []

    for b in range(1, 2):

        f = os.path.join(ROOT, 'data_batch_%d' % (b,))

        X, Y = load_CIFAR_batch(f)

        xs.append(X)         #将所有batch整合起来

        ys.append(Y)

    Xtr = np.concatenate(xs) #使变成行向量,最终Xtr的尺寸为(50000,32,32,3)

    Ytr = np.concatenate(ys)

    del X, Y

    Xte, Yte = load_CIFAR_batch(os.path.join(ROOT, 'test_batch'))

    return Xtr, Ytr, Xte, Yte
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
- 31
- 32
import numpy as np

from julyedu.data_utils import load_CIFAR10

import matplotlib.pyplot as plt

plt.rcParams['figure.figsize'] = (10.0, 8.0)

plt.rcParams['image.interpolation'] = 'nearest'

plt.rcParams['image.cmap'] = 'gray'

# 载入CIFAR-10数据集

cifar10_dir = 'julyedu/datasets/cifar-10-batches-py'

X_train, y_train, X_test, y_test = load_CIFAR10(cifar10_dir)

# 看看数据集中的一些样本:每个类别展示一些

print('Training data shape: ', X_train.shape)

print('Training labels shape: ', y_train.shape)

print('Test data shape: ', X_test.shape)

print('Test labels shape: ', y_test.shape)
顺便看一下CIFAR-10数据组成:
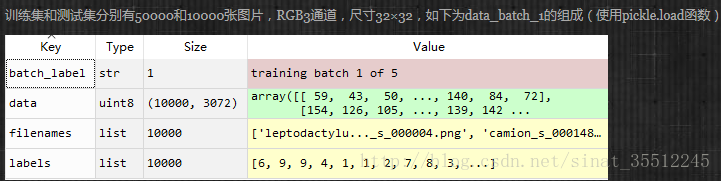
附件:CIFAR-10 python version下载地址
CIFAR-10官网
Python3读取深度学习CIFAR-10数据集出现的若干问题解决的更多相关文章
- TensorFlow从0到1之浅谈深度学习(10)
DNN(深度神经网络算法)现在是AI社区的流行词.最近,DNN 在许多数据科学竞赛/Kaggle 竞赛中获得了多次冠军. 自从 1962 年 Rosenblat 提出感知机(Perceptron)以来 ...
- 64位Win7下安装并配置Python3的深度学习库:Theano
注:本文全原创,作者:Noah Zhang (http://www.cnblogs.com/noahzn/) 这两天在安装Python的深度学习库:Theano.尝试了好多遍,CMake.MinGW ...
- 【神经网络与深度学习】CIFAR-10数据集介绍
CIFAR-10数据集含有6万个32*32的彩色图像,共分为10种类型,由 Alex Krizhevsky, Vinod Nair和 Geoffrey Hinton收集而来.包含50000张训练图片, ...
- win10下python3安装深度学习一般要用的库
matplotlib :绘图库 seaborn:基于matplotlib的图形可视化包 numpy:函数.矩阵运算库 pandas :基于numpy的结构化数据分析库 首先看一下cmd能不能使用pip ...
- Python3+Selenium3+webdriver学习笔记10(元素属性、页面源码)
#!/usr/bin/env python# -*- coding:utf-8 -*-'''Selenium3+webdriver学习笔记10(元素属性.页面源码)'''from selenium i ...
- 深度学习常用数据集 API(包括 Fashion MNIST)
基准数据集 深度学习中经常会使用一些基准数据集进行一些测试.其中 MNIST, Cifar 10, cifar100, Fashion-MNIST 数据集常常被人们拿来当作练手的数据集.为了方便,诸如 ...
- Recorder︱深度学习小数据集表现、优化(Active Learning)、标注集网络获取
一.深度学习在小数据集的表现 深度学习在小数据集情况下获得好效果,可以从两个角度去解决: 1.降低偏差,图像平移等操作 2.降低方差,dropout.随机梯度下降 先来看看深度学习在小数据集上表现的具 ...
- 深度学习识别CIFAR10:pytorch训练LeNet、AlexNet、VGG19实现及比较(一)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处.联系方式:460356155@qq.com 前面几篇文章介绍了MINIST,对这种简单图片的识别,LeNet-5可以达到99%的识别率. CIFA ...
- CNCC2017中的深度学习与跨媒体智能
CNCC2017中的深度学习与跨媒体智能 转载请注明作者:梦里茶 目录 机器学习与跨媒体智能 传统方法与深度学习 图像分割 小数据集下的深度学习 语音前沿技术 生成模型 基于贝叶斯的视觉信息编解码 珠 ...
随机推荐
- String--->Double 不依赖地域性的转换
double.TryParse(icStr, System.Globalization.NumberStyles.Any, System.Globalization.CultureInfo.Invar ...
- Delphi屏幕截图的实现
首先要获得设备环境的句柄,可以通过GetDC函数来获得,对于这个函数,MSDN上是这样说明的 The GetDC function retrieves a handle to a device con ...
- 1.RCC of STM32F103
开发板用的是8Mhz晶振,即HSE=8,000,000 f103最大支持72Mhz,即SYSCLK=PLLCLK=72Mhz,HSE=8M,所以PLLM=9即可. /* HCLK = SYSCLK * ...
- POJ-3264-Balanced Lineup-线段树模板题-查询区间内最大值和最小值之差
For the daily milking, Farmer John's N cows (1 ≤ N ≤ 50,000) always line up in the same order. One d ...
- vue-select-lang
https://cli.vuejs.org/zh/guide/build-targets.html#%E5%BA%93 https://github.com/lipis/flag-icon-css
- Linux权限命令chmod
一.Linux chmod命令修改文件和文件目录权限(默认情况下只有root用户才能使用).命令格式:chmod+修改内容+要修改的文件或者 目录 或者 chmod -R 修改内容 要修改的文件或者 ...
- Vue的组件及传参
目录 Vue的组件及传参 Vue组件的概念 根组件 子组件(局部组件) 父组件向子组件传值 子组件向父组件传值 Vue的组件及传参 Vue组件的概念 我们首先要知道组件的概念,实际上每一个组件都是一个 ...
- Django的日常-模型层(1)
目录 Django的日常-模型层(1) 模型层 django测试环境 ORM查询 Django的日常-模型层(1) 模型层 模型层其实就是我们应用名下的models.py文件,我们在里面写入想要创建的 ...
- 第五周课堂笔记1th
可迭代对象 Isinstance 判断一个对象是否属于某种类型 接受两个参数 迭代器 以下数据类型都没迭代器: 把没有迭代器的类型更改为有迭代器类型 用迭代器进行取值: 判断迭代器的方法: 3. ...
- <小白学技术>将python脚本导出为exe可执行程序
1.简介(为啥需要导出为exe可执行程序) python写完的程序靠命令来执行,显得太专业,不符合python简单的特点(好吧,主要是太low) 代码给别人执行,别人没有你的python库也没法用(双 ...