|
HADOOP_NAMENODE_OPTS
|
-Dcom.sun.management.jmxremote $HADOOP_NAMENODE_OPTS
|
该选项的值会附加到HADOOP_OPTS之后。在启动NameNode时设置的JVM參数。
如想手动设置NameNode的堆、垃圾回收等信息,能够在这里设置:
,我的内存没有这么大而且測试用例不会用到那么大的堆,所以我也设置了一个这个值。
|
export HADOOP_HEAPSIZE=20
|
HADOOP_PID_DIR:
Hadoop PID文件的存放文件夹,这个最好是改动一下,由于/tmp文件夹通常来说是不论什么人都能够訪问的。有可能存在符合链接攻击的风险。
|
export HADOOP_PID_DIR=/home/fenglibin/hadoop_tmp
|
2、配置$HADOOP_HOME/conf/core-site.xml
參数例如以下(部分):
|
參数
|
默认值
|
说明
|
|
fs.default.name
|
file:///
|
NameNode的URI,如:
hdfs://locahost:9000/
|
|
hadoop.tmp.dir
|
/tmp/hadoop-${user.name}
|
其他暂时文件夹的基本文件夹,
/home/fenglibin/hadoop_tmp
|
|
hadoop.native.lib
|
true
|
是否使用hadoop的本地库
|
|
hadoop.http.filter.initializers
|
空
|
设置Filter初使器,这些Filter必须是hadoop.http.filter.initializers的子类。能够同一时候设置多个,以逗号分隔。这些设置的Filter,将会对全部用户的jsp及servlet页面起作用。Filter的顺序与配置的顺序同样。
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
配置演示样例:
|
<configuration>
<property>
<!-- 用于设置Hadoop的文件系统。由URI指定 -->
<name>fs.default.name</name>
<value>hdfs://localhost:9000</value>
</property>
<property>
<!-- 配置Hadoop的暂时文件夹,默认在/tmp文件夹下,可是/tmp上面可能会被系统自己主动清理掉。-->
<name>hadoop.tmp.dir</name>
<!-- 文件夹假设不存在。须要手动创建 -->
<value>/home/fenglibin/hadoop_tmp</value>
<description>A base for other temperary directory</description>
</property>
</configuration>
|
3、配置$HADOOP_HOME/conf/mapred-site.xml文件
參数例如以下(部分):
|
參数
|
说明
|
演示样例
|
|
mapred.job.tracker
|
配置JobTracker,以Host和IP的形式
|
localhost:9001
|
|
mapred.system.dir
|
MapReduce框架在HDFS存放系统文件的路径。必须能够被server及client訪问得到,默认值:
${hadoop.tmp.dir}/mapred/system
|
${hadoop.tmp.dir}/mapred/system
|
|
mapred.local.dir
|
MapReduce框架在本地的暂时文件夹,能够是多个,以逗号作分隔符,多个路径有助于分散IO的读写,默认值:
${hadoop.tmp.dir}/mapred/local
|
${hadoop.tmp.dir}/mapred/local
|
|
mapred.tasktracker.{map|reduce}.tasks.maximum
|
在同一台指定的TaskTacker上面同一时候独立的运行的MapReduce任务的最大数量,默认值是2(2个maps及2个reduces),这个与你所在硬件环境有非常大的关系,可分别设定。
|
2
|
|
dfs.hosts/dfs.hosts.exclude
|
同意/排除的NataNodes。假设有必要。使用这些文件控制同意的DataNodes。
|
|
|
mapred.hosts/mapred.hosts.exclude
|
同意/排除的MapReduces,假设有必要,使用这些文件控制同意的MapReduces。
|
|
|
mapred.queue.names
|
可用于提交Job的队列,多个以逗号分隔。MapReduce系统中至少存在一个名为“default”的队列,默认值就是“default”。
Hadoop中支持的一些任务定时器,如“Capacity Scheduler”。能够同一时候支持多个队列,假设使用了这样的定时器,那么使用的队列名称就必须在这里指定了。一旦指定了这些队列。用户在提交任务,通过在任务配置时指定“。而系统默认的复制份数为3。例如以下:
|
<configuration>
<property>
<name>dfs.replication</name>
<value>1</value>
</property>
</configuration>
|
6、格式化namenode
7、启动Hadoop
假设是出现例如以下结果,那就说明Hadoop已经成功启动了:
|
fenglibin@ubuntu1110:/usr/local/hadoop-1.2.1$ jps
29339 SecondaryNameNode
29661 Jps
28830 JobTracker
29208 DataNode
28503 NameNode
29514 TaskTracker
|
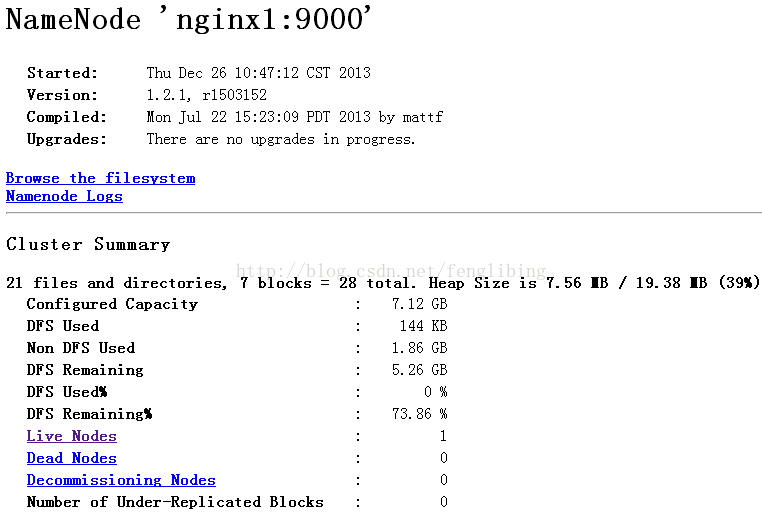
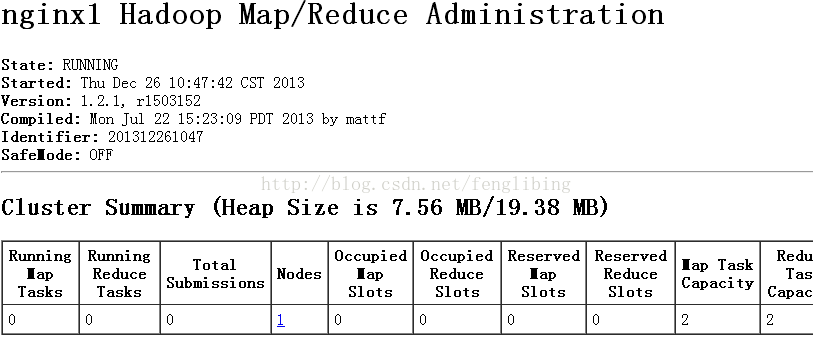
此时我们能够通过WEB方式查看NameNode及Jobtracker的状态了:
NameNode:http://localhost:50070/
JobTracker:http://localhost:50030/
假设仅仅是測试map/reduce,这里仅仅须要启动例如以下命令:
8、启动Hadoop可能会遇到的问题
后面会提到。
- Hadoop入门进阶步步高(一)-环境准备
前言 Hadoop从存储上来说,是相似于冗余磁盘阵列(RAID)的存储方式.将数据分散存储并提供以提供吞吐量,它的存储系统就是HDFS(Hadoop Distuibute Fils System).从 ...
- Hadoop入门进阶步步高(六)-Hadoop1.x与Hadoop2的差别
六.Hadoop1.x与Hadoop2的差别 1.变更介绍 Hadoop2相比較于Hadoop1.x来说,HDFS的架构与MapReduce的都有较大的变化,且速度上和可用性上都有了非常大的提高,Ha ...
- Hadoop入门进阶步步高(五)-搭建Hadoop集群
五.搭建Hadoop集群 上面的步骤,确认了单机能够运行Hadoop的伪分布运行,真正的分布式运行无非也就是多几台slave机器而已,配置方面的有一点点差别,配置起来就很easy了. 1.准备三台se ...
- Hadoop入门进阶步步高(二)-文件夹介绍
二.Hadoop文件夹结构 这里重点介绍几个文件夹bin.conf及lib文件夹. 1.$HADOOP_HOME/bin文件夹 文件名 说明 hadoop 用于运行hadoop脚本命令,被hadoop ...
- Hadoop入门进阶课程4--HDFS原理及操作
本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,博主为石山园,博客地址为 http://www.cnblogs.com/shishanyuan ...
- Hadoop入门进阶课程3--Hadoop2.X64位环境搭建
本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,博主为石山园,博客地址为 http://www.cnblogs.com/shishanyuan ...
- Hadoop入门进阶课程1--Hadoop1.X伪分布式安装
本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,博主为石山园,博客地址为 http://www.cnblogs.com/shishanyuan ...
- 分布式计算开源框架Hadoop入门实践(三)
Hadoop基本流程 一个图片太大了,只好分割成为两部分.根据流程图来说一下具体一个任务执行的情况. 在分布式环境中客户端创建任务并提交. InputFormat做Map前的预处理,主要负责以下工作: ...
- (转)Hadoop入门进阶课程
http://blog.csdn.net/yirenboy/article/details/46800855 1.Hadoop介绍 1.1Hadoop简介 Apache Hadoop软件库是一个框架, ...
随机推荐
- Http中GET和POST请求的区别
https://mp.weixin.qq.com/s/_oLnkDQn3TE7XdFWCT5Img GET请求 GET /books/?sex=man&name=Professional HT ...
- vmware 与Device/Credential Guard不兼容
解决办法 关闭hv 重启就完了
- 易语言调用外部DLL详细实例教程
一.准备工作 一.工具:易语言 二.准备一个DLL 1)打开易语言-新建一个Windows动态链接库 2)然后右键新建一个子程序或者用快捷键:Ctrl+N .然后写上代码.我这里写一个 2个字符串拼接 ...
- 为什么打不开IDEA或webStorm官方网页?
为什么打不开IDEA或webStorm官方网页? 一.问题描述 idea和webStorm的官网:https://www.jetbrains.com/ 有时候打开idea的官网会出现无法访问的情况,页 ...
- Oracle 优化效率
一.链接: ORACLE多表查询优化 oracle的 分表 详解 -----表分区 Oracle数据库查询优化方案(处理上百万级记录如何提高处理查询速度) 数据库SQL优化大总结之 百万级数据库优化方 ...
- js中的如何定位固定层的位置
需要获取一些HTML的对象的坐标来更灵活的设置目标层的坐标,这里可以通过用到document.body.scrollTop等属性,但是这些属性在xhtml的标准网页中或更简单的说就是带<!DOC ...
- JZOJ 5455 拆网线
Time Limits: 1000 ms Memory Limits: 65536 KB Detailed Limits Description 企鹅国的网吧们之间由网线互相连接,形成一棵树的结构.现 ...
- [Vue CLI 3] 配置解析之 indexPath
在 vue.config.js 配置中有一个 indexPath 的配置,我们先看看它有什么用? 用来指定 index.html 最终生成的路径(相对于 outputDir) 先看看它的默认值:在文件 ...
- 使用Redis管道提升性能
首发于 樊浩柏科学院 Redis 的 管道 (pipelining)是用来打包多条无关命令批量执行,以减少多个命令分别执行带来的网络交互时间.在一些批量操作数据的场景,使用管道可以显著提升 Redis ...
- 算法复杂度表示(大O表示法)
- 概念: 大O表示法:称一个函数g(n)是O(f(n)),当且仅当存在常数c>0和n0>=1,对一切n>n0均有|g(n)|<=c|f(n)|成立,也称函数g(n)以 ...
| |
