
Hadoop4-HDFS分布式文件系统原理
一、简介
1、分布式文件系统钢结构
分布式文件系统由计算机集群中的多个节点构成,这些节点分为两类:
主节点(MasterNode)或者名称节点(NameNode)
从节点(Slave Node)或者数据节点(DataNode)

2、HDFS能够带来什么好处
兼容廉价的硬件设备
流数据读写
大数据集
简单的文件模型
强大的跨平台兼容性
3、局限性
不适合低延迟数据访问
无法高效存储大量小文件
不支持多用户写入节任意修改文件
二、概念
1、块
HDFS默认一个块64MB,一个文件被分成多个块,以块为存储单位,2.x新版本中是128MB
块的大小远大于普通文件系统,可以最小化寻找开销
HDFS采用抽象的块概念可以带来一下几个明显的好处:
支持大规模文件存储:文件以块为单位进行存储,一个大规模文件可以被分拆成若干各文件块,不同文件块被分发到不同节点,因此,一个文件的大小不会受到单个节点存储容量限制,可以远大于网络中任意节点的存储容量
简化系统设计:简化了存储管理,因为文件块大小固定,这样可以非常容易算出一个几点可以存储多少块,其次方便了元数据的管理,元数不需要和文件块一起存储,可以由其他系统负载管理元数据
适合数据备份:每个文件块都可以冗余存储到多个节点上,提高了系统容错和可用性
2、名称节点
名称节点负责管理分布式文件系统的命令空间(Namespace),保存了两个核心的数据结构,即Fslmage和EditLog
Fslmage用于维护文件系统树以及文件树中所有的文件和文件夹的元数据
操作日志文件EditLog中记录了所有针对文件的创建、删除、重命名等操作
名称节点记录了每个文件中个板块所在的数据节点的位置信息

3、Fslmage文件
Fslmage文件包含文件系统中所有目录和文件inode的序列化形式,每个inode是一个文件或目录的元数据内部表示,并包含此类信息:文件的复制等级、修改和访问时间、访问权限、块大小以及组成文件的块。对于目录,则存储修改时间、权限和配额元数据
Fslmage文件没有记录块存储在哪个数据节点。而是由名称节点把这些映射保留在内存中,当数据节点加入HDFS集群时,数据节点会把自己所包含的块列表告知给名称节点,此后会定期执行这种告知操作,以确保名称节点的块映射时最新的
4、名称节点的启动过程
1)启动名称节点---》将FsImage文件---》加载到内存---》执行EditLog---》同步---》内存中的元数据客户可读
2)内存与元数据映射完成---》创建新的Fslmage文件+空的Editlog文件
说明:名称节点起来后,HDFS中的更新操作会重新写到Editlog文件中,因为Fslmage文件一般都很大(GB级别的很常见),如果所有的更新操作都往Fslmage文件中添加,这样会导致系统运行的十分缓慢,但是,如果往EditLog文件里面写就不会这样,因为EditLog要小很多,每次执行写操作之后,且在向客户端发送成功代码之前,edits文件都需要同步更新
5、名称节点运行期间EditLog不断变大的问题
运行期间HDFS的所有操作---》写到EditLog---》时间(久而久之)---》EditLog文件将变得非常大
对运行中HDFS影响不大,但是一旦重启Fslmage里面的所有内容映像到内存中,然后在一条一条执行EditLog,当EditLog文件非常大的时,就会导致名称节点启动非常缓慢,并且此期间是安全模式,无法提供写操作,影响用户使用
解决此问题就需要SecondaryNameNode第二名称节点
6、第二名称节点SecondaryNameNode
1)它用来保存名称节点中对HDFS元数据信息的备份,并减去名称节点重启的时间,一般是单独运行在一台机器上
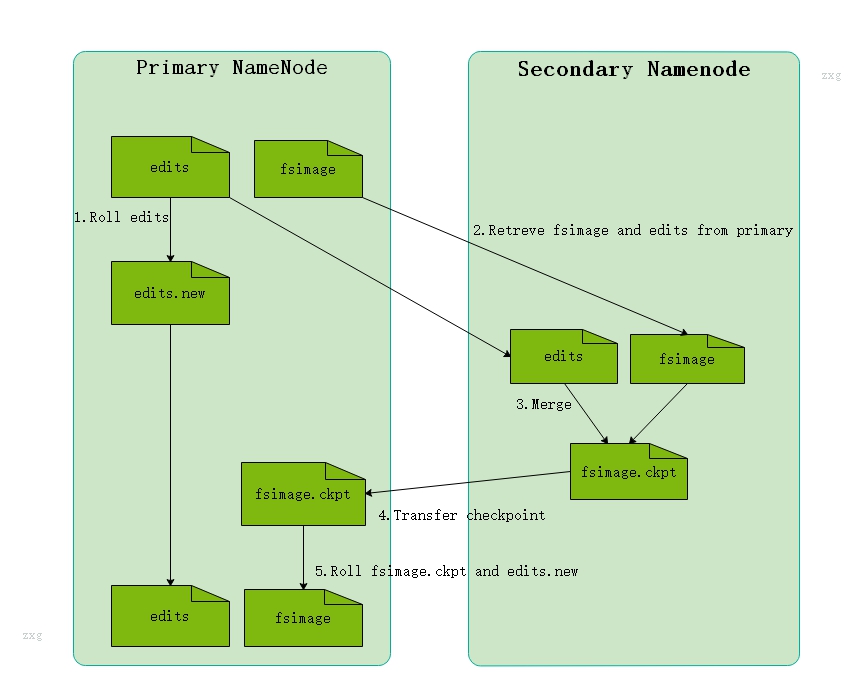
2)SecondaryNameNode工作情况
1、SecondaryNameNode定期于NameNode通信,请求停止使用EditLog文件,暂时将新的写操作写到要给新的文件edit.new,此操作瞬间完成,上层写日志函数感觉不到差别
2、SecondaryNameNode通过HTTP GEt从NameNode上获取FsImage/EditLog文件下载到本地的相应目录下
3、SecondaryNameNode将下载的Fslmage载入内存然后一条条执行EditLog中的操作,使得内存中的Fslmage保持最新,这个就是EditLog和FsImage文件合并
4、SecondaryNameNode执行完合并会通过post方式将新的FsImage文件发送到NameNode节点
5、NameNode将从SecondaryNameNode接收到的新的FsImage替换就的FsImage文件,同时将edit.new替换EditLog文件,这时EditLog就变小了
7、数据节点DataNode
数据分布在各节点,数据节点负责数据的存储和读取,会根据客户端或名称节点的调度进行数据的存储和检索,并且向名称节点定期发送所存储的块的列表
三、体系结构
HDFS采用了主从(M/S)结构模型,名称节点作为中心服务器,管理文件系统的命名空间即客户端文件的访问。数据节点负责进行客户端的读/写请求,在名称节点的调度吓进行数据的创建、删除、复制操作
1、命名空间
HDFS的命名空间包含目录、文件、块
HDFS使用传统的分级文件体系,因此,可以像使用普通文件系统一样,创建/删除目录和文件,及在目录间转移重命名等
2、通信协议
HDFS通信协议都是构建在TCP/IP协议基础之上
客户端通过一个可配置端口向名称节点发起tcp链接,并使用客户端协议与名称节点进行交互
名称节点和数据节点间使用数据节点协议进行交互
客户端与数据节点的交互是通过RPC(Remote Procedure Call)来实现的。在设计上,名称节点不会主动发起RPC,而是响应来自客户端和数据节点的RPC请求
3、客户端
客户端就是用户操作HDFS的方式,HDFS在部署时都提供了客户端
HDFS客户端时一个库,包括HDFS文件系接口,这些接口隐藏了HDFS实现中的大部分复杂性
严格来说客户端并不是HDFS的一部分
客户端支持打开、读写、写入等常见的操作,并且提供了类似shell的命令行方式来访问HDFS中的数据
HDFS也提供了Java API,作为应用程序访问文件系统的客户端编程接口
4、局限性
HDFS只设置了一个名称节点,这样做的好处时简化系统设计,但是也带了局限性:
1)命名空间的限制:名称节点时保持在内存中,因此名称节点能够容纳对象(文件、块)的个数会收到内存大小限制
2)性能瓶颈:整个分布式文件系统的吞吐量,受限单个名称节点的吞吐量
3)隔离问题:由于集群中只有一个名称节点,只有一个命名空间,因此,无法对不同应用程序进行隔离
4)集群的可用性:一旦唯一的名称节点发送故障,整个集群不可用
四、存储原理
1、冗余数据保存
HDFS采用了多副本方式对数据进行冗余,多副本方式优点:
1)加快数据传输速度
2)容易检查数据错误
3)保证数据可靠性

2、数据存取策略
1)数据存放
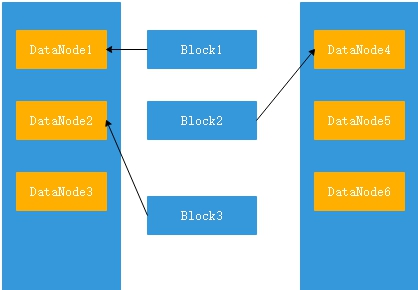
第一个副本:放在上传文件的数据节点,如果集群外提交,随机选一台磁盘不太满、cpu不太忙的节点
第二个副本:放置在与第一个副本不同的机架的节点上
第三个副本:与第一个副本相同机架的其他节点上
更多副本:随机
3、数据读写
hdfs提供了一个API可以确定一个数据节点所属的机架ID,客户端也可以调用API获取自己所属机架ID
当客户端读取数据时,名称节点获得数据块不同的位置列表,列表中包含了副本所在数据节点,发现某个数据数据库副本对应的机架ID和客户端对应机架ID相同,就优先选择该副本读取数据,如没有就随机读取
4、容错-数据错误与恢复
HDFS具有较高的容错性,可以兼容廉价硬件,它把依你高见出错看作一种常态,还有机制检测数据错误和自动恢复,容错性主要由名称节点出错、数据节点出错、数据出错。
1)名称节点出错
回顾:Fslmage,Editlog
如果整个两个文件损坏,那么HDFS实例将失效
hdfs提供SecondaryNameNode,将会备份这两个文件,在必要的时候Fslmage,Editlog数据进行恢复
2)数据节点出错
心跳信息定期向名称节点报告自己状态,如果出问题,就会被标记为宕机,节点上的数据被标记不可读,名称节点将不会给他们发送任何I/O请求
如出现问题,一些数据节点不可用可能会导致一些数据库副本数量小于冗余因子,名称节点会定期进行检测,一旦发生这种情况会启动数据冗余复制,为它生成新的副本
HDFS和其他分布式文件系统最大的区别就是可以调整冗余数据位置
3)数据出错
由网络磁盘等错误的因素都会导致数据错误,客户端读取到数据后都会进行md5/sha1对数据进行校验,以确定读取到正确的数据
在创建文件时,客户端会对每个文件进行信息摘录,并把这些信息写入到一个路径的隐藏文件
客户端读取文件时,先读取信息摘录,然后利用该信息进行校验,如果出错,客户端就会请求到另外的节点读取,并向名称节点报告,名称节点会定期检测并且重新复制
五、数据读取过程
1、读取文件

简单流程就是:打开文件--》获取数据块信息--》读取请求--》读取数据--》获取数据块信息--》读取数据--》关闭文件
2、写数据过程
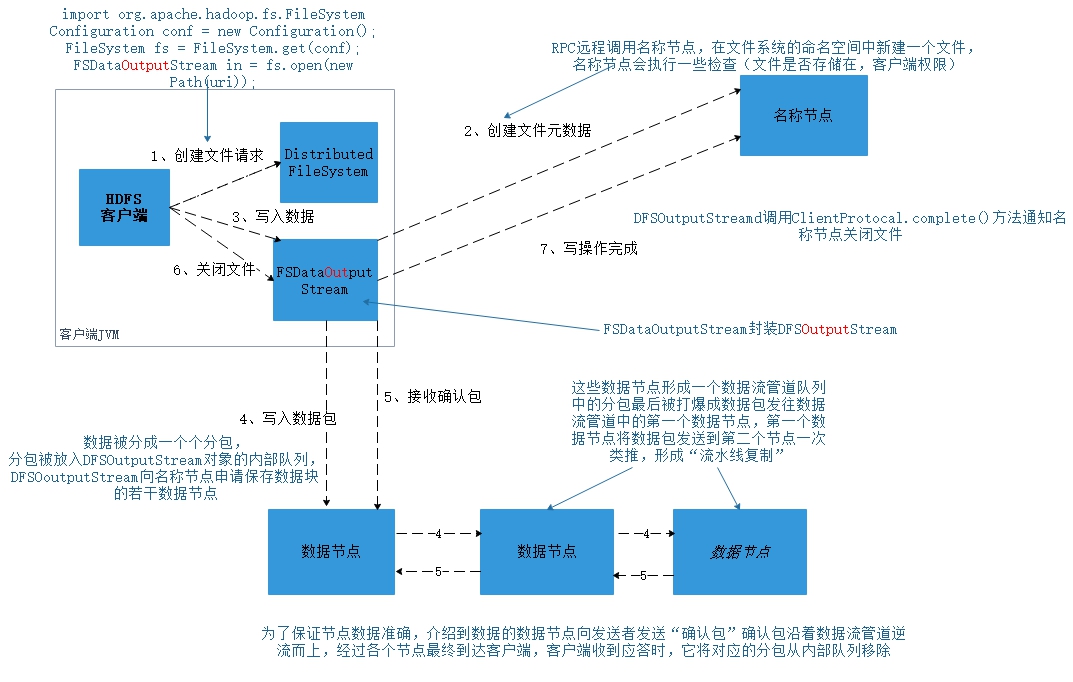
简单流程:创建文件--》创建文件元数据--》写入数据--》--》写入数据包--》接收确认包--》关闭文件--》写操作完成
完全参考学习:http://dblab.xmu.edu.cn/blog/290-2/
转载请注明出处:https://www.cnblogs.com/zhangxingeng/p/11819418.html
Hadoop4-HDFS分布式文件系统原理的更多相关文章
- 【史上最全】Hadoop 核心 - HDFS 分布式文件系统详解(上万字建议收藏)
1. HDFS概述 Hadoop 分布式系统框架中,首要的基础功能就是文件系统,在 Hadoop 中使用 FileSystem 这个抽象类来表示我们的文件系统,这个抽象类下面有很多子实现类,究竟使用哪 ...
- HDFS分布式文件系统资源管理器开发总结
HDFS,全称Hadoop分布式文件系统,作为Hadoop生态技术圈底层的关键技术之一,被设计成适合运行在通用硬件上的分布式文件系统.它和现有的分布式文件系统有很多共同点,但同时,它和其他的分布式 ...
- 通过Thrift访问HDFS分布式文件系统的性能瓶颈分析
通过Thrift访问HDFS分布式文件系统的性能瓶颈分析 引言 Hadoop提供的HDFS布式文件存储系统,提供了基于thrift的客户端访问支持,但是因为Thrift自身的访问特点,在高并发的访问情 ...
- Hadoop HDFS分布式文件系统 常用命令汇总
引言:我们维护hadoop系统的时候,必不可少需要对HDFS分布式文件系统做操作,例如拷贝一个文件/目录,查看HDFS文件系统目录下的内容,删除HDFS文件系统中的内容(文件/目录),还有HDFS管理 ...
- Hadoop基础-HDFS分布式文件系统的存储
Hadoop基础-HDFS分布式文件系统的存储 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HDFS数据块 1>.磁盘中的数据块 每个磁盘都有默认的数据块大小,这个磁盘 ...
- 认识HDFS分布式文件系统
1.设计基础目标 (1) 错误是常态,需要使用数据冗余 (2)流式数据访问.数据批量读而不是随机速写,不支持OLTP,hadoop擅长数据分析而不是事物处理. (3)文件采用一次性写多次读的模型, ...
- 1、HDFS分布式文件系统
1.HDFS分布式文件系统 分布式存储 分布式计算 2.hadoop hadoop含有四个模块,分别是 common. hdfs和yarn. common 公共模块. HDFS hadoop dist ...
- 我理解中的Hadoop HDFS分布式文件系统
一,什么是分布式文件系统,分布式文件系统能干什么 在学习一个文件系统时,首先我先想到的是,学习它能为我们提供什么样的服务,它的价值在哪里,为什么要去学它.以这样的方式去理解它之后在日后的深入学习中才能 ...
- 大数据基础总结---HDFS分布式文件系统
HDFS分布式文件系统 文件系统的基本概述 文件系统定义:文件系统是一种存储和组织计算机数据的方法,它使得对其访问和查找变得容易. 文件名:在文件系统中,文件名是用于定位存储位置. 元数据(Metad ...
- hdfs(分布式文件系统)优缺点
hdfs(分布式文件系统) 优点 支持超大文件 支持超大文件.超大文件在这里指的是几百M,几百GB,甚至几TB大小的文件.一般来说hadoop的文件系统会存储TB级别或者PB级别的数据.所以在企业的应 ...
随机推荐
- eclipse 的使用
eclipse 的官方下载:https://www.eclipse.org/downloads/ 安装时选择 :Eclipse IDE for Java EE Developers 设置: 1. 编 ...
- 2018 php 面试
排序算法 快速排序 快速排序是十分常用的高效率的算法,其思想是:先选一个标尺,用它把整个队列过一遍筛选,以保证左边的元素都不大于它,其右边都不小于它 function quickSort($arr){ ...
- python-犯傻合集
1.题目: 基于文件实现用户登录程序,提示用户输入用户名和密码,检查用户名是否存在,以及用户名密码是否正确 保存密码的文件叫user.txt,内容: | 作分隔符 阶段一: 自己第一次的答案: ...
- 【Java必修课】ArrayList与HashSet的contains方法性能比较(JMH性能测试)
1 简介 在日常开发中,ArrayList和HashSet都是Java中很常用的集合类. ArrayList是List接口最常用的实现类: HashSet则是保存唯一元素Set的实现. 本文主要对两者 ...
- Python开发【第七篇】列表
问题:当我们要用一系列数字的时候,我们需要将数字进行存储,我们就需要找个容器把数字装起来,我们需要用的时候再拿出来.如何将计算机运算的数据存储在一个地方,同时方便 对数据进行 增.删.改.查 列表 列 ...
- 关于JavaScript if...else & if 判断简写
<script type="text/javascript"> 如果你想写 if (!false){ alert('false'); } 不妨考虑写成: false | ...
- linux上安装newman
1. newman的安装依赖nodejs,首先安装node/npm 进入到 /usr/local目录[root@ipha-dev71- local]# cd /usr/local [root@ipha ...
- pycharm中常见错误提示
1.类中定义函方法 PyCharm 提示Method xxx may be 'static': 原因:该方法不涉及对该类属性的操作,编译器建议声明为@staticmethod
- python-json与字典的区别
1.字典的类型是字典dict,是一种数据结构:json的类型是字符串str,json是一种格式: 接口测试是传参数payload时有时候是传的字符串,应该将payload的类型改为json 这点要注 ...
- Mysql面试题及千万级数据查询优化
今天在说Mysql查询优化之前,我先说一个常见的面试题,并带着问题深入探讨研究.这样会让大家有更深入的理解. 一,Mysql数据库中一个表里有一千多万条数据,怎么快速的查出第900万条后的100条数据 ...