
[原创]python+beautifulsoup爬取整个网站的仓库列表与仓库详情
from bs4 import BeautifulSoup

import requests

import os

def getdepotdetailcontent(title,url):#爬取每个仓库列表的详情

    r=requests.get("https://www.50yc.com"+url).content

    soup = BeautifulSoup(r,"html.parser")

    result = soup.find(name='div',attrs={"class":"sm-content"})#返回元素集

    content = result.find_all("li")#返回元素集

    with open(os.getcwd()+"\\depot\\"+title+"\\depotdetail.txt","w") as f :

        for i in content:

            b = i.find("span").text

            br = i.find("div").text

            f .write(b.replace(" ","").replace("\n","")+br.replace(" ","")+"\n"+"****************************"+"\n")

        f.close()

def getdepot(page):#爬取仓库列表信息

    depotlisthtml = requests.get("https://www.50yc.com/xan"+page).content

    content = BeautifulSoup(depotlisthtml,"html.parser")

    tags = content.find_all(name="div",attrs={"class":"bg-hover"})

    for i in tags:

        y = i.find_all(name="img")#返回tag标签

        for m in y:

            if m["src"].startswith("http"):

                imgurl = m["src"]

        print(imgurl)

        title = i.strong.text

        depotdetailurl = i.a['href']

        # print(depotdetailurl)

        os.mkdir(os.getcwd()+'\\depot\\'+title+'\\')

        with open(os.getcwd()+'\\depot\\'+title+'\\'+"depot.jpg","wb") as d :

            d.write(requests.get(imgurl).content)

        with open(os.getcwd()+'\\depot\\'+title+'\\'+"depot.txt","w") as m:

            m.write(i.text.replace(" ",""))

            m.close()

        getdepotdetailcontent(title,depotdetailurl)

for i in range(1,26):#爬取每页的仓库列表与仓库详情

    getdepot("/page"+str(i))

    print("/page"+str(i))
爬取内容为:
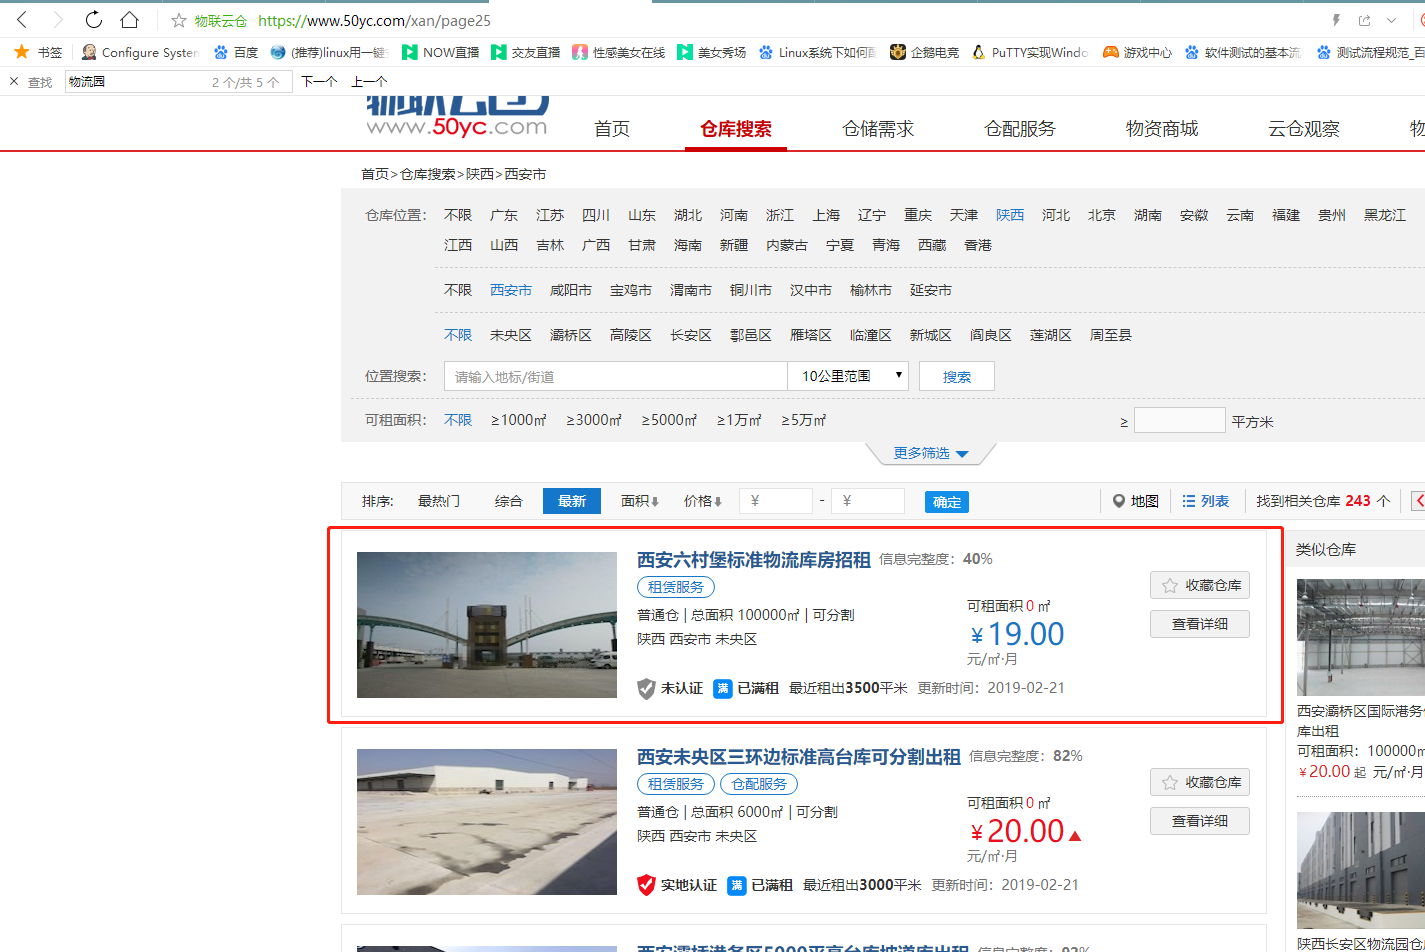
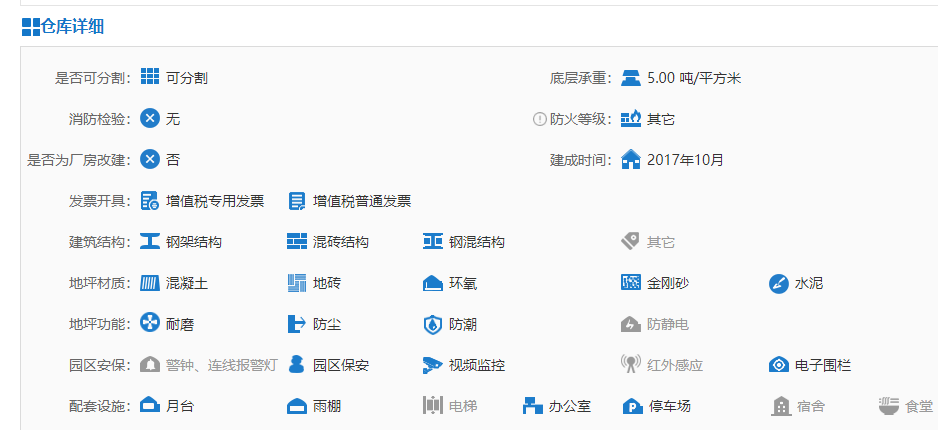
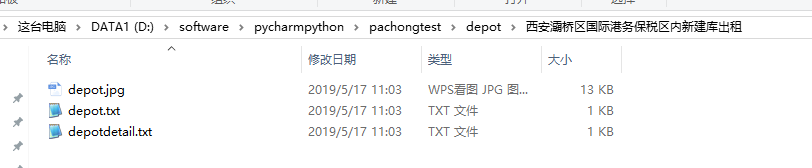
爬取结果如下:

[原创]python+beautifulsoup爬取整个网站的仓库列表与仓库详情的更多相关文章
- python爬虫--爬取某网站电影信息并写入mysql数据库
书接上文,前文最后提到将爬取的电影信息写入数据库,以方便查看,今天就具体实现. 首先还是上代码: # -*- coding:utf-8 -*- import requests import re im ...
- python爬虫--爬取某网站电影下载地址
前言:因为自己还是python世界的一名小学生,还有很多路要走,所以本文以目的为向导,达到目的即可,对于那些我自己都没弄懂的原理,不做去做过多解释,以免误人子弟,大家可以网上搜索. 友情提示:本代码用 ...
- Python爬虫学习之使用beautifulsoup爬取招聘网站信息
菜鸟一只,也是在尝试并学习和摸索爬虫相关知识. 1.首先分析要爬取页面结构.可以看到一列搜索的结果,现在需要得到每一个链接,然后才能爬取对应页面. 关键代码思路如下: html = getHtml(& ...
- Python多线程爬取某网站表情包
# 爬取网络图片import requestsfrom lxml import etreefrom urllib import requestfrom queue import Queue # 导入队 ...
- python 爬虫 爬取序列博客文章列表
python中写个爬虫真是太简单了 import urllib.request from pyquery import PyQuery as PQ # 根据URL获取内容并解码为UTF-8 def g ...
- Python 利用 BeautifulSoup 爬取网站获取新闻流
0. 引言 介绍下 Python 用 Beautiful Soup 周期性爬取 xxx 网站获取新闻流: 图 1 项目介绍 1. 开发环境 Python: 3.6.3 BeautifulSoup: ...
- 利用python的requests和BeautifulSoup库爬取小说网站内容
1. 什么是Requests? Requests是用Python语言编写的,基于urllib3来改写的,采用Apache2 Licensed 来源协议的HTTP库. 它比urllib更加方便,可以节约 ...
- python之简单爬取一个网站信息
requests库是一个简介且简单的处理HTTP请求的第三方库 get()是获取网页最常用的方式,其基本使用方式如下 使用requests库获取HTML页面并将其转换成字符串后,需要进一步解析HTML ...
- Python使用urllib,urllib3,requests库+beautifulsoup爬取网页
Python使用urllib/urllib3/requests库+beautifulsoup爬取网页 urllib urllib3 requests 笔者在爬取时遇到的问题 1.结果不全 2.'抓取失 ...
随机推荐
- Python高级特性之:List Comprehensions、Generator、Dictionary and set ...
今天帅气的易哥和大家分享的是Pyton的高级特性,希望大家能和我一起学习这门语言的魅力. Python高级特性之:List Comprehensions.Generator.Dictionary an ...
- lua 10 迭代器
转自:http://www.runoob.com/lua/lua-iterators.html 迭代器(iterator)是一种对象,它能够用来遍历标准模板库容器中的部分或全部元素,每个迭代器对象代表 ...
- 《HBase在滴滴出行的应用场景和最佳实践》
HBase在滴滴出行的应用场景和最佳实践 背景 对接业务类型 HBase是建立在Hadoop生态之上的Database,源生对离线任务支持友好,又因为LSM树是一个优秀的高吞吐数据库结构,所以同时 ...
- mysql数据库的创建问题
数据库客户端工具navicate 1.使用create database语句创建数据库 (1)指定字符集 create [database|schema ]if not exists 数据库名 def ...
- <String> 186 293 294 249
186. Reverse Words in a String II 先反转整个字符串,再反转每个单词(调整顺序也可以) 反转单词的时候:当 j 指到最后一个字符的时候,或者 j 的下一个指向空格,则反 ...
- ulimit 用法和系统优化
ulimit :用于shell启动进程所占用的资源 -a:显示目前资源限制的设定: -c <core文件上限>:设定core文件的最大值,单位为区块: -d <数据节区大小>: ...
- [算法模版]Prim-完全图最小生成树
[算法模版]Prim-完全图最小生成树 众所周知,对于常用的Kruskal算法,算法复杂度为\(O(m \log m)\).这在大多数场景下已经够用了.但是如果遇到及其稠密的完全图,Prim算法就能更 ...
- DWR日志 在log4j.xml配置
一.日志 DWR依赖 Apache Commons Logging,可以使用log4j实现日志记录功能. 1.1 日志简介 和其他日志框架一样,当设置低等级的日志时所有高于此等级的日志也将会打印出来. ...
- resharper 8.2
用户名:ronle注册码:ZoJzmeVBoAv9Sskw76emgksMMFiLn4NM
- javascript 写一个 map方法
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8&quo ...