
Kafka学习笔记(5)----Kafka的Consumer
1. Pull vs Push
Producer主动的通过push将消息发布到Broker上,Consumer通过Pull的的方式从Broker消息消息。
通过Push的方式由于是一有消息就推到Broker,所以极大的保证了消息实时性,但是在某些情况下,可能由于Consumer网络,或是其他原因倒是消费速度低,此时就可能会导致Consumer堆积大量的消息,甚至在极端情况下会压垮Consumer.
通过Pull拉取消息保证了Consumer能够按自己实际处理能力来拉取相应的消息,并且Broker的实现也相对简单,但是也会出现在消息处理能力很低的情况下造成消息的实时性过低。
kafka提供了High Level Consumer和High Level Consume两种方式的API。
2. High Level Consumer
很多应用场景下,客户程序只是希望从Kafka顺序读取并处理数据,而不太关心具体的offset。它同时也希望提供一些语义,例如同一条消息只被某一个Consumer消费(单播)或被所有Consumer消费(广播),Kafka High Level API提供了一个从Kafka消费数据的高层抽象,从而屏蔽掉其中的细节,并提供丰富的语义。
在Kafka中,High Level Consumer将从某个Partition读取的最后一条消息的offset存于Zookeeper中(从0.8.2开始同时支持将offset存于Zookeeper中和专用的Kafka Topic中)。这个offset基于客户程序提供给Kafka的名字来保存,这个名字被称为Consumer Group,Consumer Group是整个Kafka集群全局唯一的,而非针对某个Topic的。每个High Level Consumer实例都属于一Consumer Group,若不指定则属于默认的Group。在消息被消费之后,消息并不会立即被删除,只是相应的offset加一,若以可能Consumer中的offset将会跟消息的数据一样多,
在High Level Consumer下由于存在了关联关系(Group ),所以消息删除也将不再是到一定时间或消息条数达到某个值就删除,而是通过压缩的方式,保留最新的key的value的方式。具体示例如下:
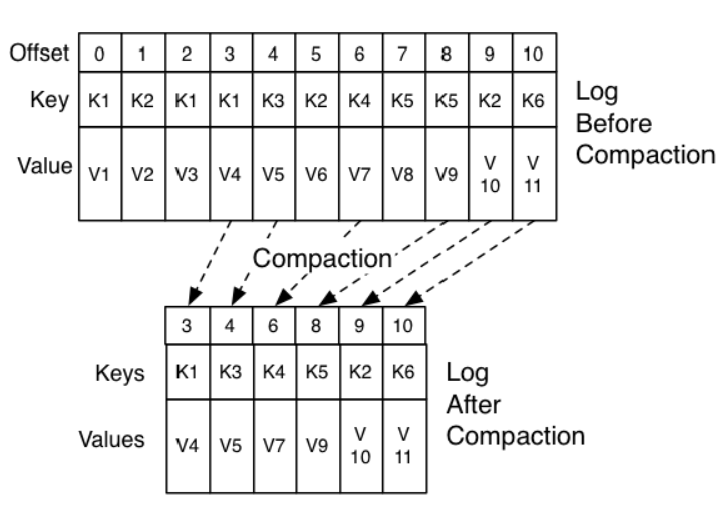
这样就保证了消息与offset之间仍然是正确的对应关系。
对于每条消息,在同一个Consumer Gourp里都只会被一个Consumer消费,不同的Cosumer Group可以消费同一条消息。
如下:
Kafka的设计理念之一就是同时提供对离线批处理和在线流处理的支持。可以同时使用Hadoop系统进行离线批处理,Storm或它流处理系统进行流处理。也可使用Kafka的Mirror Maker将消息从一个数据中心镜像到另一个数据中心。
如图:

Consumer的Rebalance(平衡策略)
High Level Consumer启动时将其ID注册到其Consumer Group下,在Zookeeper上的路径为/consumers/[consumer group]/ids/[consumer id],在/consumers/[consumer group]/ids上注册Watch,在/brokers/ids上注册Watch,如果Consumer通过Topic Filter创建消息流,则它会同时在/brokers/topics上也创建Watch,强制自己在其Consumer Group内启动Rebalance流程
Rebalance算法
1. 将目标Topic下的所有Partirtion排序,存于PT
2. 对某Consumer Group下所有Consumer排序,存于CG,第i个Consumer记为Ci
3. N=size(PT)/size(CG) ,向上取整
4. 解除Ci对原来分配的Partition的消费权(i从0开始)
5. 将第i∗N 到(i+1)∗N−1个Partition分配给Ci
Rebalance算法也存在如下缺点:
1. Herd Effect: 任何Broker或者Consumer的增减都会触发所有的Consumer的Rebalance
2. Split Brain: 每个Consumer分别单独通过Zookeeper判断哪些Broker和Consumer宕机,同时Consumer在同一时刻从Zookeeper“看”到的View可能不完全一样,这是由Zookeeper的特性决定的。
3. 调整结果不可控所有Consumer分别进行Rebalance,彼此不知道对应的Rebalance是否成功
3. Low Level Consumer
使用Low Level Consumer (Simple Consumer)的主要原因是,用户希望比Consumer Group更好的控制数据的消费,如:
1. 同一条消息读多次,方便Replay
2. 只消费某个Topic的部分Partition
3. 管理事务,从而确保每条消息被处理一次(Exactly once)
与High Level Consumer相对,Low Level Consumer要求用户做大量的额外工作
1. 在应用程序中跟踪处理offset,并决定下一条消费哪条消息
2. 获知每个Partition的Leader
3. 处理Leader的变化
5. 处理多Consumer的协作
Kafka学习笔记(5)----Kafka的Consumer的更多相关文章
- Kafka学习笔记之Kafka Consumer设计解析
0x00 摘要 本文主要介绍了Kafka High Level Consumer,Consumer Group,Consumer Rebalance,Low Level Consumer实现的语义,以 ...
- Kafka学习笔记之Kafka三款监控工具
0x00 概述 在之前的博客中,介绍了Kafka Web Console这 个监控工具,在生产环境中使用,运行一段时间后,发现该工具会和Kafka生产者.消费者.ZooKeeper建立大量连接,从而导 ...
- Kafka学习笔记之Kafka性能测试方法及Benchmark报告
0x00 概述 本文主要介绍了如何利用Kafka自带的性能测试脚本及Kafka Manager测试Kafka的性能,以及如何使用Kafka Manager监控Kafka的工作状态,最后给出了Kafka ...
- Kafka学习笔记之Kafka背景及架构介绍
0x00 概述 本文介绍了Kafka的创建背景,设计目标,使用消息系统的优势以及目前流行的消息系统对比.并介绍了Kafka的架构,Producer消息路由,Consumer Group以及由其实现的不 ...
- Kafka 学习笔记之 High Level Consumer相关参数
High Level Consumer相关参数 自动管理offset auto.commit.enable = true auto.commit.interval.ms = 60*1000 手动管理o ...
- Kafka学习笔记之Kafka High Availability(下)
0x00 摘要 本文在上篇文章基础上,更加深入讲解了Kafka的HA机制,主要阐述了HA相关各种场景,如Broker failover,Controller failover,Topic创建/删除,B ...
- Kafka学习笔记之Kafka High Availability(上)
0x00 摘要 Kafka在0.8以前的版本中,并不提供High Availablity机制,一旦一个或多个Broker宕机,则宕机期间其上所有Partition都无法继续提供服务.若该Broker永 ...
- Kafka学习笔记1——Kafka的安装和启动
一.准备工作 1. 安装JDK 可以用命令 java -version 查看版本
- Kafka学习笔记之Kafka自身操作日志的清理方法(非Topic数据)
0x00 概述 本文主要讲Kafka自身操作日志的清理方法(非Topic数据),Topic数据自己有对应的删除策略,请看这里. Kafka长时间运行过程中,在kafka/logs目录下产生了大量的ka ...
- Kafka学习笔记之Kafka日志删出策略
0x00 概述 kafka将topic分成不同的partitions,每个partition的日志分成不同的segments,最后以segment为单位将陈旧的日志从文件系统删除. 假设kafka的在 ...
随机推荐
- 洛谷P1616 疯狂的采药【完全背包】
题目描述 LiYuxiang是个天资聪颖的孩子,他的梦想是成为世界上最伟大的医师.为此,他想拜附近最有威望的医师为师.医师为了判断他的资质,给他出了一个难题.医师把他带到一个到处都是草药的山洞里对他说 ...
- CSS定位相关
CSS display:inline和float:left两者区别 ①display:inline:任何不是块级元素的可见元素都是内联元素.其表现的特性是“行布局”形式!(行布局:其表现形式始终以行进 ...
- 数位dp题集
题集见大佬博客 不要62 入门题,检验刚才自己有没有看懂 注意一些细节. 的确挺套路的 #include<bits/stdc++.h> #define REP(i, a, b) for(r ...
- 重命名文件及html
import os import nltk from bs4 import BeautifulSoup as bs def get_txt_name_from_bak_name(bak_name): ...
- States of Integrity Constraints
States of Integrity Constraints As part of constraint definition, you can specify how and when Oracl ...
- LightOJ - 1189 - Sum of Factorials
先上题目 Sum of Factorials Time Limit:500MS Memory Limit:32768KB 64bit IO Format:%lld & %llu ...
- 格式化LInux后开机进入grub怎么办
问题:格式化Linux系统盘之后,重启进入grub 1.grub 引导进入windows系统 进入grub grub>rootnoverify (hd0,1) [可以使用Tab键( 比如 roo ...
- POJ 2019 Cornfields 二维线段树的初始化与最值查询
模板到不行.. 连更新都没有.. .存个模板. 理解留到小结的时候再写. #include <algorithm> #include <iostream> #include & ...
- Ubuntu下启动Eclipse报错:A Java RunTime Environment (JRE) or Java Development Kit (JDK) must
原以为是jdk的环境变量配置错误了,于是从网上找了各种配置环境变量的方法.也注意空格的问题,可无论怎么改,还是这样报错!后来在网上看到一种奇怪的方法.我也不知道为什么这样就OK了? 方法:进入你的ec ...
- Java读源代码学设计模式:适配器Adapter
适配器模式相关源代码:slf4j-1.6.1.hibernate-3.6.7 大家都知道.log4j是一个广泛使用的日志工具,除此之外.sun公司在JDK中也有自己的日志工具,也就是java.util ...