
【译】Apache Kafka支持单集群20万分区
之前网上关于确定Kafka分区数的博客多多少少都源自于饶军大神的文章,如今他带来了这方面的第二篇文章,特此翻译一下,记录一下其中的要点。
原贴地址: https://www.confluent.io/blog/apache-kafka-supports-200k-partitions-per-cluster
Kafka中topic可以设置多个分区,而分区是最小的并行度单位。通常而言,分区数越多吞吐量也越高。但是依然有很多因素制约了一个Kafka集群所能支持的最大分区数。我现在高兴地宣布Kafka 1.1.0版本在这方面取得了重大的改进。目前生产环境中单Kafka集群支持的分区上限得到了极大的提升。
为了便于理解这个改进是如何实现的,我们重温一下分区leader和controller的基本概念。首先,每个分区都可以配置多个副本用于实现高可用性以及持久性。其中的一个副本被指定为leader而所有client只与leader进行交互;其次,cluster中的某个broker被指定为controller来管理整个集群。若broker挂掉,controller负责为该broker上所有分区选举leader。
默认情况下关闭Kafka broker执行的是一个受控关闭操作(下称controlled shutdown)。Controlled shutdown对client的影响是最小的。一个典型的controlled shutdown分为以下几步:1. 发送SIGTERM信号给待关闭的broker;2. Broker发送请求给controller表明自己要正常关闭;3. Controller变更该broker上所有分区的leader并将这部分数据保存回Zookeeper;4. Controller发送新的leader信息给其他broker;5. Controller发送响应给关闭中的broker表明操作成功,于是broker成功关闭。此时,client端不受任何影响因为新leader已经转移到其他broker上。下面的两张图描述了这个过程,注意到图中(4)和(5)步是可以并行执行的:


上图中步骤(1)发起broker关闭;步骤(2)发送controlled shutdown请求给controller;步骤(3)中controller写入新leader到Zookeeper;步骤(4)controller发送新leader信息到其他broker;步骤(5)controller发送成功信息给关闭中的broker
在Kafka 1.1.0之前,一旦发起controlled shutdown,controller每次只能为一个分区选举leader。对于每个分区而言,controller顺序执行:选择新leader、同步写leader信息回Zookeeper以及同步leader信息给其他broker等操作。这种设计是低效率的:首先,同步写入Zookeeper就有很高的延时,从而整体拖慢controller shudown时间;其次,每次处理一个分区的做法导致需要给其他broker发送很多次请求,即使这些请求本身携带的数据量是很小的,从而最终导致对新leader的处理时间被极大地拉长。
Kafka 1.1.0为controlled shutdown引入了多个方面的性能提升。第一个提升就是使用异步API来替代了之前的同步写入Zookeeper。在controlled shutdown过程中,Kafka不再是每次写入一个leader信息,等待其完成然后再写入下一个。相反地,controller使用异步API一次性地提交多个分区的leader到Zookeeper上,然后统一等待其执行完毕。这就等于在Kafka与Zookeeper之间构建了一种管道式请求处理流程,从而减少了整体的延时。第二个提升则是将于新leader的交互操作批量化。与其每次为一个分区发送RPC请求,controller使用单个RPC请求一次性地携带所有受影响分区的leader信息。
同时,Kafka对于controller failover的时间也做了优化。当controller挂掉后,Kafka集群自动检测controller失败并选择其他broker作为新的controller。在开启controller工作之前,新选出的controller必须要从Zookeeper中加载所有分区的状态信息到内存中。如果controller直接崩溃的话,分区不可用的时间窗口将等同于Zookeeper会话超时时间加上controller状态加载时间,所以降低加载时间能够有效地帮助我们改善Kafka可用性。在1.1.0之前,加载操作使用的也是同步Zookeeper API。在1.1.0中被替换成了异步API。
社区对controlled shutdown时间和加载时间都做了测试。每个测试都使用了5节点Zookeeper的集群。在测试controlled shutdown时,社区搭建了一个5节点broker的Kafka集群并为该集群创建了25000个单分区的topic,每个topic都是双副本,故每个broker上平均有10000个分区。之后测试controlled shutdown,测试结果如下:
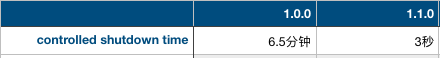
提升的很大一部分来自于修复了打日志(logging)的开销:之前在每个分区leader变更时都会记录集群中所有分区的数据——这实际上是没必要的。通过修复了这个logging的bug,controller shutdown从6.5分钟被压缩到30秒,而采用异步API更进一步地将其拉低到3秒。这些提升都极大地缩短了Kafka集群重启恢复的时间。
在第二项测试中,社区同样搭建了一个5节点集群,只不过这次创建了2000个配置有50分区的topic,单副本——故总数是1000000个分区。当测试controller状态加载时间时发现比1.0.0有了100%的提升(1.0.0耗时28秒,1.1.0耗时14秒)。
有了这些提升,Kafka单集群能够支持多少分区呢?确切的数字自然依赖于诸如可容忍的不可用窗口时间、Zookeeper延时、broker存储类型等因素。根据经验法则我们评估单台broker能够支撑的分区数可达4000个,而单集群能够支撑200000个分区。当然后者主要受限于集群对controller崩溃这种不常见情形的容忍度,另外其他影响分区数的因素也要考虑进来。
1.1.0所做的改进仅仅是提升Kafka高扩展性的一小步。事实上社区在1.1.0版本还尝试了更多的分区并改进了它们的延时表现。后面可能会在另一篇文章中给出具体的说明。在未来,Kafka社区计划实现单集群支撑百万级分区的构想,所以,敬请期待~~
【译】Apache Kafka支持单集群20万分区的更多相关文章
- Kafka支持单集群20万分区
Kafka支持单集群20万分区 之前网上关于确定Kafka分区数的博客多多少少都源自于饶军大神的文章,如今他带来了这方面的第二篇文章,特此翻译一下,记录一下其中的要点. 原贴地址: https://w ...
- [转帖]单集群10万节点 走进腾讯云分布式调度系统VStation
单集群10万节点 走进腾讯云分布式调度系统VStation https://www.sohu.com/a/227223696_355140 2018-04-04 08:18 云计算并非无中生有的概念, ...
- 【译】Kafka学习之路
一直在思考写一些什么东西作为2017年开篇博客.突然看到一篇<Kafka学习之路>的博文,觉得十分应景,于是决定搬来这“他山之石”.虽然对于Kafka博客我一向坚持原创,不过这篇来自Con ...
- Apache Kafka是数据库吗?
最近思路有些枯竭,找些务虚的话题来凑.本文内容完全来自于Martin Kelppmann在2019年Kafka伦敦峰会上的演讲.顺便提一句,Kelppmann是<Designing Data-I ...
- 【译】调优Apache Kafka集群
今天带来一篇译文“调优Apache Kafka集群”,里面有一些观点并无太多新颖之处,但总结得还算详细.该文从四个不同的目标出发给出了各自不同的参数配置,值得大家一读~ 原文地址请参考:https:/ ...
- 大规模使用 Apache Kafka 的20个最佳实践
必读 | 大规模使用 Apache Kafka 的20个最佳实践 配图来源:书籍<深入理解Kafka> Apache Kafka是一款流行的分布式数据流平台,它已经广泛地被诸如New Re ...
- 使用Scala开发Apache Kafka的TOP 20大好用实践
本文作者是一位软件工程师,他对20位开发人员和数据科学家使用Apache Kafka的方式进行了最大限度得深入研究,最终将生产实践环节需要注意的问题总结为本文所列的20条建议. Apache Kafk ...
- [转帖]“腾百万”之后,腾讯的云操作系统VStation单集群调度达10万台
“腾百万”之后,腾讯的云操作系统VStation单集群调度达10万台 https://www.leiphone.com/news/201909/4BsKCJtvvUCEb66c.html 腾讯有超过1 ...
- Apache Kafka 集群部署指南
公众号关注 「开源Linux」 回复「学习」,有我为您特别筛选的学习资料~ Kafka基础 消息系统的作用 应该大部分小伙伴都清楚,用机油装箱举个例子. 所以消息系统就是如上图我们所说的仓库,能在中间 ...
随机推荐
- 点击时出现某个样式,1s后移除该样式的案例效果
这里为了使效果更好的让用户体现出来,点击时添加的样式为background:yellow;1后移除该样式: 案例demo为: <!DOCTYPE html> <html lang=& ...
- Python 之 __new__() 方法与实例化(转)
_new__() 是在新式类中新出现的方法,它作用在构造方法建造实例之前,可以这么理解,在 Python 中存在于类里面的构造方法 __init__() 负责将类的实例化,而在 __init__() ...
- Linux进程管理学习资料
下面是一些Linux进程管理相关的资料. 博客 Process Creation(一) Process Creation(二) 进程切换分析(1):基本框架 进程切换分析(2):TLB处理 When ...
- 基于SOUI开发一个简单的小工具
基于DriectUI有很多库,比如 Duilib (免费) soui (免费) DuiVision (免费) 炫彩 (界面库免费,UI设计器付费,不提供源码) skinui (免费使用,但不开放源码, ...
- Docker 安装和基础用法
理解Docker(1):Docker 安装和基础用法 本系列文章将介绍Docker的有关知识: (1)Docker 安装及基本用法 (2)Docker 镜像 (3)Docker 容器的隔离性 - 使用 ...
- 洛谷P1048 采药
题目OJ地址 https://www.luogu.org/problemnew/show/P1048 https://vijos.org/p/1104 题目描述辰辰是个天资聪颖的孩子,他的梦想是成为世 ...
- simHash 简介以及 java 实现
传统的 hash 算法只负责将原始内容尽量均匀随机地映射为一个签名值,原理上相当于伪随机数产生算法.产生的两个签名,如果相等,说明原始内容在一定概 率 下是相等的:如果不相等,除了说明原始内容不相等外 ...
- [转]Anatomy of a Program in Memory
Memory management is the heart of operating systems; it is crucial for both programming and system a ...
- Atitit 关于共享经济之共享男女朋友的创业计划
Atitit 关于共享经济之共享男女朋友的创业计划 1. 共享经济的历史与趋势 1 1.1. 共享经济三大特征=产能过剩+共享平台+人人参与. 1 1.2. 共享经济是个大趋势,使用权渐渐的取代所有权 ...
- vivado和modelsim联合调试仿真
vivado和modelsim联合调试仿真 0赞 发表于 2017/5/10 19:10:59 阅读(881) 评论(0) 使用vivado和modelsim联合调试仿真时,在破解完modelsim后 ...