
kafka笔记3(生产者)

创建Kafka生产者:
Kafka生产者有3个必选属性:
bootstrap.servers broker地址清单,格式为host:port ,清单中不必包含所有broker,但至少2个
key.serializer = org.apache.kafka.common.serialization.Serializer 接口类,生产者使用这个类把键对象序列化为字节数组
Kafka还提供了ByteArraySerializer,StringSerializer,IntegerSerializer 实现类
value.serializer 与key.serializer可以将值序列化
发送消息有3种方式:
发送并忘记(fire-and-forget) 发送消息给服务器,但是不关心是否正常到达
同步发送 使用send()发送信息,返回一个future对象,调用get()方法进行等待,了解信息是否正常发送
异步发送 调用send()函数,并指定一个回调函数,服务器在返回响应时调用该函数
生产者的可选属性:
acks 指定有多少个分区副本收到消息,生产者才会认为消息写入是成功的
ack=0 生产者在成功写入消息之前不会等待任何来自服务器的响应
ack=1 只要集群的首领节点收到信息,生产者就会收到一个来自服务器的成功响应
ack=all 所有参数与复制的节点全部收到消息,生产者才会收到一个来自服务器的响应,这种模式最安全
buffer.memory 设置生产者内存缓冲区大小,生产者使用它缓冲要发送到服务器的消息
compression.type 默认消息发送不使用压缩,该参数可以设置为snappy,gzip,lz4
retries 生产者可以重发消息的次数,默认 每次重试之间等待100ms,可以使用参数 retry.backoff.ms参数改变这个时间间隔
batch.size 指定一个批次可以使用的内存大小,按照字节数计算
linger.ms 指定生产者在发送批次之前等待更多消息加入批次的时间。Kafkaproducer 会在批次填满或linger.ms达到上限时把批次发送出去
client.id 该参数可以指定任意的字符串,服务器会用它识别信息的来源,还可以用在日志和配额指标里
max.in.flight.requests.per.connection 指定生产者在收到服务器响应之前可以发送多少个消息,值越高越占用内存;设为1可以保证消息是按照发送顺序写入服务器的
timeout.ms reuqest.timeout.ms metadata.fetch.timeout.ms
request.timeout.ms 指定生产者在发送数据时等待服务器返回响应的时间
metadata.timeout.ms 指定生产者在获取元数据时等待服务器返回响应时间
tiemout.ms指定broker等待同步副本返回消息确认的时间,与acks的配置相匹配
max.block.ms 指定调用send()或partitionsFor()方法获取元数据时生产者的阻塞时间,当阻塞时间到达max.block.ms时,生产者会抛出异常
max.request.size 控制生产者发送的请求大小,指能发送的单个消息的最大值或单个请求里所有消息的总和
broker对可接收的消息最大值也有自己的限制(message.max.bytes),两边配置最好匹配,避免生产者发送消息被拒绝
receive.buffer.bytes 和 send.buffer.bytes
这2个参数分别指定了TCP socket接收和发送数据包缓冲区大小,默认-1
max.in.flight.requests.per.connection=1 保证了消息的顺序,如果大于1,第一批次写入失败后,重试成功可能会改变消息的顺序
序列化器:
自定义序列化器
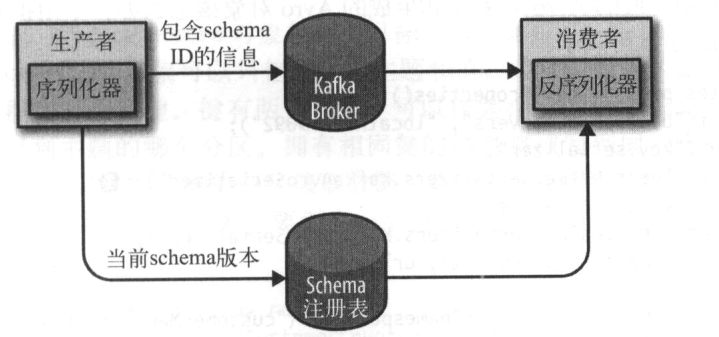
Avro序列化
Kafka使用Avro序列器是通过schema注册表来实现的,schema注册表不属于Kafka
kafka笔记3(生产者)的更多相关文章
- Kafka笔记整理(一)
Kafka简介 消息队列(Message Queue) 消息 Message 网络中的两台计算机或者两个通讯设备之间传递的数据.例如说:文本.音乐.视频等内容. 队列 Queue 一种特殊的线性表(数 ...
- Kafka笔记整理(三):消费形式验证与性能测试
Kafka消费形式验证 前面的<Kafka笔记整理(一)>中有提到消费者的消费形式,说明如下: .每个consumer属于一个consumer group,可以指定组id.group.id ...
- kafka笔记——入门介绍
中文文档 目录 kafka的优势 首先几个概念 kafka的四大核心API kafka的基本术语 主题和日志(Topic和Log) 每个分区都是一个顺序的,不可变的队列,并且可以持续的添加,分区中的每 ...
- 《Kafka笔记》3、Kafka高级API
目录 1 Kafka高级API特性 1.1 Offset的自动控制 1.1.1 消费者offset初始策略 1.1.2 消费者offset自动提交策略 1.2 Acks & Retries(应 ...
- kafka学习笔记2:生产者
这次的笔记主要记录一下kafka的生产者的使用和一些重要的参数. 文中主要截图均来自kafka权威指南 主要涉及到两个类KafkaProducer和ProducerRecord. 总览 生产者的主要架 ...
- Kafka笔记—可靠性、幂等性和事务
这几天很忙,但是我现在给我的要求是一周至少要出一篇文章,所以先拿这篇笔记来做开胃菜,源码分析估计明后两天应该能写一篇.给自己加油~,即使没什么人看. 可靠性 如何保证消息不丢失 Kafka只对&quo ...
- Kafka笔记--使用ubuntu为bocker(服务器)windows做producer和comsumer(客户端)
原文连接:http://www.cnblogs.com/davidwang456/p/4201875.html 程序仍然使用之前的一篇博文中的例子 :http://www.cnblogs.com/gn ...
- Kafka笔记--参数说明及Demo
参考资料:http://blog.csdn.net/honglei915/article/details/37563647参数说明:http://ju.outofmemory.cn/entry/119 ...
- kafka 幂等生产者及事务(kafka0.11之后版本新特性)
1. 幂等性设计1.1 引入目的生产者重复生产消息.生产者进行retry会产生重试时,会重复产生消息.有了幂等性之后,在进行retry重试时,只会生成一个消息. 1.2 幂等性实现1.2.1 PID ...
随机推荐
- SpringMvc的Url映射和传参案例(转)
Springmvc的基本使用,包括url映射.参数映射.页面跳转.ajax和文件上传 以前学习的时候写的代码案例,今天整理笔记的时候找到了,很久没有来园子了,发上来当个在线笔记用吧,免的时间长了又忘了 ...
- 大数据:Parquet文件存储格式
一.Parquet的组成 Parquet仅仅是一种存储格式,它是语言.平台无关的,并且不需要和任何一种数据处理框架绑定,目前能够和Parquet适配的组件包括下面这些,可以看出基本上通常使用的查询引擎 ...
- 搭建Airflow数据流调度器
服务器使用的是centos系统,需要安装好pip和setuptools,同时注意更新安装的版本 接下来参考安装好Airflow Airflow 1.8 工作流平台搭建 http://blog.csdn ...
- Maven-设置默认Java编译版本
有两种方式,一种针对项目,一种针对全局 针对项目,需要在pom.xml中添加如下配置: <build> <plugins> <plugin> <groupId ...
- idea hibernate反转pojo实体类和映射文件
- C# SQLite数据库
在客户端配置文件<configuration>节点下,添加: <connectionStrings> <add name="localdb" conn ...
- elasticsearch 6.1.1 transport jar
https://files.cnblogs.com/files/xjyggd/transport6.1.1.rar
- 解决vscode更新后Ext Js插件无法使用问题
解决方案来至于https://www.sencha.com/forum/showthread.php?471410-Bug-in-VS-Code-Plugin-since-VS-Code-Update ...
- gitlab服务器IP调整后修改domian或ip
背景 本地搭建的gitlab 服务器,在 /etc/gitlab/gitlab.rb 中 external_url 通常是局域网ip的形式.如下所示 external_url 'http://192. ...
- Timeline Storyteller 现已加入自定义图表库
前言 下载地址: https://store.office.com/en-us/app.aspx?assetid=WA104381136&sourcecorrid=328f5e2b-e973- ...