
数据采集与融合第四次作业:多线程以及scrapy框架的使用
数据采集第四次作业:多线程以及scrapy框架的使用
任务一:单多线程的使用
单线程代码:
from bs4 import BeautifulSoup

from bs4 import UnicodeDammit

import urllib.request

def imageSpider(start_url):

    try:

        urls = []

        req = urllib.request.Request(start_url, headers=headers)

        data = urllib.request.urlopen(req)

        data = data.read()

        dammit = UnicodeDammit(data, ["utf-8", "gbk"])

        data = dammit.unicode_markup

        soup = BeautifulSoup(data, "lxml")

        images = soup.select("img")

        for image in images:

            try:

                src = image["src"]

                url = urllib.request.urljoin(start_url, src)

                if url not in urls:

                    urls.append(url)

                    print(url)

                    download(url)

            except Exception as err:

                print(err)

    except Exception as err: print(err)

def download(url):

    global count

    try:

        count = count + 1

        # 提取文件后缀扩展名

        if (url[len(url) - 4] == "."):

            ext = url[len(url) - 4:]

        else:

            ext = ""

        req = urllib.request.Request(url, headers=headers)

        data = urllib.request.urlopen(req, timeout=100)

        data = data.read()

        fobj = open("images\\" + str(count) + ext, "wb")

        fobj.write(data)

        fobj.close()

        print("downloaded " + str(count) + ext)

    except Exception as err:

        print(err)

start_url="http://www.weather.com.cn/weather/101280601.shtml"

headers = {

"User-Agent": "Mozilla/5.0 (Windows; U; Windows NT 6.0 x64; en-US; rv:1.9pre) Gecko/2008072421 Minefield/3.0.2pre"}

count=0

imageSpider(start_url)
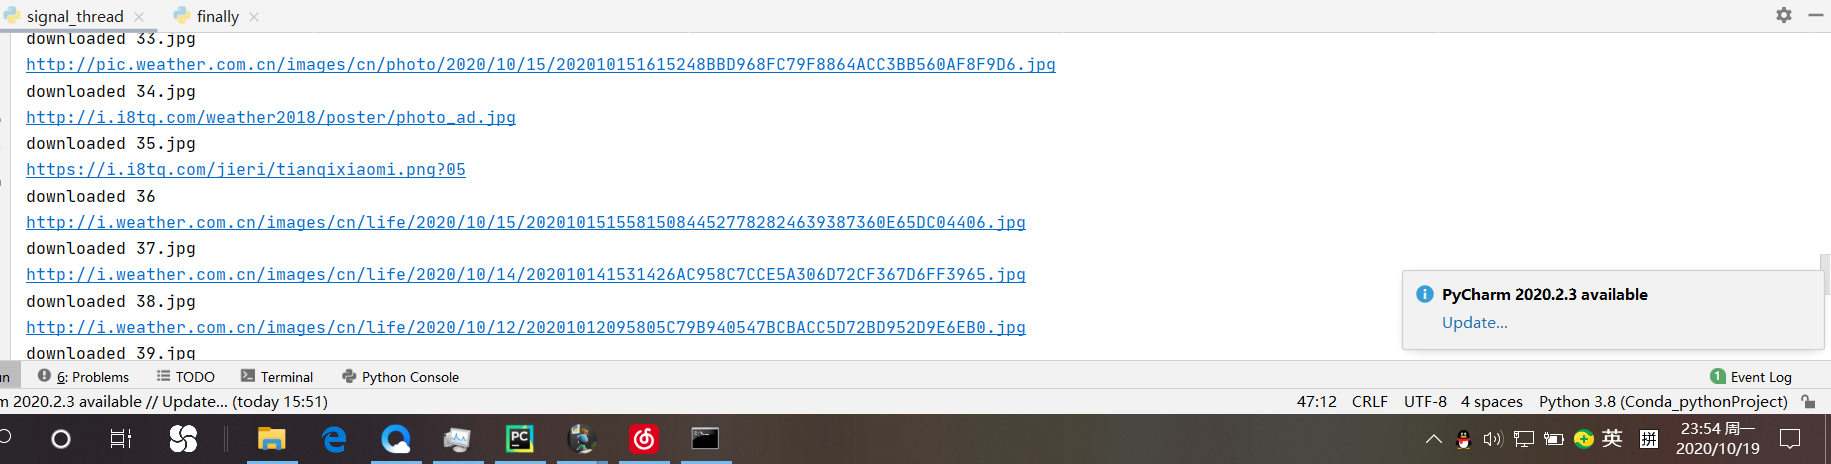
运行结果:可以观察到爬取到的图片是一张一张迭代出现的
多线程代码:
from bs4 import BeautifulSoup

from bs4 import UnicodeDammit

import urllib.request

import threading

def imageSpider(start_url):

    global threads

    global count

    try:

        urls = []

        req = urllib.request.Request(start_url, headers=headers)

        data = urllib.request.urlopen(req)

        data = data.read()

        dammit = UnicodeDammit(data, ["utf-8", "gbk"])

        data = dammit.unicode_markup

        soup = BeautifulSoup(data, "lxml")

        images = soup.select("img")

        for image in images:

            try:

                src = image["src"]

                url = urllib.request.urljoin(start_url, src)

                if url not in urls:

                    print(url)

                    count = count + 1

                    T = threading.Thread(target=download, args=(url, count))

                    T.setDaemon(False)

                    T.start()

                    threads.append(T)

            except Exception as err:

               print(err)

    except Exception as err: print(err)

def download(url,count):

    try:

        if (url[len(url) - 4] == "."):

            ext = url[len(url) - 4:]

        else:

            ext = ""

        req = urllib.request.Request(url, headers=headers)

        data = urllib.request.urlopen(req, timeout=100)

        data = data.read()

        fobj = open("images\\" + str(count) + ext, "wb")

        fobj.write(data)

        fobj.close()

        print("downloaded " + str(count) + ext)

    except Exception as err:

        print(err)

start_url="http://www.weather.com.cn/weather/101280601.shtml"

headers = {

"User-Agent": "Mozilla/5.0 (Windows; U; Windows NT 6.0 x64; en-US; rv:1.9pre)Gecko/2008072421 Minefield/3.0.2pre"}

count=0

threads=[]

imageSpider(start_url)

for t in threads:

    t.join()

print("The End")
运行结果:可以观察到是“唰”一大串出现的结果,特别舒服,无需等待。

小结:多线程之所以比单线程效率要高出许多,是因为线程的划分尺度小于进程,使得多线程程序的并发性高。进程在执行过程之中拥有独立的内存单元,而多个线程共享内存,从而极大的提升了程序的运行效率。线程比进程具有更高的性能,这是由于同一个进程中的线程都有共性,多个线程共享一个进程的虚拟空间。线程的共享环境包括进程代码段、进程的共有数据等,利用这些共享的数据,线程之间很容易实现通信。操作系统在创建进程时,必须为改进程分配独立的内存空间,并分配大量的相关资源,但创建线程则简单得多。因此,使用多线程来实现并发比使用多进程的性能高得
PS:知识的融会贯通体现出来了,操作系统的内容
任务二:使用scrapy复现任务一
主要步骤:
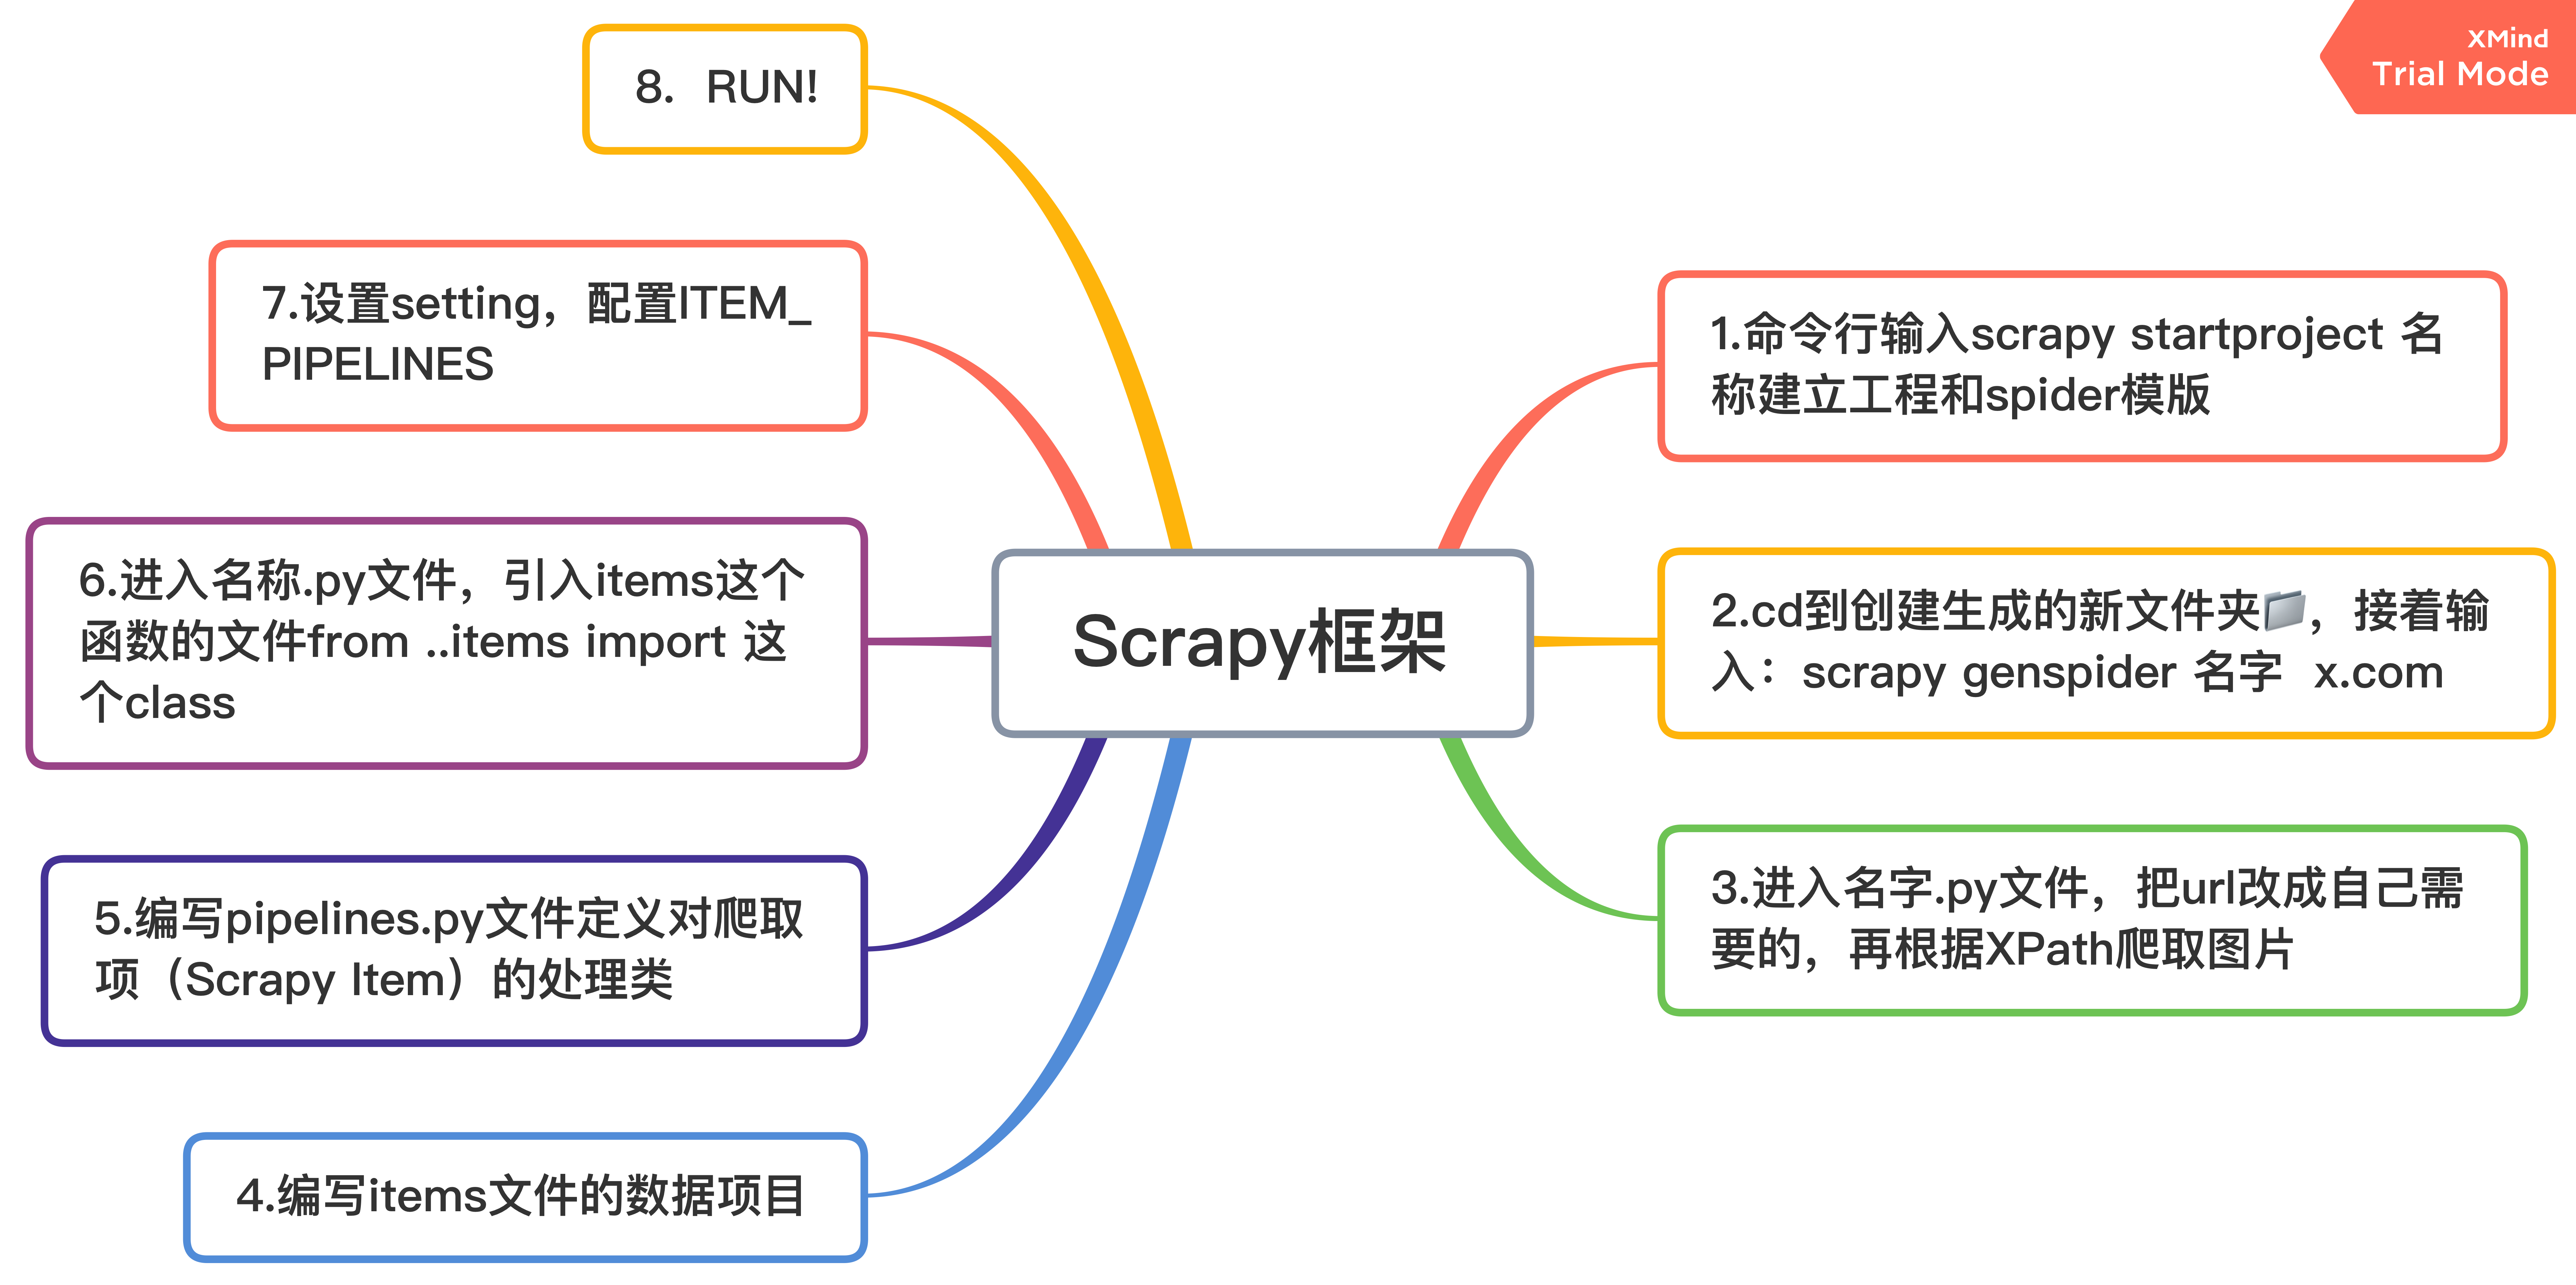
代码展示:
主spider:jpgdownload.py(不止下载jpg,也可以png)
import scrapy

from ..items import JpgItem

class JpgdownloadSpider(scrapy.Spider):

    name = 'jpgdownload'#给爬虫命名

    # allowed_domains = ['baidu.com']

    start_urls = ['http://www.weather.com.cn']

    def parse(self, response):

        try:

            srcs = response.xpath('//img/@src')

            # os.mkdir("D:/Conda_pythonProject/code_of_Data_Acquisition/Scrapy_pycharm/images")

            imgs_src = srcs.extract()  # 返回一个图片src的list

            for src in imgs_src:

                item = JpgItem()

                print(src)  # 输出下载的Url信息

                item["url"] = src

                # item["name"] = name

                # print(name)

                yield item

        except Exception as err:

            print(err)
items:
import scrapy

class JpgItem(scrapy.Item):

    # define the fields for your item here like:

    name = scrapy.Field()

    url = scrapy.Field()

    pass
pipelines:
import urllib

import urllib.request

from .settings import IMAGES_STORE

import os

class JpgPipeline:

    count = 0

    def process_item(self, item, spider):

        if (item["url"][len(item["url"]) - 4] == "."):

            ext = item["url"][len(item["url"]) - 4:]

        else:

            ext = ""

        JpgPipeline.count += 1

        save_path = IMAGES_STORE

        os.chdir(save_path)

        urllib.request.urlretrieve(url=item["url"], filename="NO"+str(JpgPipeline.count)+ext)

        return item
setting:
ITEM_PIPELINES = {

   'jpg.pipelines.JpgPipeline': 300,

   # 'scrapy.pipelines.images.ImagesPipeline':1,#scrapy内置管道

}

IMAGES_STORE=r'D:\Conda_pythonProject\code_of_Data_Acquisition\Scrapy_pycharm\images'          #图片保存地址
run.py
from scrapy import cmdline

cmdline.execute("scrapy crawl jpgdownload -s LOG_ENABLED=false".split())
结果展示:
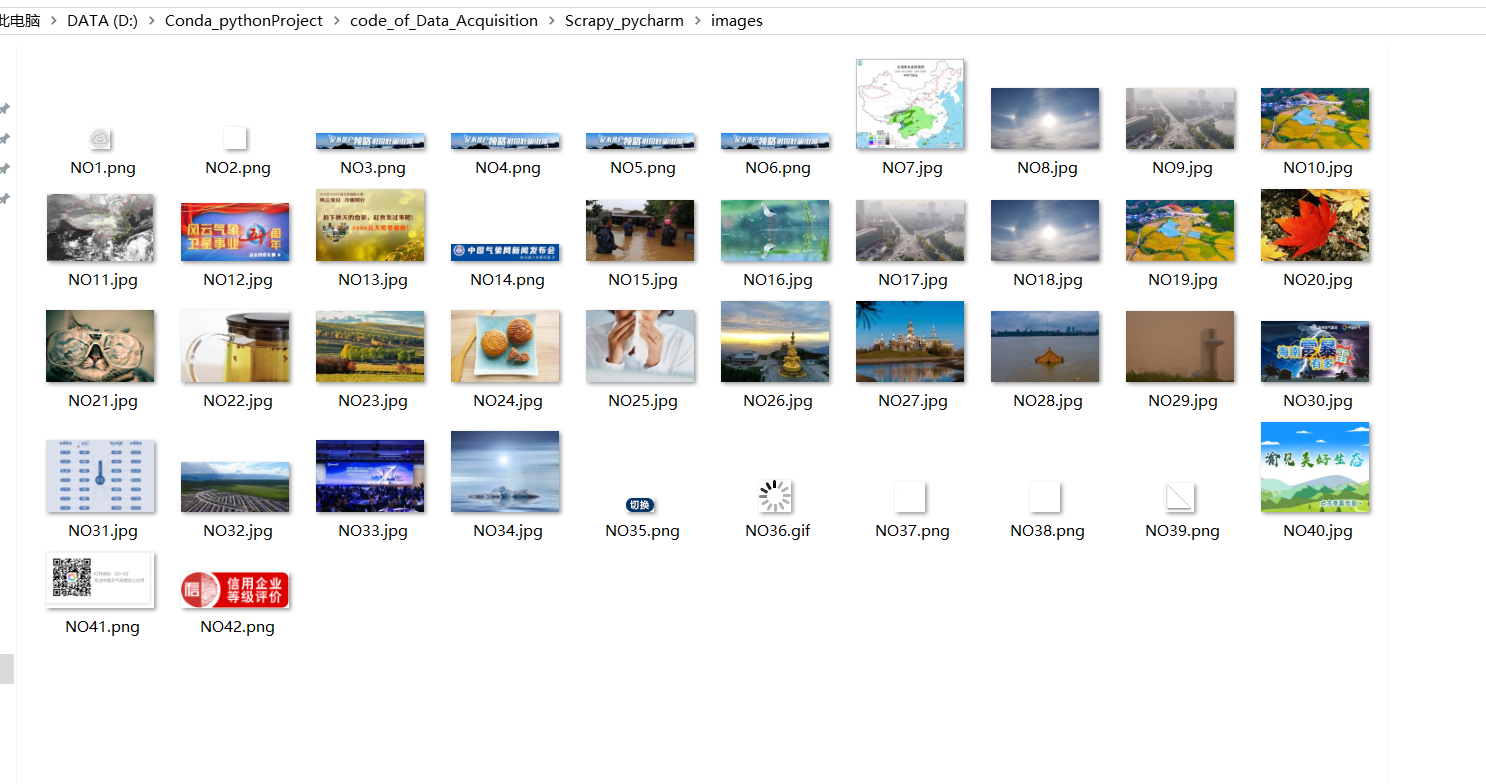
小结:个人感觉XPath很香,scrapy用不来,对各个模块之间的关系还要进一步加深理解。通过本次实验我也了解到在scrapy中不需要传统的import os来写文件,使用setting的内置通道并在piprlines中调用即可
IMAGES_STORE=r'D:\Conda_pythonProject\code_of_Data_Acquisition\Scrapy_pycharm\images'          #图片保存地址

from .settings import IMAGES_STORE  #在pipelines中
任务三:使用scrapy框架爬取股票信息
搞到大半夜了也不能再scrapy中复现上一次制定xls显示爬取结果的代码,有些自闭了,直接贴控制台输出的代码和结果。
stock.py
import scrapy

import re

import urllib.request

from bs4 import UnicodeDammit

from bs4 import BeautifulSoup

from ..items import EaststockItem

class StockSpider(scrapy.Spider):

    name = 'stock'

    # allowed_domains = ['baidu.com']

    start_urls = ['http://quote.eastmoney.com/stock_list.html']

    def parse(self, response):

        url = "http://22.push2.eastmoney.com/api/qt/clist/get?cb=jQuery112406286903286457721_1602799759543&pn=1&pz=20&po=1&np=1&ut=bd1d9ddb04089700cf9c27f6f7426281&fltt=2&invt=2&fid=f3&fs=m:0+t:6,m:0+t:13,m:0+t:80&fields=f12,f14,f2,f3,f4,f5,f6,f7,f15,f16,f17,f18&_=1602799759869"

        headers = {

            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) ""Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3775.400 QQBrowser/10.6.4209.400"}

        req = urllib.request.Request(url, headers=headers)

        data = urllib.request.urlopen(req)

        data = data.read()

        dammit = UnicodeDammit(data, ["utf-8", "gbk"])

        data = dammit.unicode_markup

        soup = BeautifulSoup(data, 'html.parser')

        data = re.findall(r'"diff":\[(.*?)]', soup.text)

        datas = data[0].strip("{").strip("}").split('},{')  # 去掉头尾的"{"和"}",再通过"},{"切片

        for i in range(len(datas)):

            item = EaststockItem()

            item["data"] = datas[i].replace('"', "").split(",")  # 去掉双引号并通过","切片

            yield item
pipelines:
# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: https://docs.scrapy.org/en/latest/topics/item-pipeline.html

# useful for handling different item types with a single interface

from itemadapter import ItemAdapter

class EaststockPipeline:

    number = 0

    print(

        "序号" + '\t' + "代码" + '\t' + "名称" + '\t' + "最新价" + '\t' + "涨跌幅" + '\t' + "跌涨额" + '\t' + "成交量" + '\t' + "成交额" + '\t' + "振幅" + '\t' + "最高" + '\t' + "最低" + '\t' + "今开" + '\t' + "昨收")

    def process_item(self, item, spider):

        EaststockPipeline.number += 1

        try:

            stock = item["data"]

            print(

                str(EaststockPipeline.number) + '\t' + stock[6][4:] + '\t' + stock[7][4:] + '\t' + stock[0][3:] + '\t' +

                stock[1][3:] + '\t' + stock[2][3:] + '\t' + stock[3][3:] + '\t' + stock[4][3:] + '\t' + stock[5][

                                                                                                        3:] + '\t' +

                stock[8][4:] + '\t' + stock[9][4:] + '\t' + stock[10][4:] + '\t' + stock[11][4:])

        except:

            pass

        return item
setting:
ITEM_PIPELINES = {

   'eaststock.pipelines.EaststockPipeline': 300,

}
items:
import scrapy

class EaststockItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    data = scrapy.Field()

    # Number = scrapy.Field()

    # Name = scrapy.Field()

    # Newest_price = scrapy.Field()

    # updownExtent = scrapy.Field()

    # updownValue = scrapy.Field()

    # Money_number = scrapy.Field()

    # Money = scrapy.Field()

    # Up_number = scrapy.Field()

    pass
输出图片:
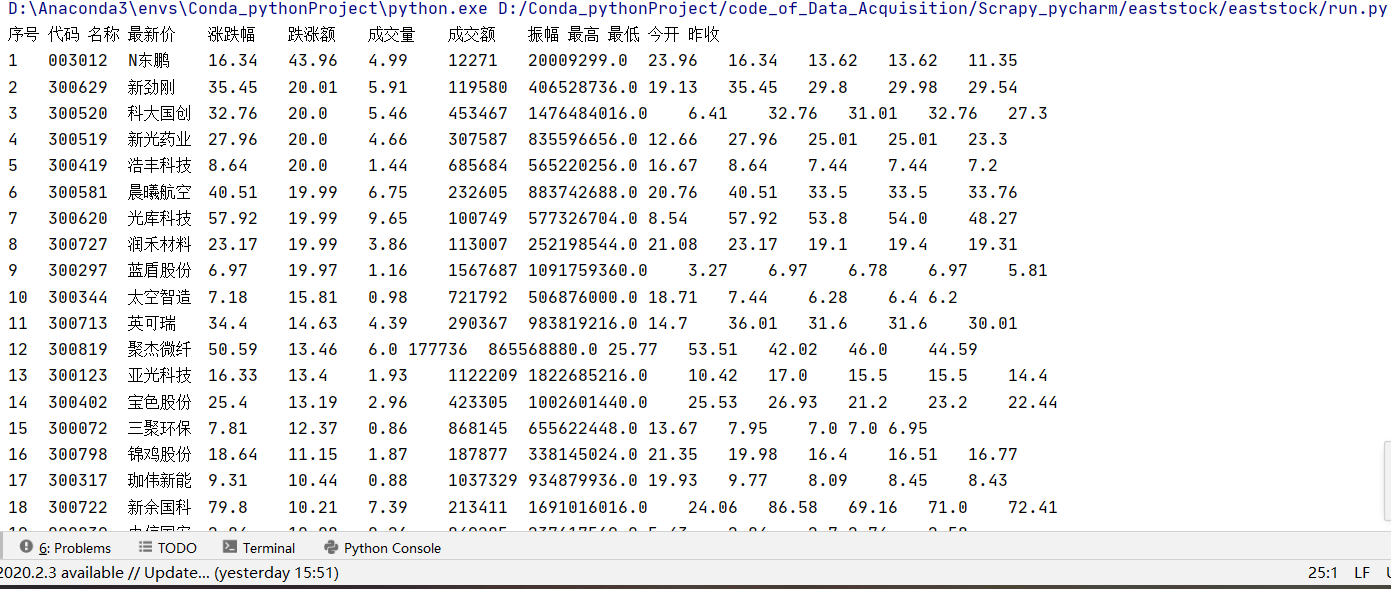
小结:或许是软工作业做完接着就写爬虫的原因,没能在scrapy中实现表格输出,等有精力了再请教同学试试。
总结:scrapy令初学者的我感到并不是很舒服,要编写5个地方似乎有点麻烦。它更多的是针对大规模爬取,scrapy框架将程序员从繁冗的流程式重复劳动中解放出来,简单的网页爬虫的重点,就集中在应对反爬,大规模爬取和高效稳定的爬取这几个方面。就像是一堆骨架需要注入血肉和灵魂它才能行走起来,编写好scrapy的各个结构才能让爬虫运行。
数据采集与融合第四次作业:多线程以及scrapy框架的使用的更多相关文章
- 网络爬虫第三次作业——多线程、scrapy框架
作业①: 1)单/多线程爬取网站图片实验 要求:指定一个网站,爬取这个网站中的所有的所有图片,例如中国气象网http://www.weather.com.cn.分别使用单线程和多线程的方式爬取. ...
- 十四 web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码
打码接口文件 # -*- coding: cp936 -*- import sys import os from ctypes import * # 下载接口放目录 http://www.yundam ...
- Python多线程爬图&Scrapy框架爬图
一.背景 对于日常Python爬虫由于效率问题,本次测试使用多线程和Scrapy框架来实现抓取斗图啦表情.由于IO操作不使用CPU,对于IO密集(磁盘IO/网络IO/人机交互IO)型适合用多线程,对于 ...
- 【OO学习】OO第四单元作业总结及OO课程总结
[OO学习]OO第四单元作业总结及OO课程总结 第四单元作业架构设计 第十三次作业 第十四次作业 总结 这两次作业架构思路上是一样的. 通过将需要使用的UmlElement,封装成Element的子类 ...
- BUAA OO 2019 第四单元作业总结
目录 第四单元总结 总 UML UML 类图 UML 时序图 UML 状态图 架构设计 第十三次作业 第十四次作业 课程总结 历次作业总结 架构设计 面向对象方法理解 测试方法理解与实践 改进建议 尽 ...
- oo第四单元作业总结暨课程总结
oo第四单元作业总结暨课程总结 一.本单元作业架构设计 本单元需要构建一个UML解析器,通过对输入的UML类图/顺序图/状态图的相关信息进行解析以供查询,其中课程组已提供输入整体架构及输入解析部分,仅 ...
- OO第四单元作业总结以及课程总结
第四单元总结--UML 第四单元作业架构分析 第一次作业其实是本单元三次作业中最难的一次.由于第一次是第一次作业,要考虑到搭建框架和设计架构,这次作业的思维性很强.在了解了各个类型元素(Element ...
- 2019OO第四单元作业总结&OO课程整体总结
第四单元作业总结 第四单元的作业主题是UML图的解析,通过对UML图代码的解析,我对UML图的结构以及各种元素之间的关系的理解更加深入了. ------------------------------ ...
- 耿丹CS16-2班第四次作业汇总
Deadline: 2016-10-13 12:00 作业内容 实验3-1 分别使用while循环.do while循环.for循环求1+2+3+ --+100. 实验3-2 分别使用while循环. ...
随机推荐
- 西安交通大学c++[mooc]课后题12章(只有后两题)
不是从第一题开始的,因为我刚准备把代码粘到CSDN上面,可以给自己看,也有可能启发后来者. 机会是留给有准备的人的 --路易斯·巴斯德 先写下第12周慕课学习总结吧! 多态就是将运算符重载, ...
- thinkphp5 chunk 分块处理数据小坑
场景: 使用chunk方法进行分块查询写入数据,执行发现chunk分几条一次处理 数据库就插入几条,并没有return false; 代码如下 解决方法: 增加排序字段
- 【Jenkins】active choices reactive parameter & Groovy Postbuild插件使用!
注:以上俩插件安装下载直接去jenkins官网或者百度下载即可 一.active choices reactive parameter 插件的使用 1.被关联的参数不做改动 2.添加active ch ...
- day35 Pyhton 网络编程02
一内容回顾 网络基础 网络应用开发架构 B/S架构 浏览器直接作为客户端的程序 C/S架构 B/S是特殊的C/S osi七层模型 应用层 python代码 http https ftp ...
- 正则匹配img标签 蜘蛛 爬取分析 新闻采集
string ostr = "aaaaaa<img asddsa src=\"\" asddsasd />aaaaaaa<img src=\" ...
- Python之包的相关
包的产生: 由于模块不断更新,越写越大,仅用单个py文件会使模块逻辑不够清晰,所以需要将模块的不同功能放入不同的py文件,然后将所有py文件放在一个目录内,这个目录就是包 包就是一个包含用__init ...
- 详解GaussDB(DWS) explain分布式执行计划
摘要:本文主要介绍如何详细解读GaussDB(DWS)产生的分布式执行计划,从计划中发现性能调优点. 前言 执行计划(又称解释计划)是数据库执行SQL语句的具体步骤,例如通过索引还是全表扫描访问表中的 ...
- vue 用别名取代路径引用
在项目开发过程中有可能很多包是没有放在npm上的,许多包需要下载到本地引用,这样一来我们只能通过require的方式来引用文件,但是路径的名字就会很长 例如 import Select from '. ...
- better-scroll 与 Vue 结合
什么是 better-scroll better-scroll 是一个移动端滚动的解决方案,它是基于 iscroll 的重写,它和 iscroll 的主要区别在这里.better-scroll 也很强 ...
- 转 js调用提交表单。
今天做网银支付的时候,需要做到点击支付的时候提交订单,然后新窗口打开支付界面. 思路1:window.open(''),这个直接被pass了,因为银行的服务一般都是需要post数据的.就算是可以用ge ...