
Pytorch训练时显存分配过程探究
对于显存不充足的炼丹研究者来说,弄清楚Pytorch显存的分配机制是很有必要的。下面直接通过实验来推出Pytorch显存的分配过程。
实验实验代码如下:
import torch

from torch import cuda

x = torch.zeros([3,1024,1024,256],requires_grad=True,device='cuda')

print("1", cuda.memory_allocated()/1024**2)

y = 5 * x

print("2", cuda.memory_allocated()/1024**2)

torch.mean(y).backward()

print("3", cuda.memory_allocated()/1024**2)

print(cuda.memory_summary())
输出如下:

代码首先分配3GB的显存创建变量x,然后计算y,再用y进行反向传播。可以看到,创建x后与计算y后分别占显存3GB与6GB,这是合理的。另外,后面通过backward(),计算出x.grad,占存与x一致,所以最终一共占有显存9GB,这也是合理的。但是,输出显示了显存的峰值为12GB,这多出的3GB是怎么来的呢?首先画出计算图:

下面通过列表的形式来模拟Pytorch在运算时分配显存的过程:
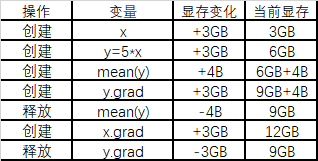
如上所示,由于需要保存反向传播以前所有前向传播的中间变量,所以有了12GB的峰值占存。
我们可以不存储计算图中的非叶子结点,达到节省显存的目的,即可以把上面的代码中的y=5*x与mean(y)写成一步:
import torch

from torch import cuda

x = torch.zeros([3,1024,1024,256],requires_grad=True,device='cuda')

print("1", cuda.memory_allocated()/1024**2)

torch.mean(5*x).backward()

print("2", cuda.memory_allocated()/1024**2)

print(cuda.memory_summary())
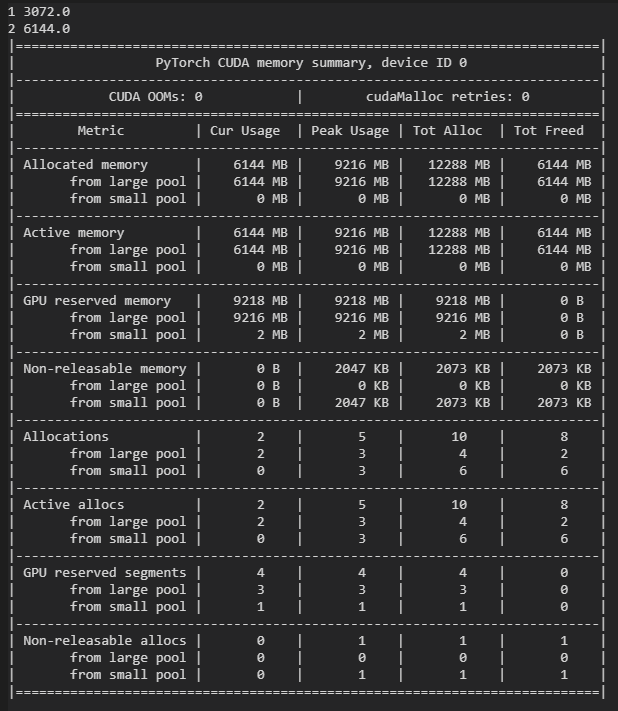
占显存量减少了3GB:
Pytorch训练时显存分配过程探究的更多相关文章
- [Pytorch]深度模型的显存计算以及优化
原文链接:https://oldpan.me/archives/how-to-calculate-gpu-memory 前言 亲,显存炸了,你的显卡快冒烟了! torch.FatalError: cu ...
- OpenGL8-直接分配显存-极速绘制(Opengl1.5版本才有)
视频教程请关注 http://edu.csdn.net/lecturer/lecturer_detail?lecturer_id=440 /** * 这个例子介绍如何使用显卡内存进行绘制 下载地址 : ...
- TensorFlow中的显存管理器——BFC Allocator
背景 作者:DeepLearningStack,阿里巴巴算法工程师,开源TensorFlow Contributor] 使用GPU训练时,一次训练任务无论是模型参数还是中间结果都需要占用大量显存.为了 ...
- 【原创】Linux环境下的图形系统和AMD R600显卡编程(4)——AMD显卡显存管理机制
显卡使用的内存分为两部分,一部分是显卡自带的显存称为VRAM内存,另外一部分是系统主存称为GTT内存(graphics translation table和后面的GART含义相同,都是指显卡的页表,G ...
- Tensorflow与Keras自适应使用显存
Tensorflow支持基于cuda内核与cudnn的GPU加速,Keras出现较晚,为Tensorflow的高层框架,由于Keras使用的方便性与很好的延展性,之后更是作为Tensorflow的官方 ...
- 关于python中显存回收的问题
技术背景 笔者在执行一个Jax的任务中,又发现了一个奇怪的问题,就是明明只分配了很小的矩阵空间,但是在多次的任务执行之后,显存突然就爆了.而且此时已经按照Jax的官方说明配置了XLA_PYTHON_C ...
- (原)tensorflow中函数执行完毕,显存不自动释放
转载请注明出处: http://www.cnblogs.com/darkknightzh/p/7608916.html 参考网址: https://stackoverflow.com/question ...
- Pytorch显存动态分配规律探索
下面通过实验来探索Pytorch分配显存的方式. 实验 显存到主存 我使用VSCode的jupyter来进行实验,首先只导入pytorch,代码如下: import torch 打开任务管理器查看主存 ...
- pytorch训练GAN时的detach()
我最近在学使用Pytorch写GAN代码,发现有些代码在训练部分细节有略微不同,其中有的人用到了detach()函数截断梯度流,有的人没用detch(),取而代之的是在损失函数在反向传播过程中将bac ...
随机推荐
- linux利用screen进行shell下的屏幕协作
我们都知道linux是支持多终端并行处理的 但是某些时候我们可能有比较特殊的需求需要两个人同时处理一个终端,screen 正好能满足这个要求 首先需要安装screen软件: debian和ubuntu ...
- 这个厉害了,阿里P7大佬都在看的SpringCloud 总结,帮你梳理全部知识点!
微服务 微服务架构是一种以一些微服务来替代开发单个大而全应用的方法,每一个小服务运行在自己的进程里,并以轻量级的机制来通信, 通常是 HTTP RESTful API.微服务强调小快灵, 任何一个相对 ...
- node.js报错:Cannot find module 'xxx'的解决办法
从别处拷贝一份node.js项目,如图 控制台启动 nodemon index.js 后报错:Cannot find module xxx.删除node_modules,在启动时仍提示Cannot f ...
- MathType如何对齐公式
作为强大的公式编辑器,MathType为我们的学习.工作带来了极大的便利.比如在写论文时,有了它,就可以轻松就把论文里的公式码完:老师在编写试卷时,利用它,可以快速编写出一份试卷.那么在编写公式时,也 ...
- guitar pro系列教程(五):Guitar Pro音轨属性之小节的功能
又到了guitar pro系列教程新的一章,本章节小编将采用图文相结合的方式与大家一起来讨论下关于Guitar Pro小节的功能,感兴趣的小伙伴都可以进来看看哦,如下图所示: 我们看到小节这选项栏中分 ...
- Python正则表达式大全
前言 正则表达式是对字符串(包括普通字符(例如,a 到 z 之间的字母)和特殊字符(称为"元字符"))操作的一种逻辑公式,就是用事先定义好的一些特定字符.及这些特定字符的组合,组成 ...
- linux常见目录
- python应用(5):变量类型与数据结构
如前所说,写程序如同给算法写壳,而算法就是流程,所以流程是程序的主角(但这个流程不一定要你来设计).在程序中,为了配合流程(算法)的实现,除了顺序.分支与循环语句的使用,还要借助"变量&qu ...
- 红黑树、TreeMap、TreeSet
事先声明以下代码基于JDK1.8版本 参考资料 大部分图片引自https://www.jianshu.com/p/e136ec79235c侵删 https://www.cnblogs.com/skyw ...
- fist-第五天冲刺随笔
这个作业属于哪个课程 https://edu.cnblogs.com/campus/fzzcxy/2018SE1 这个作业要求在哪里 https://edu.cnblogs.com/campus/fz ...