
聊聊Spark的分区、并行度 —— 前奏篇
通过之前的文章【Spark RDD详解】,大家应该了解到Spark会通过DAG将一个Spark job中用到的所有RDD划分为不同的stage,每个stage内部都会有很多子任务处理数据,而每个stage的任务数是决定性能优劣的关键指标。
首先来了解一下Spark中分区的概念,其实就是将要处理的数据集根据一定的规则划分为不同的子集,每个子集都算做一个单独的分区,由集群中不同的机器或者是同一台机器不同的core进行分区并行处理。
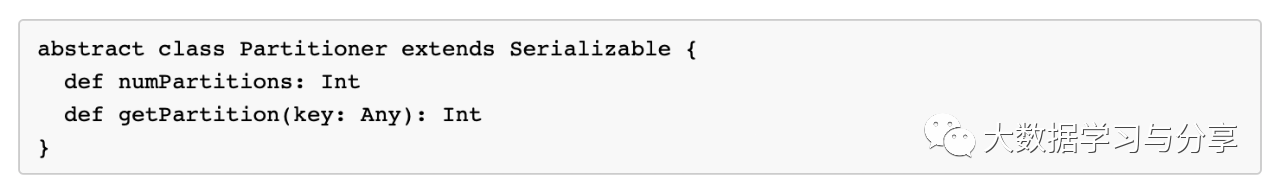
Spark对接不同的数据源,在第一次得到的分区数是不一样的,但都有一个共性:对于map类算子或者通过map算子产生的彼此之间具有窄依赖关系的RDD的分区数,子RDD分区与父RDD分区是一致的。而对于通过shuffle差生的子RDD则由分区器决定,当然默认分区器是HashPartitioner,我们完全可以根据实际业务场景进行自定义分区器,只需继承Parttioner组件,主要重写几个方法即可
以加载hdfs文件为例,Spark在读取hdfs文件还没有调用其他算子进行业务处理前,得到的RDD分区数由什么决定呢?关键在于文件是否可切分!
对于可切分文件,如text文件,那么通过加载文件得到的RDD的分区数默认与该文件的block数量保持一致;
对于不可切分文件,它只有一个block块,那么得到的RDD的分区数默认也就是1。
当然,我们可以通过调用一些算子对RDD进行重分区,如repartition。
这里必须要强调一点,很多小伙伴不理解,RDD既然不存储数据,那么加载过来的文件都跑哪里去了呢?这里先给大家提个引子——blockmanager,Spark自己实现的存储管理器。RDD的存储概念其实block,至于block的大小可以根据不同的数据源进行调整,blockmanager的数据存储、传输都是以block进行的。至于block内部传输的时候,它的大小也是可以通过参数控制的,比如广播变量、shuffle传输时block的大小等。
下面再通过大家熟知的一个参数spark.default.parallelism为引,聊一聊Spark并行度都由哪些因素决定?
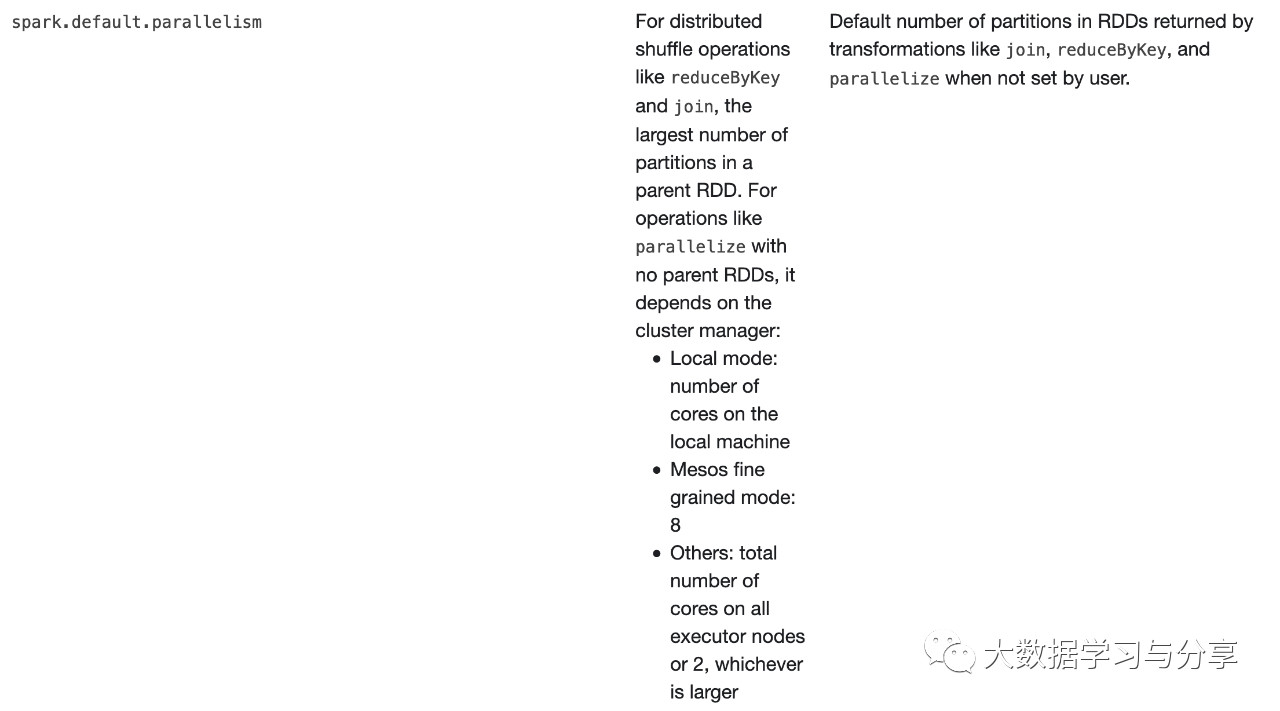
上图是spark官网关于spark.default.parallelism参数说明:
对于reduceByKey和join这些分布式shuffle算子操作,取决于它的父RDD中分区数的最大值
对于没有父RDD的的算子,比如parallelize,依赖于集群管理器:
本地模式:取决于本地机器的核数
如果集群管理器是Mesos,则为8
其他的:对比所有executor上总核数与2比较,哪个大是哪个
当然上面这些都是默认值,如果我们自己设置了分区数,情况就会有所变化,直接看源码【查看org.apache.spark.Partitioner源码defaultPartitioner方法】
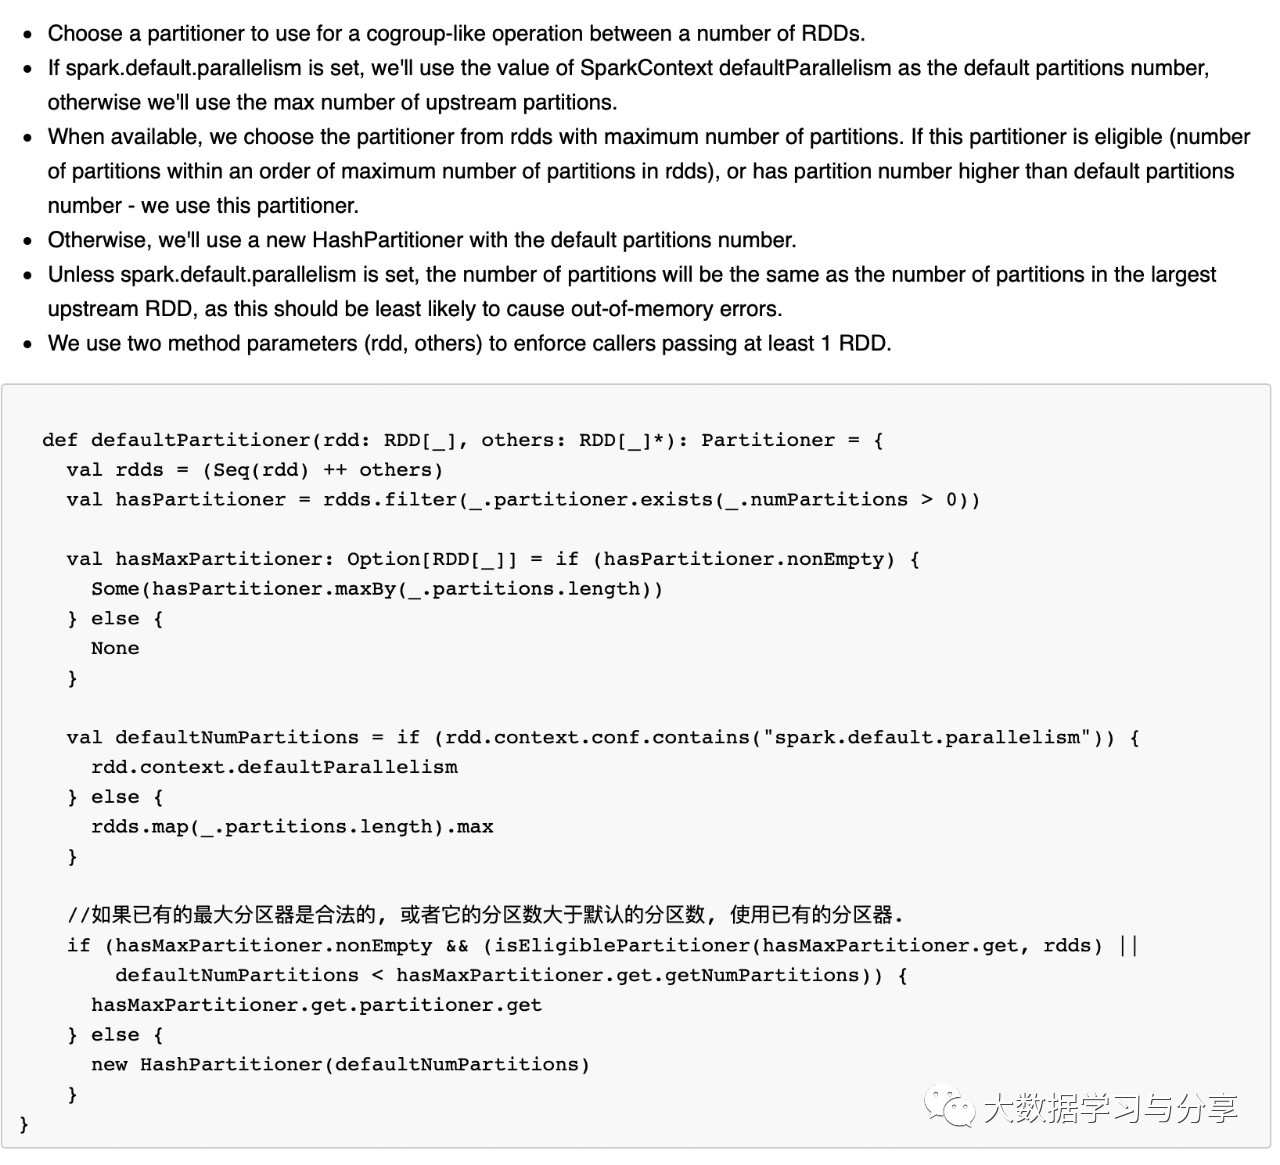
你会发现,如果你使用reducebykey、groupByKey等这些带shuffle的算子,建议不要通过上述方法让程序内部去推测。完全可以通过传入一个确定的分区数或者自己实现一个分区器来做处理。当然这个确定的分区数也不是贸贸然设定的,需要结合你的业务场景根据实际情况来确定多少合适。比如shuffle时流经的数据量,这个就要结合分区数和shuffle总数据量来做适当调整,处理不好的结果极有可能导致数据倾斜等问题...
笔者再次建议,学习Spark一定要多看Spark官网http://spark.apache.org/,并且多看源码
关注微信公众号:大数据学习与分享,获取更对技术干货
聊聊Spark的分区、并行度 —— 前奏篇的更多相关文章
- 重要 | Spark分区并行度决定机制
最近经常有小伙伴在本公众号留言,核心问题都比较类似,就是虽然接触Spark有一段时间了,但是搞不明白一个问题,为什么我从HDFS上加载不同的文件时,打印的分区数不一样,并且好像spark.defaul ...
- 【转载】 Spark性能优化指南——基础篇
转自:http://tech.meituan.com/spark-tuning-basic.html?from=timeline 前言 开发调优 调优概述 原则一:避免创建重复的RDD 原则二:尽可能 ...
- 【转】【技术博客】Spark性能优化指南——高级篇
http://mp.weixin.qq.com/s?__biz=MjM5NjQ5MTI5OA==&mid=2651745207&idx=1&sn=3d70d59cede236e ...
- 【转】Spark性能优化指南——基础篇
http://mp.weixin.qq.com/s?__biz=MjM5NDMwNjMzNA==&mid=2651805828&idx=1&sn=2f413828d1fdc6a ...
- Spark性能优化指南——基础篇(转载)
前言 在大数据计算领域,Spark已经成为了越来越流行.越来越受欢迎的计算平台之一.Spark的功能涵盖了大数据领域的离线批处理.SQL类处理.流式/实时计算.机器学习.图计算等各种不同类型的计算操作 ...
- Spark性能优化指南——基础篇
本文转自:http://tech.meituan.com/spark-tuning-basic.html 感谢原作者 前言 在大数据计算领域,Spark已经成为了越来越流行.越来越受欢迎的计算平台之一 ...
- Spark性能优化指南——高级篇
本文转载自:https://tech.meituan.com/spark-tuning-pro.html 美团技术点评团队) Spark性能优化指南——高级篇 李雪蕤 ·2016-05-12 14:4 ...
- Spark性能优化指南——基础篇转
前言 在大数据计算领域,Spark已经成为了越来越流行.越来越受欢迎的计算平台之一.Spark的功能涵盖了大数据领域的离线批处理.SQL类处理.流式/实时计算.机器学习.图计算等各种不同类型的计算操作 ...
- Spark性能优化指南--基础篇
前言 开发调优 调优概述 原则一:避免创建重复的RDD 原则二:尽可能复用同一个RDD 原则三:对多次使用的RDD进行持久化 原则四:尽量避免使用shuffle类算子 原则五:使用map-side预聚 ...
随机推荐
- lua 源码阅读 5.3.5 笔记
记录下吧,断断续续读了几周,收益还是很多的. 推荐阅读顺序: 1) 基础数据类型 lstring.c ltable.c lobject.c lfunc.c lstate.c 2) 标准库(这个相对简 ...
- IIS日志文件越来越大导致C盘空间变小处理方法
问题概述 C:\inetpub\logs\LogFiles\W3SVC文件夹越来越大,IIS日志会消耗大量的硬盘空间,有潜在写满整个硬盘空间的风险,为了解决这个问题很多用户会选择关闭日志,但显然IIS ...
- CentOS7克隆多个虚拟机
VMware+centos7克隆虚拟机 步骤一:打开虚拟机,右键选中已经配置好的虚拟机,选择manage下面的clone选项.这里有一个需要注意的地方,就是虚拟机在启动或者挂起的状态下是不能clone ...
- CentOS 7的安装与部署 02
2.2 操作系统安装过程 第01步:加载系统镜像 第02步:启动虚拟主机 第03步:系统安装选择界面修改网卡名称 启动虚拟机后,会出现选择菜单,首先用方向键选择 install centos7选项,然 ...
- post 和php://input 转
$_POST['paramName'] 获取通过表单(multipart/form-data)提交的数据.但有时客户端会直接将请求数据以字符串的形式都放到 body 里传递过来,那么服务端就需要使用 ...
- php超全局数组 为什么swoole的http服务不能用
php的超全局数组$_GET等九个 可以直接使用 无需定义 实际上是浏览器请求到Apache或者nginx的时候 转发到PHP处理模块 fpm转发给php解释器处理 php封装好后丢给php的 sw ...
- lumen路由
$router->get('/', function () use ($router) { return config('options.author'); }); $router->ge ...
- Anderson《空气动力学基础》5th读书笔记 第5记——推导二维机翼的空气动力学系数
机翼的受力分析图 我们知道,空气对一个物体产生的升力和阻力以及力矩源于作用在整个物体上的压力分布和剪切力分布,所以我们分析上图可知(取单位展长的机翼): 对于上表面: ...
- Nginx02---配置文件
Nginx(二)------nginx.conf 配置文件 目录 1.nginx.conf 的主体结构 2.全局块 3.events 块 4.http 块 ①.http 全局块 ②.server ...
- win7下安装docker
为了支持老版本的windows系统,docker官方提供了docker toolbox,让用户可以在windows10以前版本的操作系统上来体验docker. 一,安装 下载msi安装文件,一路nex ...