
重要 | Spark分区并行度决定机制
最近经常有小伙伴在本公众号留言,核心问题都比较类似,就是虽然接触Spark有一段时间了,但是搞不明白一个问题,为什么我从HDFS上加载不同的文件时,打印的分区数不一样,并且好像spark.default.parallelism这个参数时不是一直起作用?其实笔者之前的文章已有相关介绍,想知道为什么,就必须了解Spark在加载不同的数据源时分区决定机制以及调用不用算子时并行度决定机制以及分区划分。
其实之前的文章《Spark的分区》、《通过spark.default.parallelism谈Spark并行度》已有所介绍,笔者今天再做一次详细的补充,建议大家在对Spark有一定了解的基础上,三篇文章结合一起看。
大家都知道Spark job中最小执行单位为task,合理设置Spark job每个stage的task数是决定性能好坏的重要因素之一,但是Spark自己确定最佳并行度的能力有限,这就要求我们在了解其中内在机制的前提下,去各种测试、计算等来最终确定最佳参数配比。
Spark任务在执行时会将RDD划分为不同的stage,一个stage中task的数量跟最后一个RDD的分区数量相同。之前已经介绍过,stage划分的关键是宽依赖,而宽依赖往往伴随着shuffle操作。对于一个stage接收另一个stage的输入,这种操作通常都会有一个参数numPartitions来显示指定分区数。最典型的就是一些ByKey算子,比如groupByKey(numPartitions: Int),但是这个分区数需要多次测试来确定合适的值。首先确定父RDD中的分区数(通过rdd.partitions().size()可以确定RDD的分区数),然后在此基础上增加分区数,多次调试直至在确定的资源任务能够平稳、安全的运行。
对于没有父RDD的RDD,比如通过加载HDFS上的数据生成的RDD,它的分区数由InputFormat切分机制决定。通常就是一个HDFS block块对应一个分区,对于不可切分文件则一个文件对应一个分区。
对于通过SparkContext的parallelize方法或者makeRDD生成的RDD分区数可以直接在方法中指定,如果未指定,则参考spark.default.parallelism的参数配置。下面是默认情况下确定defaultParallelism的源码:
override def defaultParallelism(): Int = {
conf.getInt("spark.default.parallelism", math.max(totalCoreCount.get(), 2))
}
通常,RDD的分区数与其所依赖的RDD的分区数相同,除非shuffle。但有几个特殊的算子:
1. coalesce和repartition算子
笔者先放两张关于该coalesce算子分别在RDD和DataSet中的源码图:(DataSet是Spark SQL中的分布式数据集,后边说到Spark时再细讲)
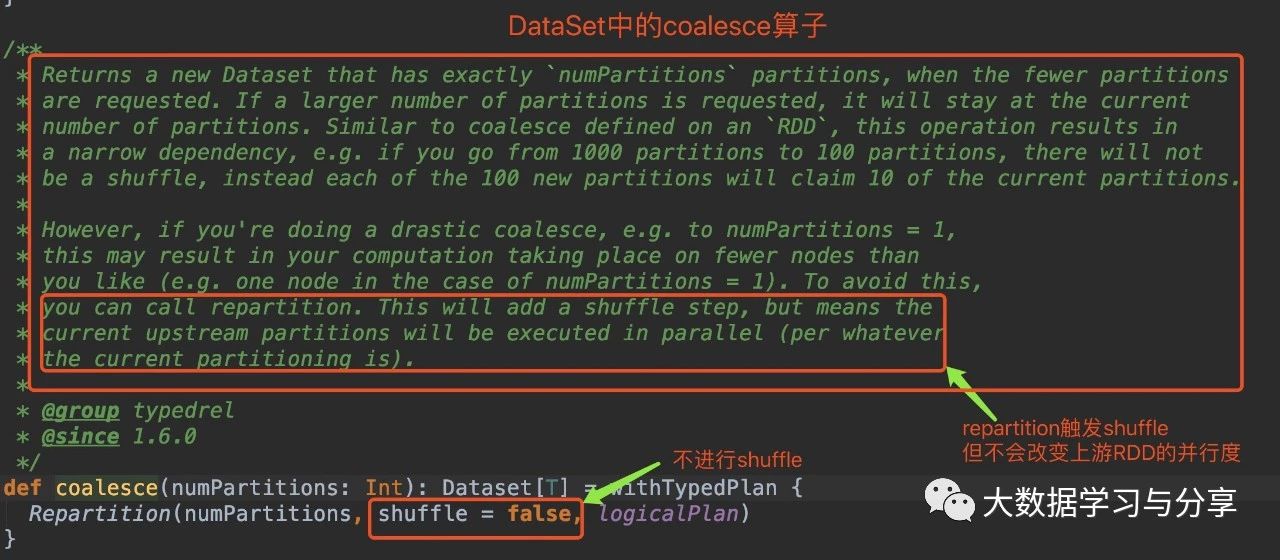
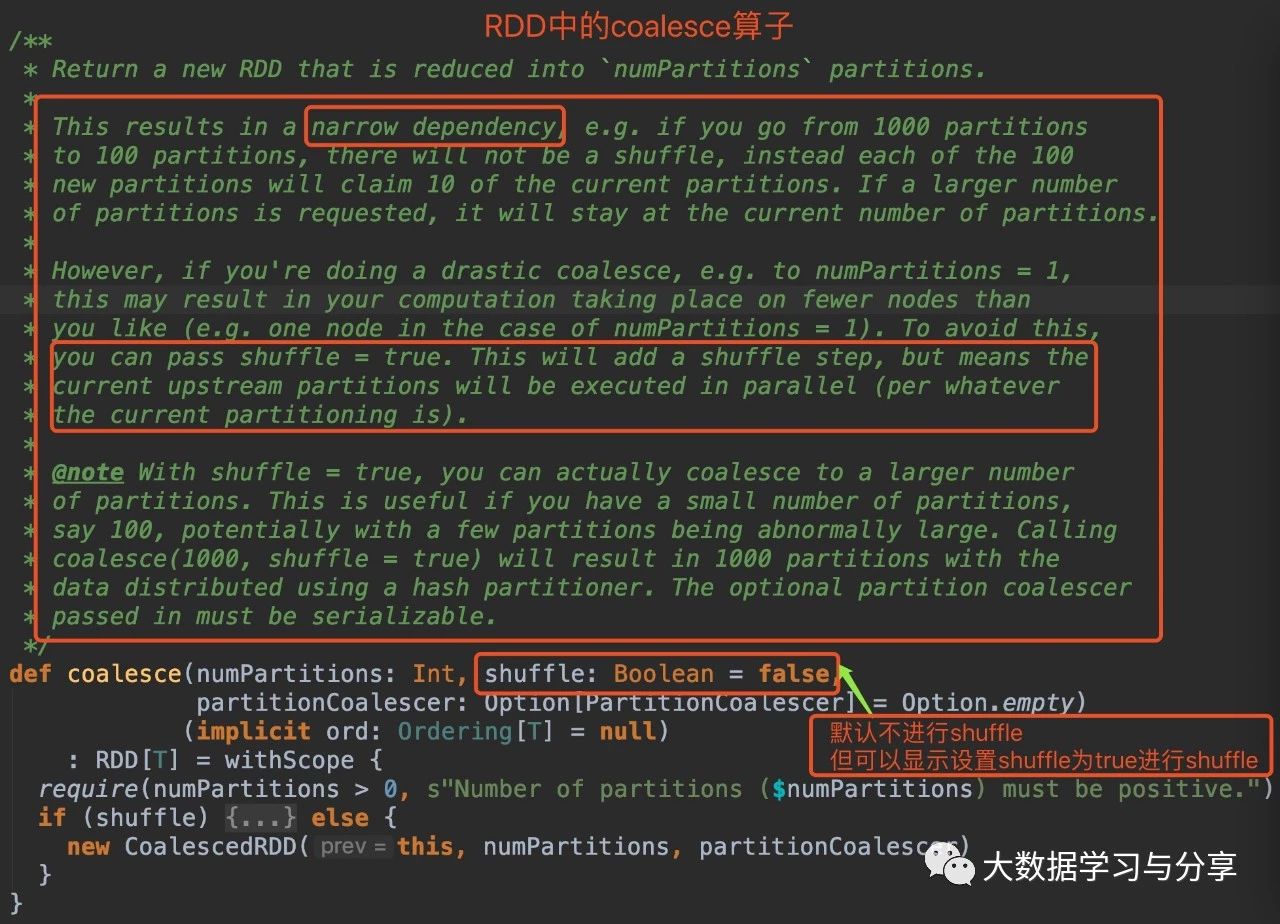
通过coalesce源码分析,无论是在RDD中还是DataSet,默认情况下coalesce不会产生shuffle,此时通过coalesce创建的RDD分区数小于等于父RDD的分区数。
笔者这里就不放repartition算子的源码了,分析起来也比较简单,图中我有所提示。但笔者建议,如下两种情况,请使用repartition算子:
1)增加分区数repartition触发shuffle,shuffle的情况下可以增加分区数。
coalesce默认不触发shuffle,即使调用该算子增加分区数,实际情况是分区数仍然是当前的分区数。
2)极端情况减少分区数,比如将分区数减少为1调整分区数为1,此时数据处理上游stage并行度降,很影响性能。此时repartition的优势即不改变原来stage的并行度就体现出来了,在大数据量下,更为明显。但需要注意,因为repartition会触发shuffle,而要衡量好shuffle产生的代价和因为用repartition增加并行度带来的效益。
2. union算子
还是直接看源码:
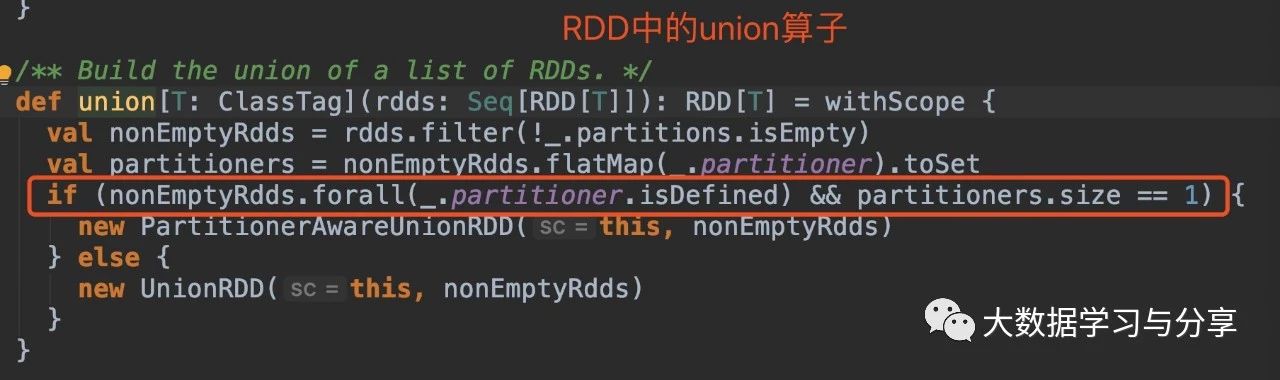

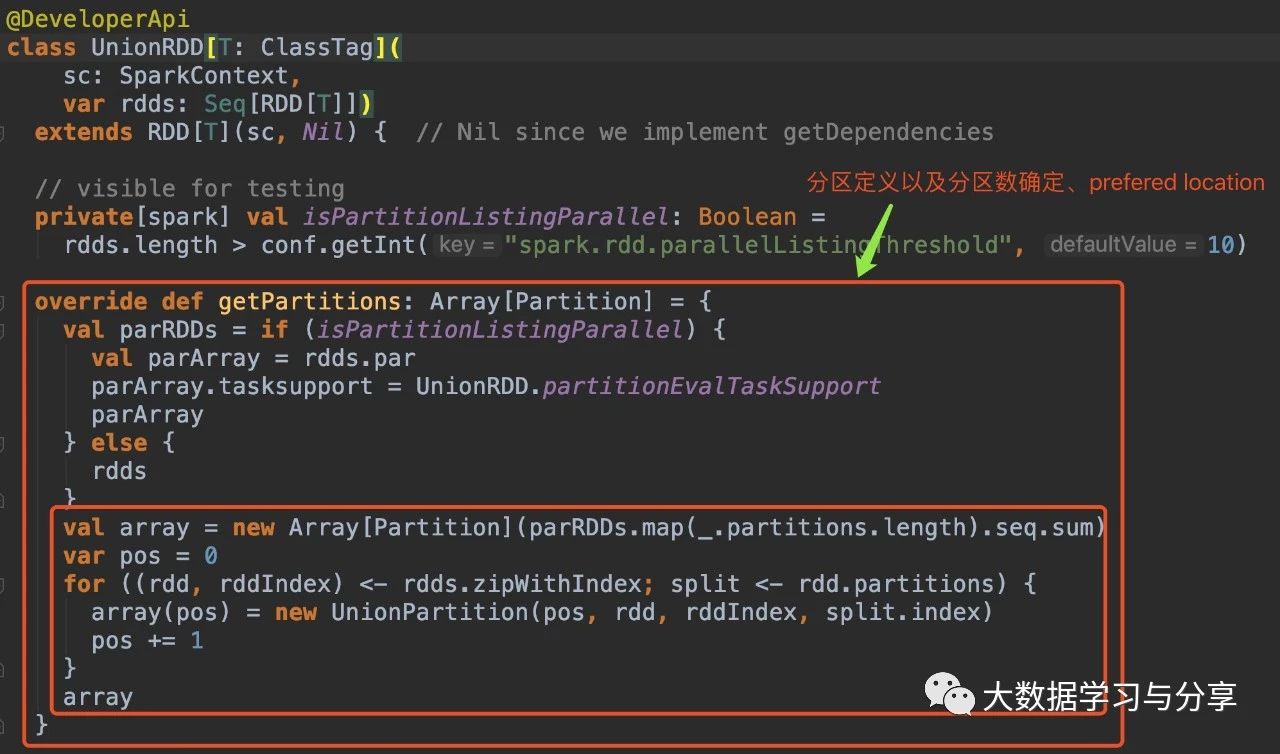
通过分析源码,RDD在调用union算子时,最终生成的RDD分区数分两种情况:1)union的RDD分区器已定义并且它们的分区器相同
多个父RDD具有相同的分区器,union后产生的RDD的分区器与父RDD相同且分区数也相同。比如,n个RDD的分区器相同且是defined,分区数是m个。那么这n个RDD最终union生成的一个RDD的分区数仍是m,分区器也是相同的
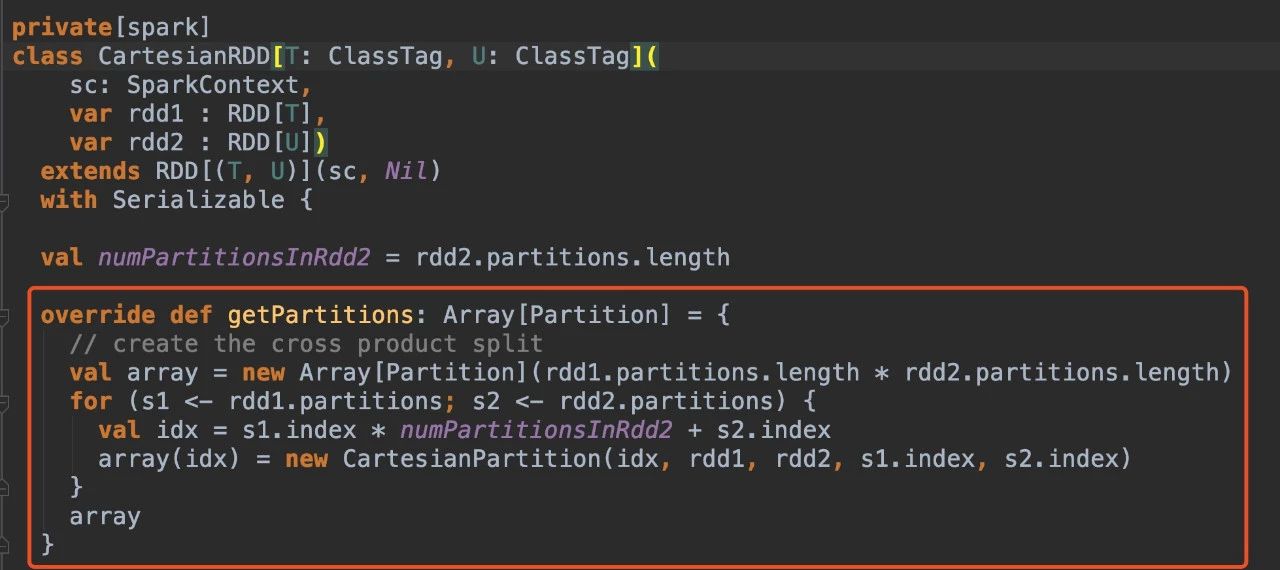
2)不满足第一种情况,则通过union生成的RDD的分区数为父RDD的分区数之和4.cartesian算子
通过上述coalesce、repartition、union算子介绍和源码分析,很容易分析cartesian算子的源码。通过cartesian得到RDD分区数是其父RDD分区数的乘积。
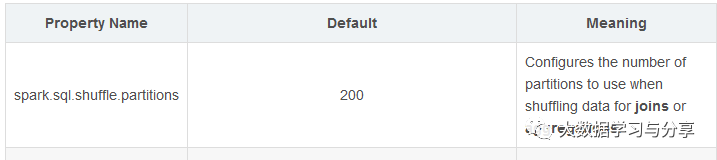
在Spark SQL中,任务并行度参数则要参考spark.sql.shuffle.partitions,笔者这里先放一张图,详细的后面讲到Spark SQL时再细说:
看下图在Spark流式计算中,通常将SparkStreaming和Kafka整合,这里又分两种情况:
1. Receiver方式生成的微批RDD即BlockRDD,分区数就是block数
2. Direct方式生成的微批RDD即kafkaRDD,分区数和kafka分区数一一对应
等说到Spark流式处理时再详细阐述。
关注微信公众号:大数据学习与分享,获取更对技术干货
重要 | Spark分区并行度决定机制的更多相关文章
- Hive和Spark分区策略
1.概述 离线数据处理生态系统包含许多关键任务,最大限度的提高数据管道基础设施的稳定性和效率是至关重要的.这边博客将分享Hive和Spark分区的各种策略,以最大限度的提高数据工程生态系统的稳定性和效 ...
- [Spark内核] 第35课:打通 Spark 系统运行内幕机制循环流程
本课主题 打通 Spark 系统运行内幕机制循环流程 引言 通过 DAGScheduelr 面向整个 Job,然后划分成不同的 Stage,Stage 是從后往前划分的,执行的时候是從前往后执行的,每 ...
- 【Spark 深入学习-08】说说Spark分区原理及优化方法
本节内容 ------------------ · Spark为什么要分区 · Spark分区原则及方法 · Spark分区案例 · 参考资料 ------------------ 一.Spark为什 ...
- Spark学习之路 (十七)Spark分区
一.分区的概念 分区是RDD内部并行计算的一个计算单元,RDD的数据集在逻辑上被划分为多个分片,每一个分片称为分区,分区的格式决定了并行计算的粒度,而每个分区的数值计算都是在一个任务中进行的,因此任务 ...
- Spark cache、checkpoint机制笔记
Spark学习笔记总结 03. Spark cache和checkpoint机制 1. RDD cache缓存 当持久化某个RDD后,每一个节点都将把计算的分片结果保存在内存中,并在对此RDD或衍生出 ...
- Spark(十一)Spark分区
一.分区的概念 分区是RDD内部并行计算的一个计算单元,RDD的数据集在逻辑上被划分为多个分片,每一个分片称为分区,分区的格式决定了并行计算的粒度,而每个分区的数值计算都是在一个任务中进行的,因此任务 ...
- 打通 Spark 系统运行内幕机制循环流程
本课主题 打通 Spark 系统运行内幕机制循环流程 引言 通过 DAGScheduelr 面向整个 Job,然后划分成不同的 Stage,Stage 是从后往前划分的,执行的时候是從前往后执行的,每 ...
- spark分区
spark默认的partition的分区数是和本机CPU的核数保持一致: bucket的数量和reduce的数量一致:buket的概念是map会将计算获得数据放到各个buket中,每个bucket和一 ...
- spark 源码分析之十二 -- Spark内置RPC机制剖析之八Spark RPC总结
在spark 源码分析之五 -- Spark内置RPC机制剖析之一创建NettyRpcEnv中,剖析了NettyRpcEnv的创建过程. Dispatcher.NettyStreamManager.T ...
随机推荐
- oracle 查询当前数据库环境
select SYS_CONTEXT('USERENV','AUTHENTICATION_TYPE')用户的认证类型 from dual;--用户的认证类型select SYS_CONTEXT('US ...
- CentOS 7系统常见快捷键操作方式
快捷键操作方式 Linux系统中一些常见的快捷方式,可有效提高操作效率,在某些时刻也能避免操作失误带来的问题. 最有用的快捷键 序号 快捷键 官方说明 掌握程度 01 Tab 命令或路径等的补全键 移 ...
- go函数可见性
可见性 可见性,包内任何变量或函数都是能访问的.包外的话,首字母大写是可导出的,能够被其他包访问或者调用,小写表示是私有的,不能被外部包访问或调用
- C++学习笔记---引用的本质
本质:引用本质上是C++内部实现的一个指针常量 发现是引用的话,自动帮我们转换成指针常量 运行后,发现修改ref的值那么a的值也会一起改变,这就说明了引用的本质就是指针
- SLF4J :Failed to load class "org.slf4j.impl.StaticLoggerBinder".
错误提示 SLF4J: Failed to load class "org.slf4j.impl.StaticLoggerBinder". SLF4J: Defaulting to ...
- 从一个例子入手Istio
转载请声明出处哦~,本篇文章发布于luozhiyun的博客:https://www.luozhiyun.com 本文使用的Istio源码是 release 1.5. 本篇是Istio系列的第一篇,希望 ...
- 并发编程——多线程计数的更优解:LongAdder原理分析
前言 最近在学习ConcurrentHashMap的源码,发现它采用了一种比较独特的方式对map中的元素数量进行统计,自然是要好好研究一下其原理思想,同时也能更好地理解ConcurrentHashMa ...
- 01 . Go框架之Gin框架从入门到熟悉(路由和上传文件)
Gin框架简介 Gin是使用Go/Golang语言实现的HTTP Web框架, 接口简洁, 性能极高,截止1.4.0版本,包含测试代码,仅14K, 其中测试代码9K, 也就是说测试源码仅5k左右, 具 ...
- react-native 常见问题
1.webpack使用babel-loader后编译报错 报错ERROR in ./entry.js Module build failed: SyntaxError: /Users/yixin/De ...
- .net npoi读word内容+目录
最近在做读npoi文档存入搜索引擎,实现快速查询word文档中内容并展示,效果希望带有目录导航. 网上有很多例子都是读写操作,很肤浅没有具体读到想要的东西所以自己就写了个demo,也有微软提供的off ...