
Python爬虫爬取百度翻译之数据提取方法json
工具:Python 3.6.5、PyCharm开发工具、Windows 10 操作系统
说明:本例为实现输入中文翻译为英文的小程序,适合Python爬虫的初学者一起学习,感兴趣的可以做英文翻译为中文的功能,如单词查询功能等。推荐使用谷歌浏览器或火狐浏览器检查元素。使用之前需要先安装模块:pip install request pip install json。
数据提取方法:json
1、数据交换格式,看起来像Python类型(列表,字典)的字符串
2、使用json之前需要导入
3、json.loads
(1)、把json字符串转化为Python类型
(2)、json.loads(json字符串)
4、json.dumps
(1)、把Python类型转化为json字符串
(2)、json.dumps({})
(3)、json.dumps(ret1,ensure_ascii=False,indent=2)
ensure_ascii让中文显示成中文
indent:能够让下一行在上一行的基础上空格
代码:
 import requests

 import json

 url = "https://fanyi.baidu.com/basetrans"

 query_str = input("请输入要翻译的中文:")

 data = {

         "query":query_str,

         "from":"zh",

         "to":"en"}

 headers = {

         "User-Agent": "Mozilla/5.0 (iPhone; CPU iPhone OS 11_0 like Mac OS X) AppleWebKit/604.1.38 (KHTML, like Gecko) Version/11.0 Mobile/15A372 Safari/604.1",

         "Referer": "https://fanyi.baidu.com/?aldtype=16047&tpltype=sigma"

 }

 response = requests.post(url,data=data,headers=headers)

 html_str = response.content.decode()#json字符串

 #json数据交换格式,使用json之前需要导入

 #把json字符串转化为Python类型

 dict_ret = json.loads(html_str)

 #print(dict_ret)

 #print(type(dict_ret))

 ret = dict_ret["trans"][0]["dst"]

 print("翻译结果是:",ret)
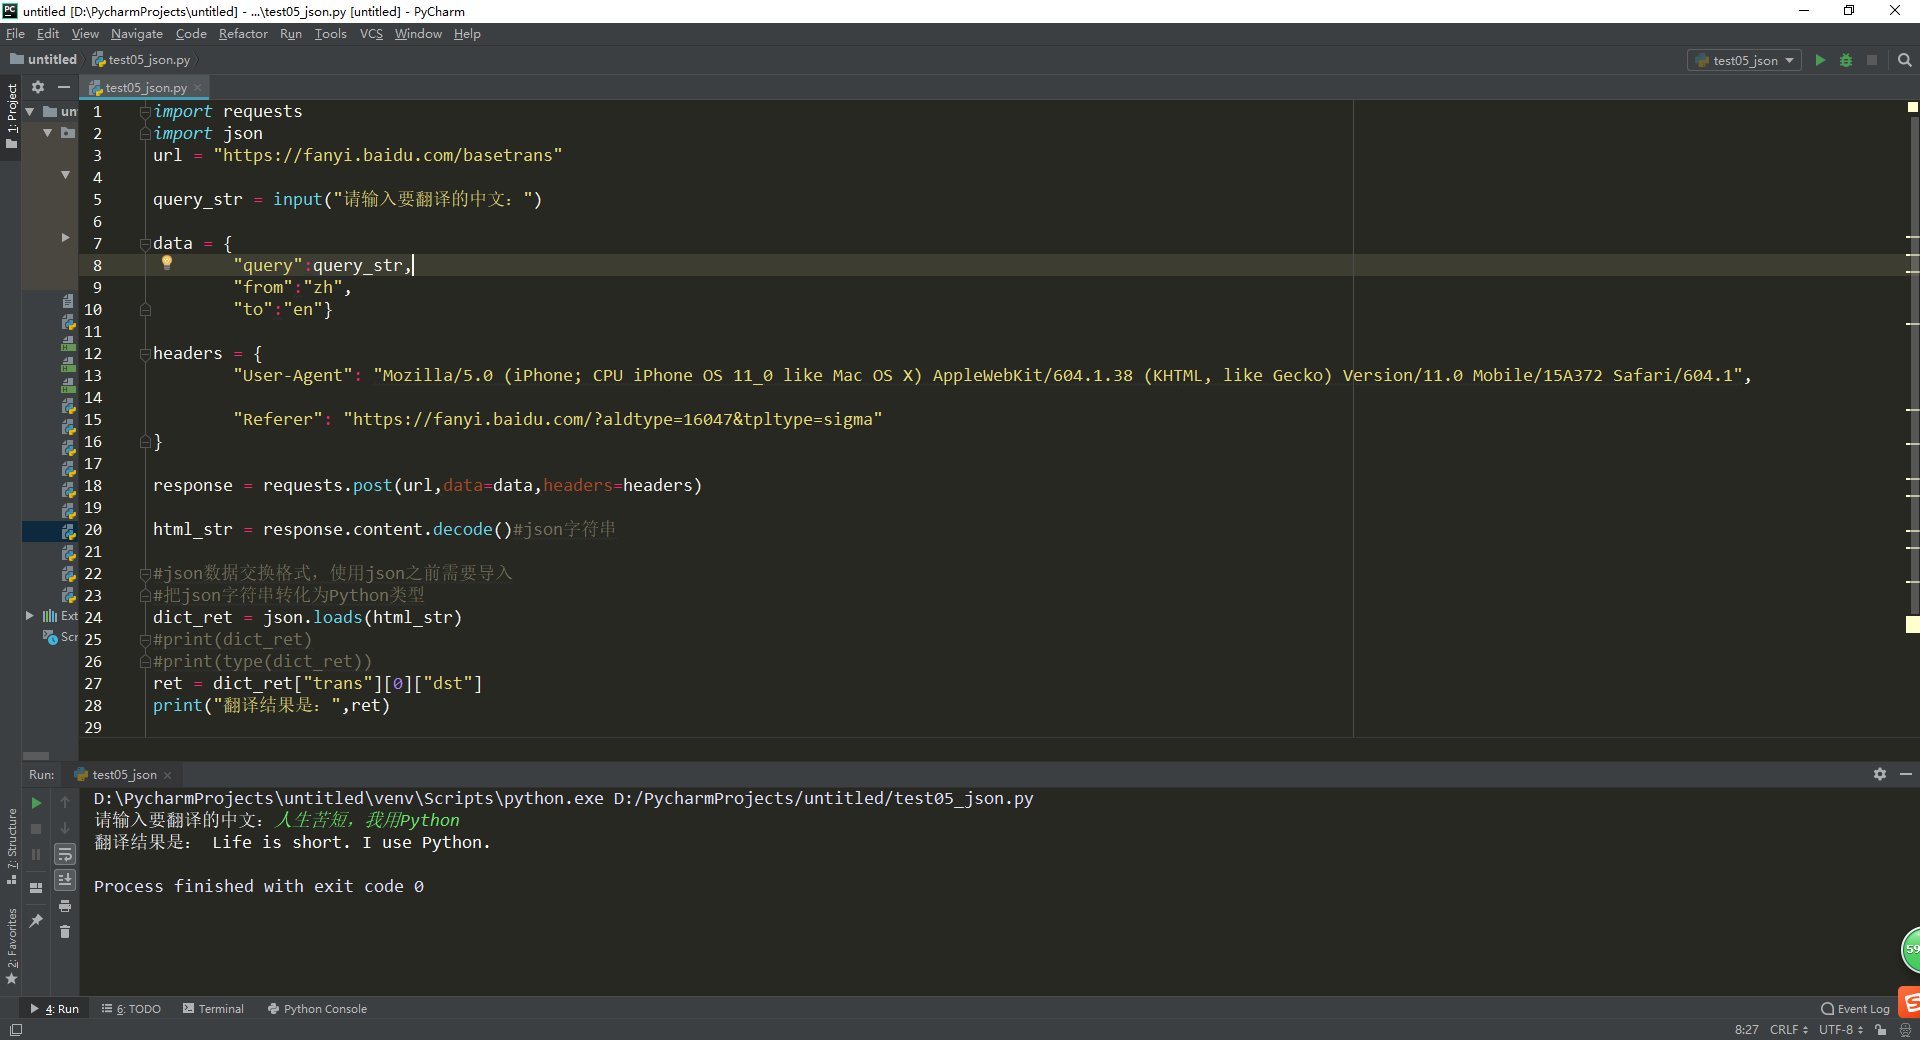
运行效果:
Python爬虫爬取百度翻译之数据提取方法json的更多相关文章
- python --爬虫--爬取百度翻译
import requestsimport json class baidufanyi: def __init__(self, trans_str): self.lang_detect_url = ' ...
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- 写一个python 爬虫爬取百度电影并存入mysql中
目标是利用python爬取百度搜索的电影 在类型 地区 年代各个标签下 电影的名字 评分 和图片连接 以及 电影连接 首先我们先在mysql中建表 create table liubo4( id in ...
- python爬虫—爬取百度百科数据
爬虫框架:开发平台 centos6.7 根据慕课网爬虫教程编写代码 片区百度百科url,标题,内容 分为4个模块:html_downloader.py 下载器 html_outputer.py 爬取数 ...
- Python爬虫爬取百度贴吧的帖子
同样是参考网上教程,编写爬取贴吧帖子的内容,同时把爬取的帖子保存到本地文档: #!/usr/bin/python#_*_coding:utf-8_*_import urllibimport urlli ...
- Python爬虫爬取百度贴吧的图片
根据输入的贴吧地址,爬取想要该贴吧的图片,保存到本地文件夹,仅供参考: #!/usr/bin/python#_*_coding:utf-8_*_import urllibimport urllib2i ...
- Python爬虫爬取豆瓣电影之数据提取值xpath和lxml模块
工具:Python 3.6.5.PyCharm开发工具.Windows 10 操作系统.谷歌浏览器 目的:爬取豆瓣电影排行榜中电影的title.链接地址.图片.评价人数.评分等 网址:https:// ...
- Python爬虫-爬取百度贴吧帖子
这次主要学习了替换各种标签,规范格式的方法.依然参考博主崔庆才的博客. 1.获取url 某一帖子:https://tieba.baidu.com/p/3138733512?see_lz=1&p ...
随机推荐
- t d x 示例z
using System; using System.Collections.Generic; using System.Linq; using System.Runtime.InteropServi ...
- selenium:IE浏览器获取cookie提示Could not retrieve cookies
from selenium import webdriver url = "https://www.baidu.com" dr = webdriver.Ie() dr.get(ur ...
- python+requests+json 接口测试思路示例
实际项目中用python脚本实现接口测试的步骤: 1 发送请求,获取响应 >>2 提取响应里的数据,对数据进行必要的处理 >>3 断言响应数据是否与预期一致 以豆瓣接口为例 ...
- What is a Thread?
https://computing.llnl.gov/tutorials/pthreads/ Technically, a thread is defined as an independent st ...
- LA 4256 商人
题目链接:https://vjudge.net/contest/160916#problem/B 题意:给一个无向图,和一个序列:要求,在这个序列中,两两相连的两个数相同,或者,在无向图中相邻:(n& ...
- AFN 切换BaseUrl
在某个特定的接口需要修改baseurl时: 直接使用kvc: [_sessionManager setValue:[NSURL URLWithString:NEW_BASE_URL] forKey:@ ...
- 【转】android ListView详解
由于google doc 很多人都打不开,故更新了源码下载地址 [源码下载]----2011-01-18 在android开发中ListView是比较常用的组件,它以列表的形式展示具体内容,并且能够根 ...
- Let’s Encrypt 最近很火的免费SSL 使用教程
2015年10月份,微博上偶然看到Let's Encrypt 推出了beta版,作为一个曾经被https虐出血的码农来说,这无疑是一个重磅消息.并且在全站Https的大趋势下,Let's Encryp ...
- 行云管家V4.9正式发布:监控全面提升,首页、主机详情大幅优化,新增大量实用功能.md
让大家久等啦!4.9版本中我们对监控模块进行了重构,在数据准确性与稳定性方面做了大幅提升.我们也对首页及主机详情页面做了大幅重构,以追求为您提供极致的用户体验.同时我们在新版本中增加了如:运维报表.用 ...
- 关于node-sass安装失败的解决办法
在测试gulp-webapp的时候遇到了 styles 不能被正常编译的问题,究其原因是node-sass没有被正常安装. 根本原因是国内网络的原因. 最终的解决方法是通过淘宝的npm镜像安装node ...