
HDFS中DataNode工作机制
1.DataNode工作机制
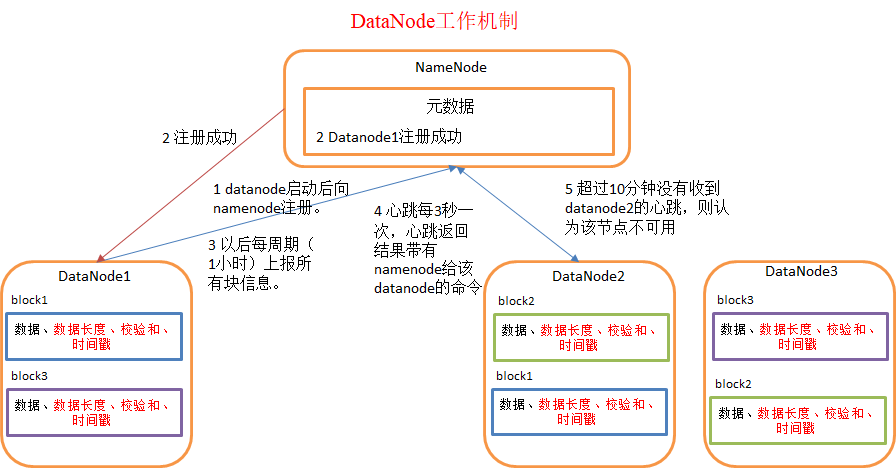
1)一个数据块在datanode上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据(包括数据块的长度,块数据的校验和,以及时间戳)。
2)DataNode启动后向namenode注册,通过后,周期性(1小时)的向namenode上报所有的块信息。
3)心跳是每3秒一次,心跳返回结果带有namenode给该datanode的命令如复制块数据到另一台机器,或删除某个数据块。如果超过10分钟没有收到某个datanode的心跳,则认为该节点不可用。
4)集群运行中可以安全加入和退出一些机器。
2.数据完整性
1)当DataNode读取block的时候,它会计算checksum
2)如果计算后的checksum,与block创建时值不一样,说明block已经损坏。
3)client读取其他DataNode上的block.
4)datanode在其文件创建后周期验证checksum
3.DataNode掉线时限参数设置
datanode进程死亡或者网络故障造成datanode无法与namenode通信,namenode不会立即把该节点判定为死亡,要经过一段时间,这段时间暂称作超时时长。HDFS默认的超时时长为10分钟+30秒。如果定义超时时间为timeout,则超时时长的计算公式为:
timeout = 2 * dfs.namenode.heartbeat.recheck-interval + 10 * dfs.heartbeat.interval
而默认的dfs.namenode.heartbeat.recheck-interval 大小为5分钟,dfs.heartbeat.interval默认为3秒。
需要注意的是hdfs-site.xml 配置文件中的heartbeat.recheck.interval的单位为毫秒,dfs.heartbeat.interval的单位为秒。
<property>

    <name>dfs.namenode.heartbeat.recheck-interval</name>

    <value>300000</value>

</property>

<property>

    <name> dfs.heartbeat.interval </name>

    <value>3</value>

</property>
1
)当DataNode读取block的时候,它会计算checksum
2)如果计算后的checksum,与block创建时值不一样,说明block已经损坏。
3)client读取其他DataNode上的block.
4)datanode在其文件创建后周期验证checksum
HDFS中DataNode工作机制的更多相关文章
- hdfs namenode/datanode工作机制
一. namenode工作机制 1. 客户端上传文件时,namenode先检查有没有同名的文件,如果有,则直接返回错误信息.如果没有,则根据要上传文件的大小以及block的大小,算出需要分成几个blo ...
- HDFS中NameNode工作机制
引言 NameNode: 存储元数据 管理整个HDFS集群 DataNode: 存储数据的block SecondaryNameNode: 辅助HDFS完成一些事情 NameNode和Secondar ...
- DataNode 工作机制
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明.本文链接:https://blog.csdn.net/qq_35641192/article/d ...
- Hadoop(五)—— HDFS NameNode、DataNode工作机制
一.NN与2NN工作机制 NameNode(NN) 1.当HDFS启动时,会加载日志(edits)和镜像文件(fsImage)到内存中. 2-4.当元数据的增删改查请求进来时,NameNode会先将操 ...
- HDFS中DataNode的心跳机制
DataNode心跳机制的作用讲解了DataNode的三个作用: register:当DataNode启动的时候,DataNode需要将自身的一些信息(hostname, version等)告诉Nam ...
- hdfs的datanode工作原理
datanode的作用: (1)提供真实文件数据的存储服务. (2)文件块(block):最基本的存储单位.对于文件内容而言,一个文件的长度大小是size,那么从文件的0偏移开始,按照固定的大小,顺序 ...
- Hadoop_10_HDFS 的 DataNode工作机制
1.DataNode的工作机制: 1.DataNode工作职责:存储管理用户的文件块数据 定期向namenode汇报自身所持有的block信息(通过心跳信息上报) (这点很重要,因为,当集群中发生某 ...
- Hadoop框架:DataNode工作机制详解
本文源码:GitHub·点这里 || GitEE·点这里 一.工作机制 1.基础描述 DataNode上数据块以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是数据块元数据包括长度.校验.时 ...
- HDFS成员的工作机制
NameNode工作机制 nn负责管理块的元数据信息,元数据信息为fsimage和edits预写日志,通过edits预写日志来更新fsimage中的元数据信息,每次namenode启动时,都会将磁盘中 ...
随机推荐
- 软件工程大作业(学生会管理系统)Web端个人总结报告
软件工程大作业(学生会管理系统)Web端个人总结报告 一.小组信息 1.所在小组:第二组 2.小组选题:学生会管理系统 3.项目源代码链接: Web端源代码:code 小程序端源代码:code APP ...
- Laravel——缓存使用
1.使用Redis类 use Illuminate\Support\Facades\Redis; 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 ...
- postman(一):详解在postman中使用环境变量
一.定义环境变量 添加环境分支 添加环境变量 切换环境分支 使用脚本设置环境变量 设置集合级别的变量 二.使用环境变量 使用{{变量名称}}的形式引用环境变量. 注:变量可以用在URL,请求参数,请求 ...
- Flask【第4篇】:用Flask的扩展实现的简单的页面登录
用flask的扩展实现的简单的页面登录 from flask import Flask,render_template,request,redirect,session app = Flask(__n ...
- man gzip
GZIP(1) GZIP(1) NAME/名称 gzip, g ...
- twint 安装及使用
分享这个post是自己方便查,还有中文网界对这个东西介绍太少. 更多的就看github项目twint吧. Installation: git+pip3: git clone https://githu ...
- 前端面试题常考&必考之--清除浮动的方法
浮动 问题:子元素设置了float后,脱离父元素,导致父元素无法撑开?(也就是子元素的高度没有过渡到父元素) 例子: 检查元素的效果: (三种)常用的解决办法: 1>额外标签法,添加一个空的di ...
- 阿里云服务器不能使用apt-get
因为阿里云使用的是自己的源.所以在/etc/apt/sources.list中加上: deb cdrom:[Ubuntu 16.04.3 LTS _Xenial Xerus_ - Release am ...
- Linux内核设计与实现 总结笔记(第十三章)虚拟文件系统
一.通用文件系统接口 Linux通过虚拟文件系统,使得用户可以直接使用open().read().write()访问文件系统,这种协作性和泛型存取成为可能. 不管文件系统是什么,也不管文件系统位于何种 ...
- Bugku 杂项 telnet
letnet 下载zip后发现是一个数据包,放到wireshark中打开 右键追踪tcp流后可以发现flag