
Hadoop(五)—— HDFS NameNode、DataNode工作机制
一、NN与2NN工作机制
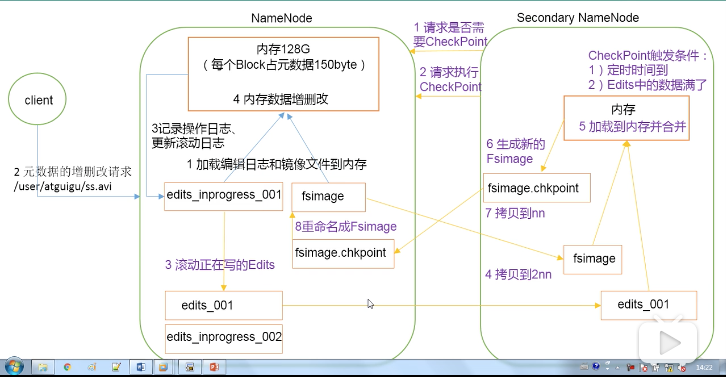
NameNode(NN)
1、当HDFS启动时,会加载日志(edits)和镜像文件(fsImage)到内存中。
2-4、当元数据的增删改查请求进来时,NameNode会先将操作记录到日志中,之后再执行内存数据的增删改查
SecondNameNode(2NN)
1、SecondNameNode请求NameNode,请求是否需要checkPoint,checkPoint的触发条件:
- 定时时间到
- 日志文件满了
2-6、请求checkPoint,会将最近写的edits和fsImage拷贝到SecondNameNode本地,加载到内存中合并,生成fsImage.checkpoint。
7-8 将fsImage.checkpoint拷贝到NameNode,并更名为fsImage
二、Fs Image与Edits解析
到/usr/local/hadoop/Hadoop_tmp/dfs/name/current查看日志和fsImage

查看fsImage
hdfs oiv -p XML -i fsimage_0000000000000000131 -o fsimage.xml
得到结果
<?xml version="1.0"?>

<fsimage><NameSection>

<genstampV1>1000</genstampV1><genstampV2>1006</genstampV2><genstampV1Limit>0</genstampV1Limit><lastAllocatedBlockId>1073741829</lastAllocatedBlockId><txid>131</txid></NameSection>

<INodeSection><lastInodeId>16424</lastInodeId><inode><id>16385</id><type>DIRECTORY</type><name></name><mtime>1576421043641</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>9223372036854775807</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16386</id><type>DIRECTORY</type><name>fzj</name><mtime>1575714994678</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16387</id><type>DIRECTORY</type><name>jiagoushi</name><mtime>1575714994678</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16392</id><type>DIRECTORY</type><name>tmp</name><mtime>1576021083427</mtime><permission>fangzhijie:supergroup:rwx-wx-wx</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16393</id><type>DIRECTORY</type><name>hive</name><mtime>1576021083443</mtime><permission>fangzhijie:supergroup:rwx-wx-wx</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16394</id><type>DIRECTORY</type><name>fangzhijie</name><mtime>1576022280367</mtime><permission>fangzhijie:supergroup:rwx------</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16411</id><type>DIRECTORY</type><name>user</name><mtime>1576021954868</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16412</id><type>DIRECTORY</type><name>hive</name><mtime>1576021954868</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16413</id><type>DIRECTORY</type><name>warehouse</name><mtime>1576021954868</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16414</id><type>DIRECTORY</type><name>bigdata</name><mtime>1576021954868</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16417</id><type>DIRECTORY</type><name>test</name><mtime>1576326634124</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16418</id><type>DIRECTORY</type><name>hdfs</name><mtime>1576327378643</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16419</id><type>DIRECTORY</type><name>client</name><mtime>1576326634124</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16420</id><type>DIRECTORY</type><name>client1</name><mtime>1576327180252</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16421</id><type>DIRECTORY</type><name>client2</name><mtime>1576327378643</mtime><permission>fangzhijie:supergroup:rwxr-xr-x</permission><nsquota>-1</nsquota><dsquota>-1</dsquota></inode>

<inode><id>16422</id><type>FILE</type><name>hdfs-test123456.xml</name><replication>3</replication><mtime>1576327781065</mtime><atime>1576327780439</atime><perferredBlockSize>134217728</perferredBlockSize><permission>fangzhijie:supergroup:rw-r--r--</permission><blocks><block><id>1073741827</id><genstamp>1004</genstamp><numBytes>878</numBytes></block>

</blocks>

</inode>

<inode><id>16423</id><type>FILE</type><name>hdfs-test123.xml</name><replication>2</replication><mtime>1576418894630</mtime><atime>1576418893994</atime><perferredBlockSize>134217728</perferredBlockSize><permission>fangzhijie:supergroup:rw-r--r--</permission><blocks><block><id>1073741828</id><genstamp>1005</genstamp><numBytes>878</numBytes></block>

</blocks>

</inode>

</INodeSection>

<INodeReferenceSection></INodeReferenceSection><SnapshotSection><snapshotCounter>0</snapshotCounter></SnapshotSection>

<INodeDirectorySection><directory><parent>16385</parent><inode>16386</inode><inode>16423</inode><inode>16422</inode><inode>16417</inode><inode>16392</inode><inode>16411</inode></directory>

<directory><parent>16386</parent><inode>16387</inode></directory>

<directory><parent>16392</parent><inode>16393</inode></directory>

<directory><parent>16393</parent><inode>16394</inode></directory>

<directory><parent>16411</parent><inode>16412</inode></directory>

<directory><parent>16412</parent><inode>16413</inode></directory>

<directory><parent>16413</parent><inode>16414</inode></directory>

<directory><parent>16417</parent><inode>16418</inode></directory>

<directory><parent>16418</parent><inode>16419</inode><inode>16420</inode><inode>16421</inode></directory>

</INodeDirectorySection>

<FileUnderConstructionSection></FileUnderConstructionSection>

<SnapshotDiffSection><diff><inodeid>16385</inodeid></diff></SnapshotDiffSection>

<SecretManagerSection><currentId>0</currentId><tokenSequenceNumber>0</tokenSequenceNumber></SecretManagerSection><CacheManagerSection><nextDirectiveId>1</nextDirectiveId></CacheManagerSection>

</fsimage>
查看日志文件
hdfs oev -p XML -i edits_0000000000000000130-0000000000000000131 -o edits.xml
得到结果
<?xml version="1.0" encoding="UTF-8"?>

<EDITS>

  <EDITS_VERSION>-63</EDITS_VERSION>

  <RECORD>

    <OPCODE>OP_START_LOG_SEGMENT</OPCODE>

    <DATA>

      <TXID>130</TXID>

    </DATA>

  </RECORD>

  <RECORD>

    <OPCODE>OP_END_LOG_SEGMENT</OPCODE>

    <DATA>

      <TXID>131</TXID>

    </DATA>

  </RECORD>

</EDITS>
三、NameNode故障处理
方案一
kill掉NameNode进程
将SecondNameNode的数据拷贝到NameNode中
重启NameNode
方案二
使用-importCheckpoint选项启动NameNode守护进程,从而将SecondNameNode中数据拷贝到NameNode目录中。
kill -9 NameNode
删除NameNode存储的数据
将SecondNameNode的数据拷贝到NameNode中
四、安全模式
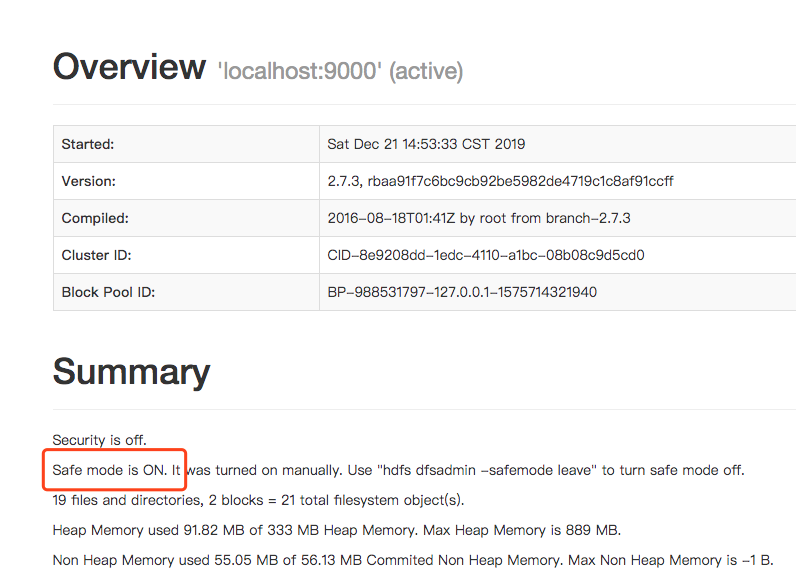
NameNode进入安全模式的话,文件系统是只读的。
如何判断是否是进入安全模式
▶ ./hdfs dfsadmin -safemode get

19/12/21 23:44:39 WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable

Safe mode is OFF
进入安全模式
local/hadoop/bin

▶ ./hdfs dfsadmin -safemode enter

19/12/21 23:53:50 WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable

Safe mode is ON
退出安全模式
./hdfs dfsadmin -safemode leave
等待安全模式
./hdfs dfsadmin -safemode wait
等待的意思是,在安全模式状态是ON的时候,阻塞,直到状态变为OFF,阻塞才取消,开始执行后续的操作。
五、NameNode 高可用
dir
六、NameNode的ZKFC机制
dir
七、数据完整性
循环冗余校验(CRC)码
使用CRC校验码来保证数据的完整性。
CRC 算法的基本思想:将传输的数据当做一个位数很长的数。将这个数除以另一个数。得到的余数作为校验数据附加到原数据后面。
CRC码中,校验位(R位)在信息位(K位)后面.
例如,CRC生成多项式为G(X) = X4 + X + 1,要求出二进制序列10110011的CRC校验码。
多项式对应的二进制为10011
10011 为除数,10110011为被除数,按照异或的计算方式,同为0,异为1,则计算过程如下:
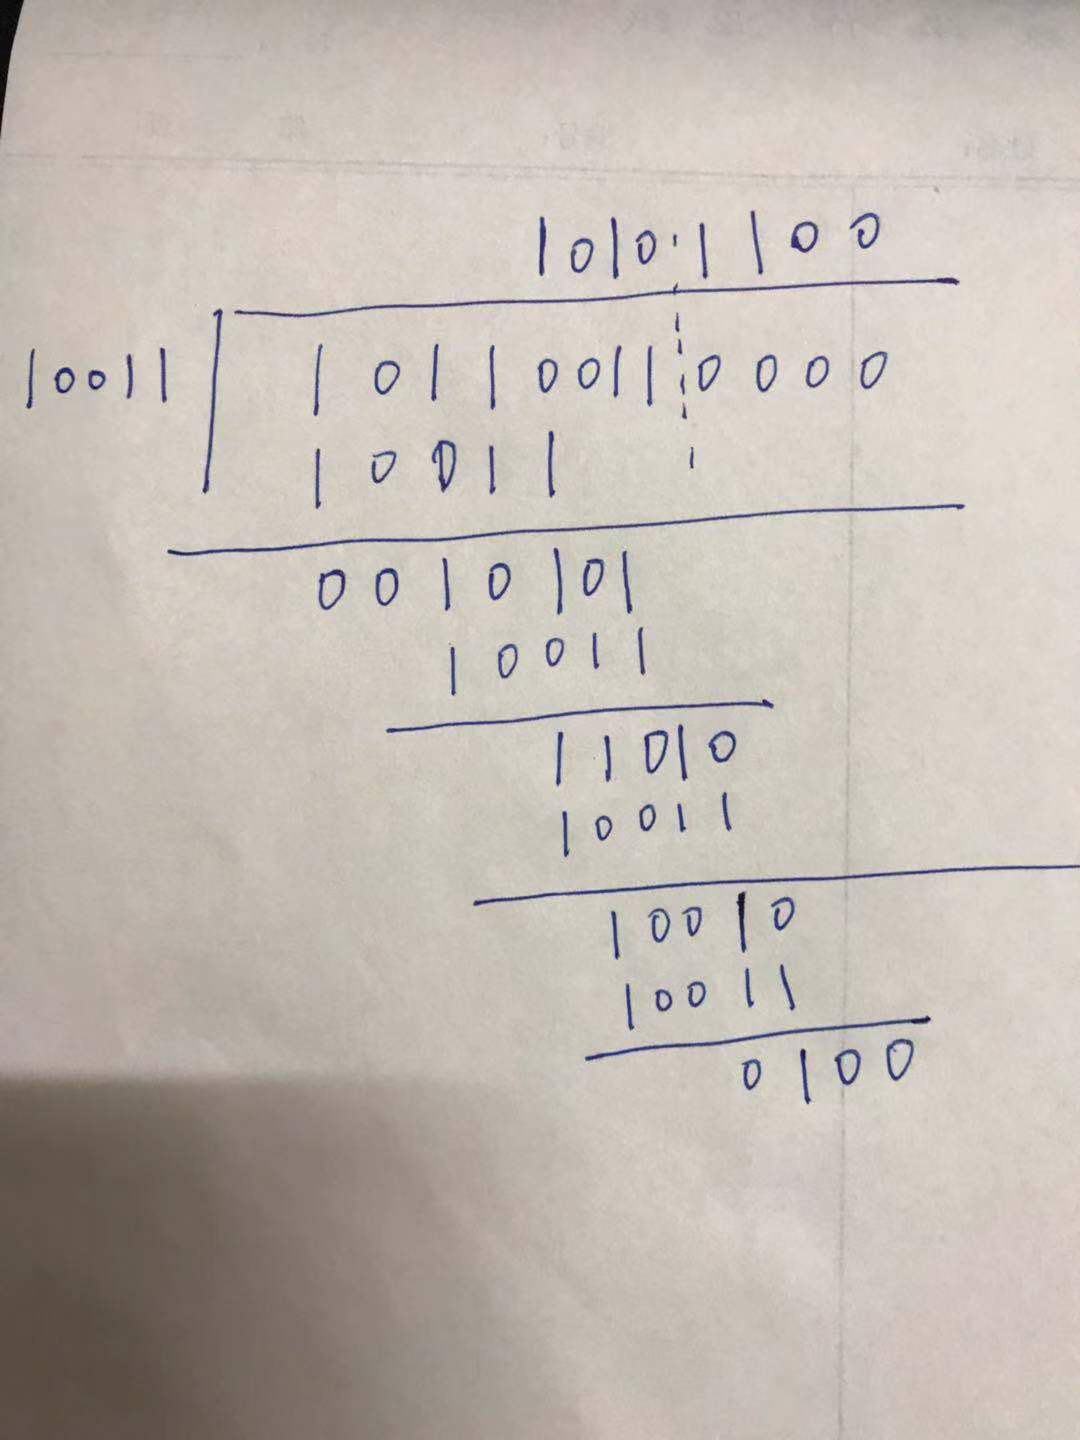
最后得到余数0100,即是校验位。那么整个CRC码为:10110011 0100
参考文档
循环冗余校验(CRC)码
HDFS:NameNode的Proxy该怎样做
字节跳动 EB 级 HDFS 实践
Hadoop(五)—— HDFS NameNode、DataNode工作机制的更多相关文章
- hdfs namenode/datanode工作机制
一. namenode工作机制 1. 客户端上传文件时,namenode先检查有没有同名的文件,如果有,则直接返回错误信息.如果没有,则根据要上传文件的大小以及block的大小,算出需要分成几个blo ...
- HDFS中DataNode工作机制
1.DataNode工作机制 1)一个数据块在datanode上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据(包括数据块的长度,块数据的校验和,以及时间戳). 2)DataNod ...
- HDFS Namenode&Datanode
HDFS Namenode&Datanode HDFS 机制粗略示意图 客户端写入文件流程: NN && DN Namenode(NN)工作机制 NN是整个文件系统的管理节点. ...
- DataNode 工作机制
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明.本文链接:https://blog.csdn.net/qq_35641192/article/d ...
- Hadoop(10)-HDFS的DataNode详解
1.DataNode工作机制 1)一个数据块在DataNode上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据包括数据块的长度,块数据的校验和,以及时间戳. 2)DataNode启 ...
- Hadoop框架:DataNode工作机制详解
本文源码:GitHub·点这里 || GitEE·点这里 一.工作机制 1.基础描述 DataNode上数据块以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是数据块元数据包括长度.校验.时 ...
- Hadoop:HDFS NameNode内存全景
原文转自:https://tech.meituan.com/namenode.html 感谢原作者 一.概述 从整个HDFS系统架构上看,NameNode是其中最重要.最复杂也是最容易出现问题的地方, ...
- hdfs的datanode工作原理
datanode的作用: (1)提供真实文件数据的存储服务. (2)文件块(block):最基本的存储单位.对于文件内容而言,一个文件的长度大小是size,那么从文件的0偏移开始,按照固定的大小,顺序 ...
- Hadoop_10_HDFS 的 DataNode工作机制
1.DataNode的工作机制: 1.DataNode工作职责:存储管理用户的文件块数据 定期向namenode汇报自身所持有的block信息(通过心跳信息上报) (这点很重要,因为,当集群中发生某 ...
随机推荐
- Springboot html vue.js 前后分离 跨域 Activiti6 工作流 集成代码生成器 shiro 权限
官网:www.fhadmin.org 特别注意: Springboot 工作流 前后分离 + 跨域 版本 (权限控制到菜单和按钮) 后台框架:springboot2.1.2+ activiti6.0 ...
- Weak Session IDs
工具的使用 首先github上下载火狐插件(正版收费),按F12调用 服务器生成sessionID通过response返回给浏览器,sessionID存放在浏览器cookie中,然后再通过cookie ...
- Tensorflow替换静态图中的OP
import tensorflow as tf import collections from tensorflow.core.framework import tensor_shape_pb2 # ...
- XML整形以及改行字符串输出
XML整形 估计如下一样使用XDocument的人比较多,毕竟也是微软推荐使用的. string FormatXml(string Xml) { try { XDocument doc = XDocu ...
- 学习操作系统和Linux内核的新体会
算起来是第三次看内核了吧,要从源码的细节中爬出来: (1)先拎清楚主要的数据结构,就把握住了骨架: (2)再看每个系统调用的功能的流程是如何围绕上述数据结构展开.举个栗子,块设备驱动层的主要数据结构有 ...
- PHP生成小程序二维码
/** * [生成小程序二维码] * @return [type] [description] */ public function makeMiniQrcode_do() { begin: $id ...
- Keystore Problem: Cannot convert COMBINED of type class java.lang.String to class org.jivesoftware.openfire.spi.ConnectionType
go to: Server Manager -> System Properties Search for "xmpp.socket.ssl.client.keypass" ...
- Mac系统安装JDK
MAC 安装 JDK: 这篇文章主要为在MAC苹果系统下安装JDK1.8并配置系统环境变量. 主要分为以下步骤: 到Oracle官网下载JDK1.8安装包. 打开获取到的安装包按步骤安装到系统上. 配 ...
- linux文件常用操作
建立目录:mkdir mkdir -p [目录名] -p 递归创建 命令英文原意: make directories 切换所在目录:cd cd [目录] cd ~ 进入当前用户的家目录 cd c ...
- idea中新增package总是嵌套的解决方法
在idea中创建package,为了方便会将com.xx.xx作为一个package,下面添加对应的子package.比如service,config等.但是当我创建是总是会嵌套在下面变成了com.x ...