
Python爬取猫眼电影100榜并保存到excel表格
首先我们前期要导入的第三方类库有;

通过猫眼电影100榜的源码可以看到很有规律 如:

亦或者是:
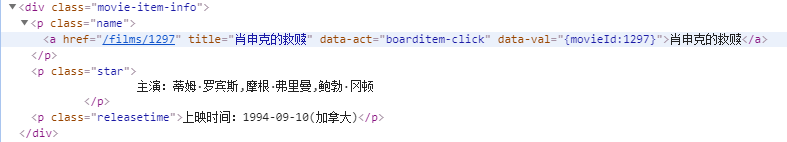
根据规律我们可以得到非贪婪的正则表达式
"""<div class="movie-item-info">.*?title="(.*?)".*?class="star">(.*?)</p>.*?releasetime">(.*?)</p>"""
之后我们观察网页地址(url)的变化规律:
这是第一页的网址: https://maoyan.com/board/4?offset=0
这是第二页的网址: https://maoyan.com/board/4?offset=10
这是第三页的网址: https://maoyan.com/board/4?offset=20
可以见的网页变化规律为:(当前页数-1)*10 即为:(N-1)*10
之后下面进行爬取
 from urllib import request

 import random

 import time

 import csv

 import re

 import xlwt

 class catEyesMovie:

     def __init__(self):

         self.url = 'https://maoyan.com/board/4?offset={}'

         self.ua_list = [

             'Win7:Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/535.1 (KHTML, like Gecko) Chrome/14.0.835.163 Safari/535.1'

         ]

         self.line = 1;

             #'User-Agent': 'Win7:Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/535.1 (KHTML, like Gecko) Chrome/14.0.835.163 Safari/535.1'

     #获取网页内容

     def get_page(self,url):

         #使用随机的user-agent

         headers = {'User-Agent':random.choice(self.ua_list)}

         #创建请求对象

         req = request.Request(url=url,headers=headers)

         #发送请求

         res = request.urlopen(req)

         #获取相应对象

         html = res.read().decode('utf-8','ignore')

         return html

     #清洗数据

     def clean_page(self,html,xwlt):

         pattern = re.compile("""<div class="movie-item-info">.*?title="(.*?)".*?class="star">(.*?)</p>.*?releasetime">(.*?)</p>""", re.S)

         r_list = pattern.findall(html)

         self.write_page(r_list,xwlt)

     #保存内容

     def write_page(self,r_list,xwlt):

         one_film_dict = {}

         for rt in r_list:

             xwlt.write(self.line,0,rt[0].strip())

             xwlt.write(self.line,1,rt[1].strip())

             xwlt.write(self.line,2,rt[2].strip())

             self.line+=1

     def main(self,xwlt):

         #凭借字符串

         res = []

         for i in range(1,11):

             #拼接url地址 https://maoyan.com/board/4?offset={}

             #获取当前页数

             offset = (i-1)*10

             url = self.url.format(offset)

             html = self.get_page(url)

             self.clean_page(html,xwlt)

 if __name__ == '__main__':

     start = time.time()

     spider = catEyesMovie()

     #创建一个xlwt对象

     book = xlwt.Workbook(encoding='utf-8')

     #创建sheet,Sheet1为表的名字,cell_overwirite_ok为是否覆盖单元格

     sheet1 = book.add_sheet(u'Sheet1',cell_overwrite_ok=True)

     #进行第一行标题定义

     sheet1.write(0,0,'电影名称')

     sheet1.write(0,1,'主演')

     sheet1.write(0,2,'上映时间')

     #进行爬取

     spider.main(sheet1)

     book.save('D:\\write.xls')

     end = time.time()

     print('执行时间为: %.2f' % (end-start))
每次爬取到的数据结构为:
 {'电影名称': '速度与激情5', '主演': '速度与激情5', '上映时间': '速度与激情5'}

 {'电影名称': '驯龙高手', '主演': '驯龙高手', '上映时间': '驯龙高手'}

 {'电影名称': '勇敢的心', '主演': '勇敢的心', '上映时间': '勇敢的心'}

 {'电影名称': '闻香识女人', '主演': '闻香识女人', '上映时间': '闻香识女人'}

 {'电影名称': '神偷奶爸', '主演': '神偷奶爸', '上映时间': '神偷奶爸'}
完成后的excel表格如下:

仅供学习!!
Python爬取猫眼电影100榜并保存到excel表格的更多相关文章
- 爬虫系列(1)-----python爬取猫眼电影top100榜
对于Python初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天在整理代码时,整理了一下之前自己学习爬虫的一些代码,今天先上一个简单的例子,手把手教你入门Python爬虫,爬取 ...
- 50 行代码教你爬取猫眼电影 TOP100 榜所有信息
对于Python初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天,恋习Python的手把手系列,手把手教你入门Python爬虫,爬取猫眼电影TOP100榜信息,将涉及到基础爬虫 ...
- 40行代码爬取猫眼电影TOP100榜所有信息
主要内容: 一.基础爬虫框架的三大模块 二.完整代码解析及效果展示 1️⃣ 基础爬虫框架的三大模块 1.HTML下载器:利用requests模块下载HTML网页. 2.HTML解析器:利用re正则表 ...
- python 爬取猫眼电影top100数据
最近有爬虫相关的需求,所以上B站找了个视频(链接在文末)看了一下,做了一个小程序出来,大体上没有修改,只是在最后的存储上,由txt换成了excel. 简要需求:爬虫爬取 猫眼电影TOP100榜单 数据 ...
- Python 爬取猫眼电影最受期待榜
主要爬取猫眼电影最受期待榜的电影排名.图片链接.名称.主演.上映时间. 思路:1.定义一个获取网页源代码的函数: 2.定义一个解析网页源代码的函数: 3.定义一个将解析的数据保存为本地文件的函数: ...
- Python爬虫项目--爬取猫眼电影Top100榜
本次抓取猫眼电影Top100榜所用到的知识点: 1. python requests库 2. 正则表达式 3. csv模块 4. 多进程 正文 目标站点分析 通过对目标站点的分析, 来确定网页结构, ...
- Requests+正则表达式爬取猫眼电影(TOP100榜)
猫眼电影网址:www.maoyan.com 前言:网上一些大神已经对猫眼电影进行过爬取,所用的方法也是各有其优,最终目的是把影片排名.图片.名称.主要演员.上映时间与评分提取出来并保存到文件或者数据库 ...
- python实战项目 — 使用bs4 爬取猫眼电影热榜(存入本地txt、以及存储数据库列表)
案例一: 重点: 1. 使用bs4 爬取 2. 数据写入本地 txt from bs4 import BeautifulSoup import requests url = "http:// ...
- 使用requests爬取猫眼电影TOP100榜单
Requests是一个很方便的python网络编程库,用官方的话是"非转基因,可以安全食用".里面封装了很多的方法,避免了urllib/urllib2的繁琐. 这一节使用reque ...
随机推荐
- bluetooth(蓝牙) AVRCP协议概念及代码流程解析
一 概念 AVRCP全称:The Audio/Video Remote Control Profile (AVRCP) 翻译成中文就是:音视频远程控制协议.概念:AVRCP定义了蓝牙设备之间的音视频传 ...
- JS 延时函数
function sleep(delay) { var start = (new Date()).getTime(); while((new Date()).getTime() - start < ...
- Windows认证 | Windows本地认证
Windows的登陆密码是储存在系统本地的SAM文件中的,在登陆Windows的时候,系统会将用户输入的密码与SAM文件中的密码进行对比,如果相同,则认证成功. SAM文件是位于%SystemRoot ...
- (java实现)顺序表-ArrayList
什么是顺序表 顺序表是在计算机内存中以数组的形式保存的线性表,是指用一组地址连续的存储单元依次存储数据元素的线性结构. 在使用顺序表存储数据前,会先申请一段连续的内存空间(即数组),然后把数组依次存入 ...
- 手把手教你搭建Pytest+Allure2.X环境详细教程,生成让你一见钟情的测试报告(非常详细,非常实用)
简介 宏哥之前在做接口自动化的时候,用的测试报告是HTMLTestRunner,虽说自定义模板后能满足基本诉求,但是仍显得不够档次,高端,大气,遂想用其他优秀的report框架替换之.一次偶然的机会, ...
- springboot全局异常拦截源码解读
在springboot中我们可以通过注解@ControllerAdvice来声明一个异常拦截类,通过@ExceptionHandler获取拦截类抛出来的具体异常类,我们可以通过阅读源码并debug去解 ...
- Spring Security 梳理 - session
Spring Security默认的行为是每个登录成功的用户会新建一个Session.这也就是下面的配置的效果: <http create-session="ifRequired&qu ...
- <机器学习>无监督学习算法总结
本文仅对常见的无监督学习算法进行了简单讲述,其他的如自动编码器,受限玻尔兹曼机用于无监督学习,神经网络用于无监督学习等未包括.同时虽然整体上分为了聚类和降维两大类,但实际上这两类并非完全正交,很多地方 ...
- ArcGIS Server10.1 动态图层服务
动态图层的应用场景: 1 改变现有图层:符号,渲染方式和版本,这些都可以通过客户端请求的时候给定相应的参数来进行设置,从而来达到轻易改变地图的效果. 2 添加地图服务中没有的图层 添加的数据可以是矢量 ...
- linux 装composer的出现的问题
curl -sS https://getcomposer.org/installer | php php 值得是php的liux下的安装目录 php环境变量 当装compser 的时候,出现 ...