
【新手必学】Python爬虫之多线程实战
1.先附上没有用多线程的包图网爬虫的代码
import requests
from lxml import etree
import os
import time start_time = time.time()#记录开始时间
for i in range(1,7):
#1.请求包图网拿到整体数据
response = requests.get("https://ibaotu.com/shipin/7-0-0-0-0-%s.html" %str(i)) #2.抽取 视频标题、视频链接
html = etree.HTML(response.text)
tit_list = html.xpath('//span[@class="video-title"]/text()')#获取视频标题
src_list = html.xpath('//div[@class="video-play"]/video/@src')#获取视频链接
for tit,src in zip(tit_list,src_list):
#3.下载视频
response = requests.get("http:" + src)
#给视频链接头加上http头,http快但是不一定安全,https安全但是慢 #4.保存视频
if os.path.exists("video1") == False:#判断是否有video这个文件夹
os.mkdir("video1")#没有的话创建video文件夹
fileName = "video1\\" + tit + ".mp4"#保存在video文件夹下,用自己的标题命名,文件格式是mp4
#有特殊字符的话需要用\来注释它,\是特殊字符所以这里要用2个\\
print("正在保存视频文件: " +fileName)#打印出来正在保存哪个文件
with open (fileName,"wb") as f:#将视频写入fileName命名的文件中
f.write(response.content)end_time = time.time()#记录结束时间
print("耗时%d秒"%(end_time-start_time))#输出用了多少时间
2.将上述代码套用多线程,先创建多线程
data_list = []#设置一个全局变量的列表

# 创建多线程

class MyThread(threading.Thread):

    def __init__(self, q):

        threading.Thread.__init__(self)

        self.q = q

    #调用get_index()

    def run(self) -> None:

        self.get_index()

    #拿到网址后获取所需要的数据并存入全局变量data_list中

    def get_index(self):

        url = self.q.get()

        try:

            resp = requests.get(url)# 访问网址

            # 将返回的数据转成lxml格式,之后使用xpath进行抓取

            html = etree.HTML(resp.content)

            tit_list = html.xpath('//span[@class="video-title"]/text()')  # 获取视频标题

            src_list = html.xpath('//div[@class="video-play"]/video/@src')  # 获取视频链接

            for tit, src in zip(tit_list, src_list):

                data_dict = {}#设置一个存放数据的字典

                data_dict['title'] = tit#往字典里添加视频标题

                data_dict['src'] = src#往字典里添加视频链接

                # print(data_dict)

                data_list.append(data_dict)#将这个字典添加到全局变量的列表中

        except Exception as e:

            # 如果访问超时就打印错误信息,并将该条url放入队列,防止出错的url没有爬取

            self.q.put(url)

            print(e)
3.用队列queue,queue模块主要是多线程,保证线程安全使用的
def main():

    # 创建队列存储url

    q = queue.Queue()

    for i in range(1,6):

        # 将url的参数进行编码后拼接到url

        url = 'https://ibaotu.com/shipin/7-0-0-0-0-%s.html'%str(i)

        # 将拼接好的url放入队列中

        q.put(url)

    # 如果队列不为空,就继续爬

    while not q.empty():

        # 创建3个线程

        ts = []

        for count in range(1,4):

            t = MyThread(q)

            ts.append(t)

        for t in ts:

            t.start()

        for t in ts:

            t.join()
4.创建存储方法,如果你学习遇到问题找不到人解答,可以点我进裙,里面大佬解决问题及Python教.程下载和一群上进的人一起交流!
#提取data_list的数据并保存

def save_index(data_list):

    if data_list:

        for i in data_list:

            # 下载视频

            response = requests.get("http:" + i['src'])

            # 给视频链接头加上http头,http快但是不安全,https安全但是慢

            # 保存视频

            if os.path.exists("video") == False:  # 判断是否有video这个文件夹

                os.mkdir("video")  # 没有的话创建video文件夹

            fileName = "video\\" + i['title'] + ".mp4"  # 保存在video文件夹下,用自己的标题命名,文件格式是mp4

            # 有特殊字符的话需要用\来注释它,\是特殊字符所以这里要用2个\\

            print("正在保存视频文件: " + fileName)  # 打印出来正在保存哪个文件

            with open(fileName, "wb") as f:  # 将视频写入fileName命名的文件中

                f.write(response.content)
5.最后就是调用函数了
if __name__ == '__main__':

    start_time = time.time()

    # 启动爬虫

    main()

    save_index(data_list)

    end_time = time.time()

    print("耗时%d"%(end_time-start_time))
6.附上完整的多线程代码
import requests

from lxml import etree

import os

import queue

import threading

import time

data_list = []#设置一个全局变量的列表

# 创建多线程

class MyThread(threading.Thread):

    def __init__(self, q):

        threading.Thread.__init__(self)

        self.q = q

    #调用get_index()

    def run(self) -> None:

        self.get_index()

    #拿到网址后获取所需要的数据并存入全局变量data_list中

    def get_index(self):

        url = self.q.get()

        try:

            resp = requests.get(url)# 访问网址

            # 将返回的数据转成lxml格式,之后使用xpath进行抓取

            html = etree.HTML(resp.content)

            tit_list = html.xpath('//span[@class="video-title"]/text()')  # 获取视频标题

            src_list = html.xpath('//div[@class="video-play"]/video/@src')  # 获取视频链接

            for tit, src in zip(tit_list, src_list):

                data_dict = {}#设置一个存放数据的字典

                data_dict['title'] = tit#往字典里添加视频标题

                data_dict['src'] = src#往字典里添加视频链接

                # print(data_dict)

                data_list.append(data_dict)#将这个字典添加到全局变量的列表中

        except Exception as e:

            # 如果访问超时就打印错误信息,并将该条url放入队列,防止出错的url没有爬取

            self.q.put(url)

            print(e)

def main():

    # 创建队列存储url

    q = queue.Queue()

    for i in range(1,7):

        # 将url的参数进行编码后拼接到url

        url = 'https://ibaotu.com/shipin/7-0-0-0-0-%s.html'%str(i)

        # 将拼接好的url放入队列中

        q.put(url)

    # 如果队列不为空,就继续爬

    while not q.empty():

        # 创建3个线程

        ts = []

        for count in range(1,4):

            t = MyThread(q)

            ts.append(t)

        for t in ts:

            t.start()

        for t in ts:

            t.join()

#提取data_list的数据并保存

def save_index(data_list):

    if data_list:

        for i in data_list:

            # 下载视频

            response = requests.get("http:" + i['src'])

            # 给视频链接头加上http头,http快但是不安全,https安全但是慢

            # 保存视频

            if os.path.exists("video") == False:  # 判断是否有video这个文件夹

                os.mkdir("video")  # 没有的话创建video文件夹

            fileName = "video\\" + i['title'] + ".mp4"  # 保存在video文件夹下,用自己的标题命名,文件格式是mp4

            # 有特殊字符的话需要用\来注释它,\是特殊字符所以这里要用2个\\

            print("正在保存视频文件: " + fileName)  # 打印出来正在保存哪个文件

            with open(fileName, "wb") as f:  # 将视频写入fileName命名的文件中

                f.write(response.content)

if __name__ == '__main__':

    start_time = time.time()

    # 启动爬虫

    main()

    save_index(data_list)

    end_time = time.time()

    print("耗时%d"%(end_time-start_time))
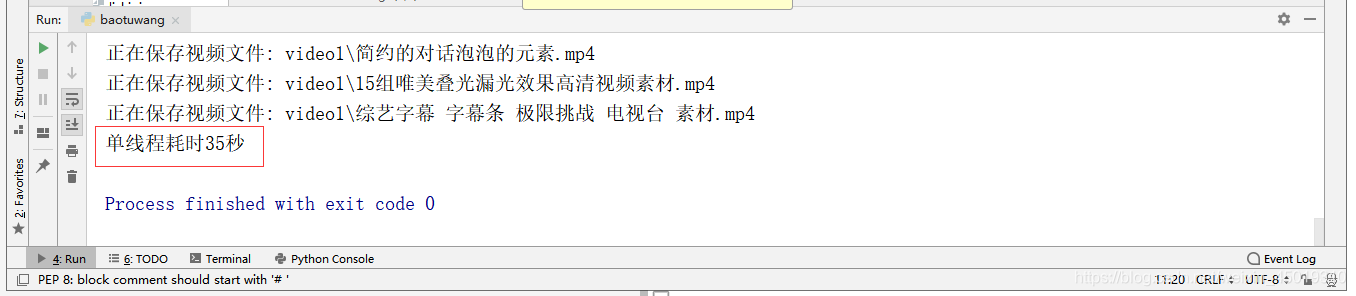
7.这2个爬虫我都设置了开始时间和结束时间,可以用(结束时间-开始时间)来计算比较两者的效率。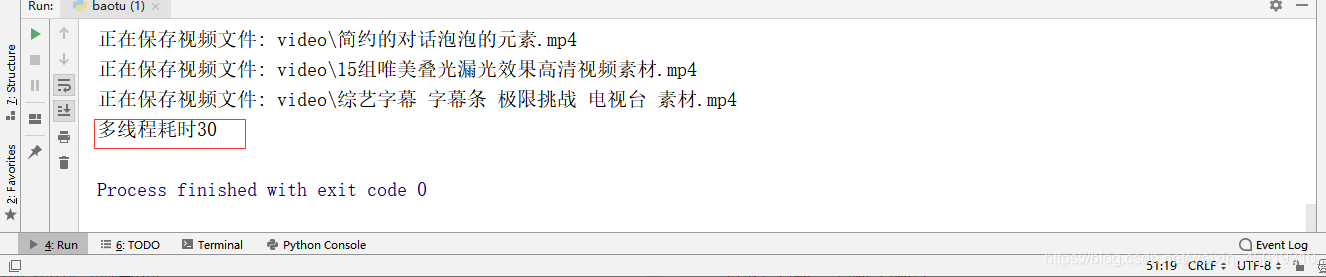
【新手必学】Python爬虫之多线程实战的更多相关文章
- Python爬虫工程师必学——App数据抓取实战 ✌✌
Python爬虫工程师必学——App数据抓取实战 (一个人学习或许会很枯燥,但是寻找更多志同道合的朋友一起,学习将会变得更加有意义✌✌) 爬虫分为几大方向,WEB网页数据抓取.APP数据抓取.软件系统 ...
- Python爬虫工程师必学APP数据抓取实战✍✍✍
Python爬虫工程师必学APP数据抓取实战 整个课程都看完了,这个课程的分享可以往下看,下面有链接,之前做java开发也做了一些年头,也分享下自己看这个视频的感受,单论单个知识点课程本身没问题,大 ...
- Python爬虫工程师必学——App数据抓取实战
Python爬虫工程师必学 App数据抓取实战 整个课程都看完了,这个课程的分享可以往下看,下面有链接,之前做java开发也做了一些年头,也分享下自己看这个视频的感受,单论单个知识点课程本身没问题,大 ...
- 小白学 Python 爬虫(16):urllib 实战之爬取妹子图
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(40):爬虫框架 Scrapy 入门基础(七)对接 Selenium 实战
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(41):爬虫框架 Scrapy 入门基础(八)对接 Splash 实战
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(23):解析库 pyquery 入门
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(4):前置准备(三)Docker基础入门
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(11):urllib 基础使用(一)
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
随机推荐
- Java把一个文件,输出成多个文件
前言:我有一个出租车轨迹的txt文本,其中包括多条轨迹.我想把这个文本按照单条轨迹输出出来,每条轨迹放在一个txt文本中. 思路:重要问题就集中在,如何动态的指定输出文件的名字.我想到了StringB ...
- linux系统LAMP环境部署
一.安装虚拟机 二.安装CentOS7 注意:以下安装,用的root权限. 三.安装Apache 1.安装 yum -y install httpd 2.开启apache服务 systemctl st ...
- 力扣(LeetCode)长按键入 个人题解
你的朋友正在使用键盘输入他的名字 name.偶尔,在键入字符 c 时,按键可能会被长按,而字符可能被输入 1 次或多次. 你将会检查键盘输入的字符 typed.如果它对应的可能是你的朋友的名字(其中一 ...
- Linux系统时间\硬件时间(date、tzselect、clock、hwclock、ntpdate)
1.系统时间和硬件时间 在Linux中有硬件时钟与系统时钟两种时钟.硬件时钟是指主机板上的时钟设备,也就是通常可在BIOS画面设定的时钟.系统时钟则是指kernel中的时钟.所有Linux相关指令与函 ...
- Pashmak and Graph(dp + 贪心)
题目链接:http://codeforces.com/contest/459/problem/E 题意:给一个带权有向图, 找出其中最长上升路的长度. 题解:先按权值对所有边排序, 然后依次 u -& ...
- 隐藏input输入框的增减按钮
当input 使用了type='number'后,会出现这个增减数值的按钮,如上所示, 解决办法: 1.type='text' ,改为输入字符串,缺点是要做类型转换,而且移动端不会调出纯数字键盘 2. ...
- c++中实现单例模式singleton class
本文首发于个人博客https://kezunlin.me/post/8932eaec/,欢迎阅读! singleton class and usage in c++. Guide what singl ...
- 用图解&&实例讲解php是如何实现websocket实时消息推送的
WebSocket是 HTML5 开始提供的一种在单个 TCP 连接上进行全双工通讯的协议. 以前的推送技术使用 Ajax 轮询,浏览器需要不断地向服务器发送http请求来获取最新的数据,浪费很多的带 ...
- Python 编程语言要掌握的技能之一:使用数字与字符串的技巧
最佳实践 1. 少写数字字面量 “数字字面量(integer literal)” 是指那些直接出现在代码里的数字.它们分布在代码里的各个角落,比如代码 del users[0] 里的 0 就是一个数字 ...
- C#变量---xdd
cshape(c#)学习笔记 1. string str1=Console.ReadLine();//键盘输入的默认为字符串 2. Console.WriteLine('你的成绩是'+a+'分'); ...